Documentation des figures
La fiche technique de chacune des 116 figures de la bibliothèque : ce qu’elle montre, comment la lancer étape par étape, la méthode statistique et les packages R qui la calculent, les données qu’elle attend et son prix.
Décrire les données12 figures
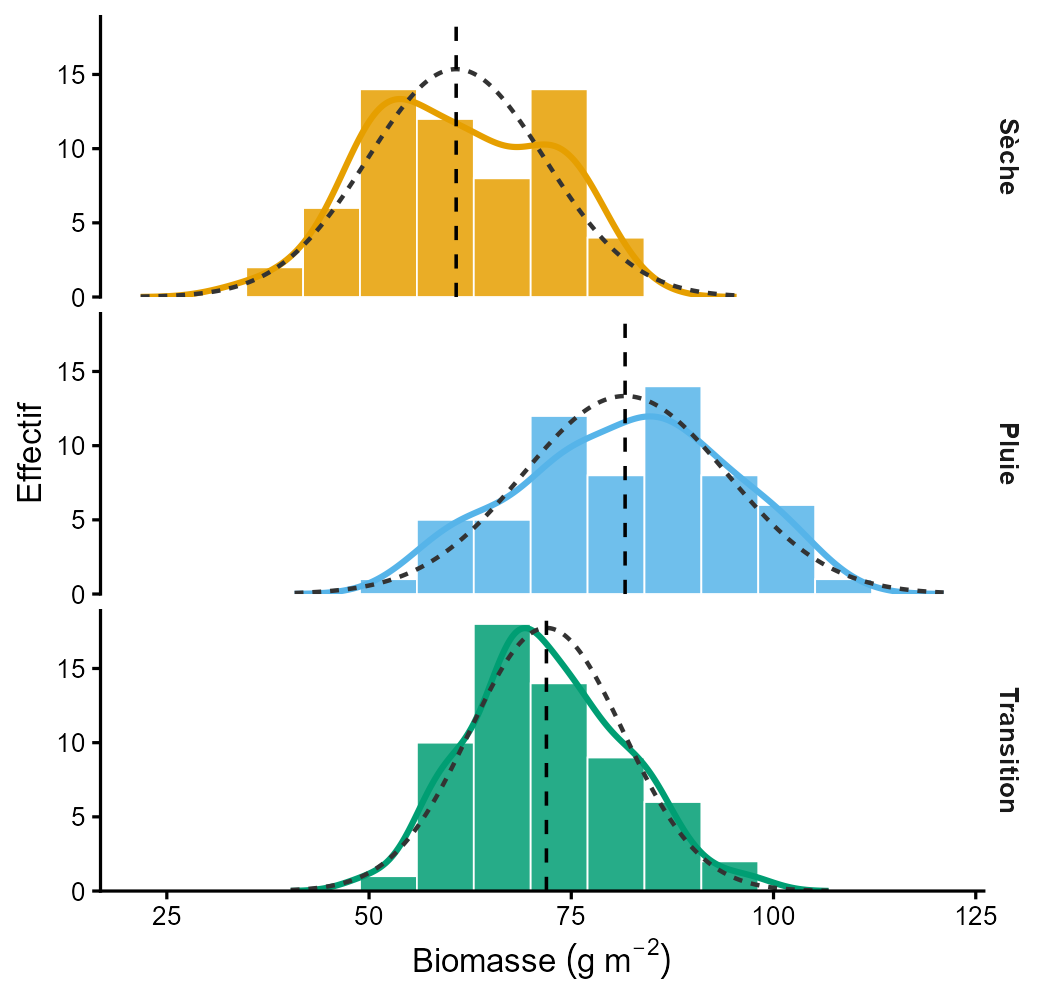
Histogramme et densité
La forme d’une mesure en barres d’effectifs, avec sa courbe de densité, la loi normale de même moyenne en pointillés et la moyenne : asymétrie, modes et valeurs extrêmes d’un coup d’œil.
Distributions · 5 crédits
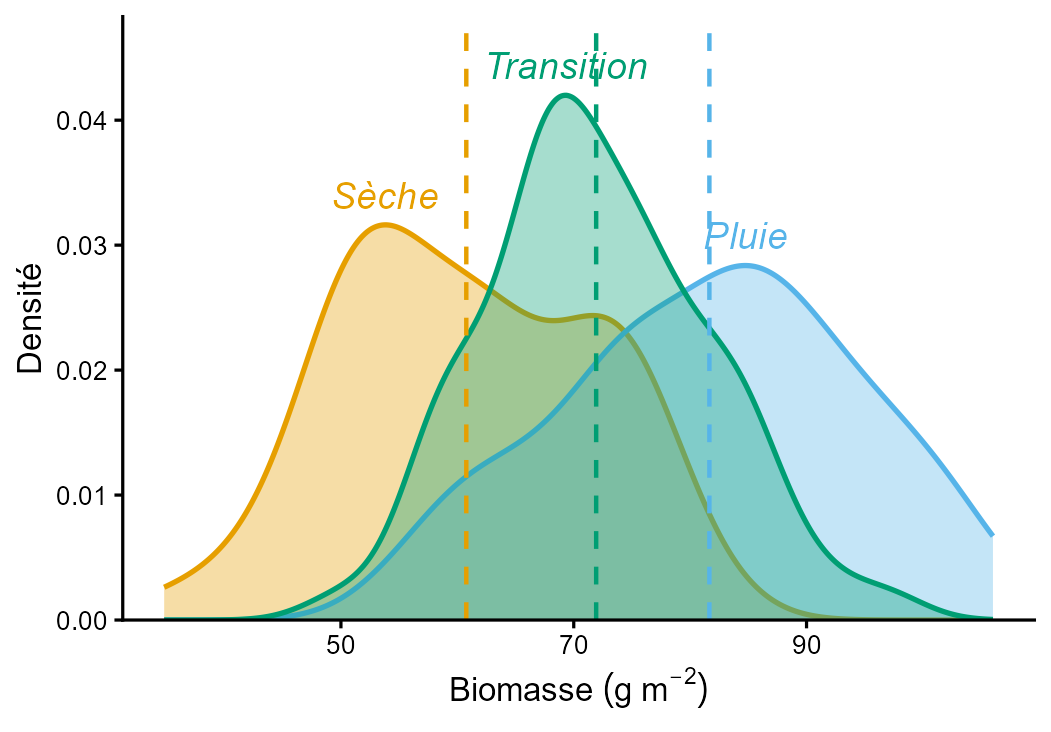
Densités + moyennes
Les courbes de densité de plusieurs groupes superposées, la moyenne de chacun en tirets et son nom sur la courbe : pour comparer la forme et la position de quelques groupes.
Distributions · 5 crédits
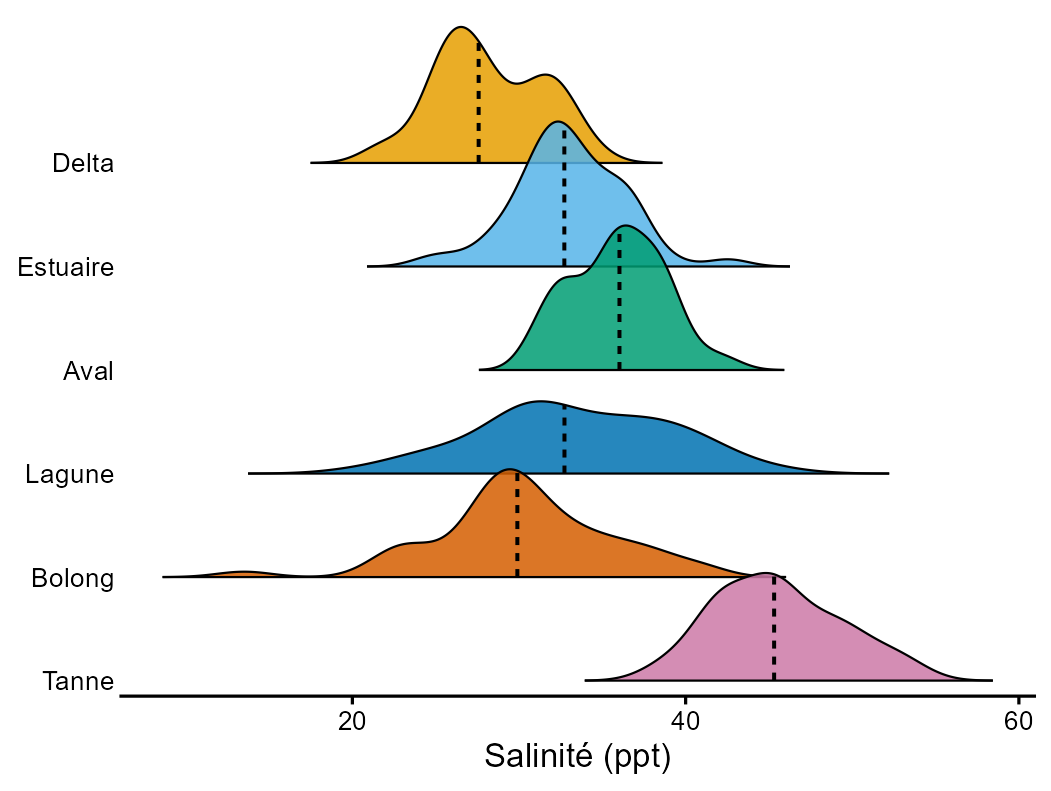
Ridgeline
Une crête par groupe, légèrement superposées : la forme de nombreuses distributions d’un coup d’œil, du premier groupe en haut au dernier en bas.
Distributions · 5 crédits
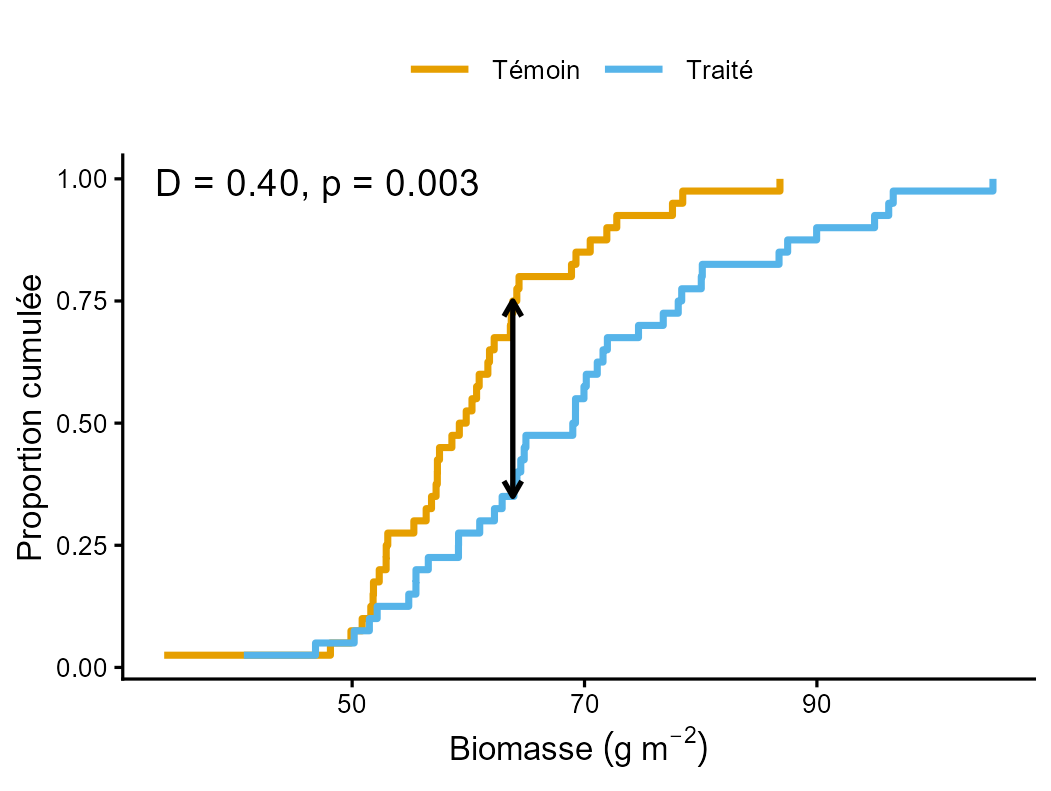
ECDF + Kolmogorov-Smirnov
La fonction de répartition de chaque groupe, en escalier : le plus grand écart vertical entre deux courbes est la statistique D du test de Kolmogorov-Smirnov, qui compare les distributions entières.
Distributions · 5 crédits
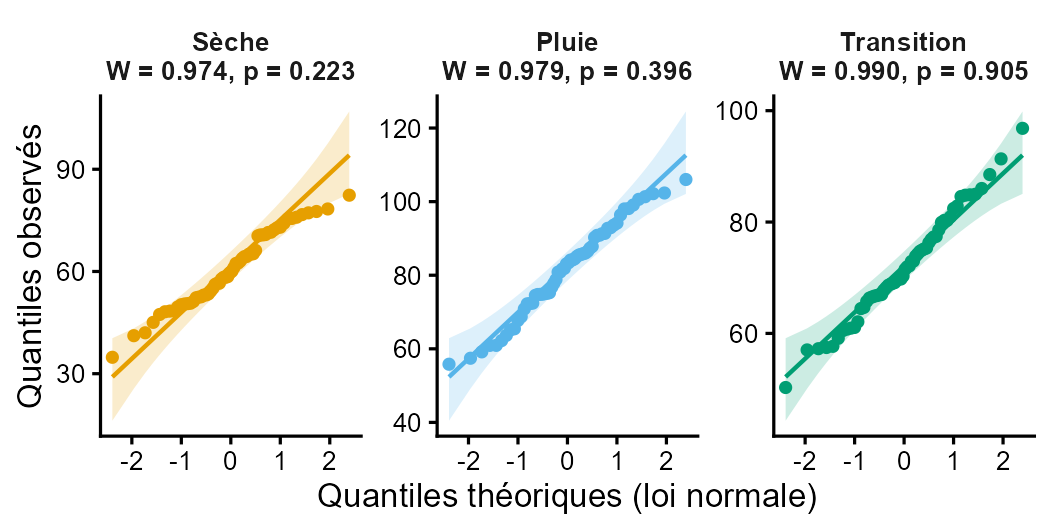
QQ-plot par groupe
Les quantiles observés de chaque groupe contre ceux d’une loi normale, avec l’enveloppe à 95 % et le test de Shapiro-Wilk : les points qui sortent de l’enveloppe s’écartent de la normalité.
Distributions · 5 crédits
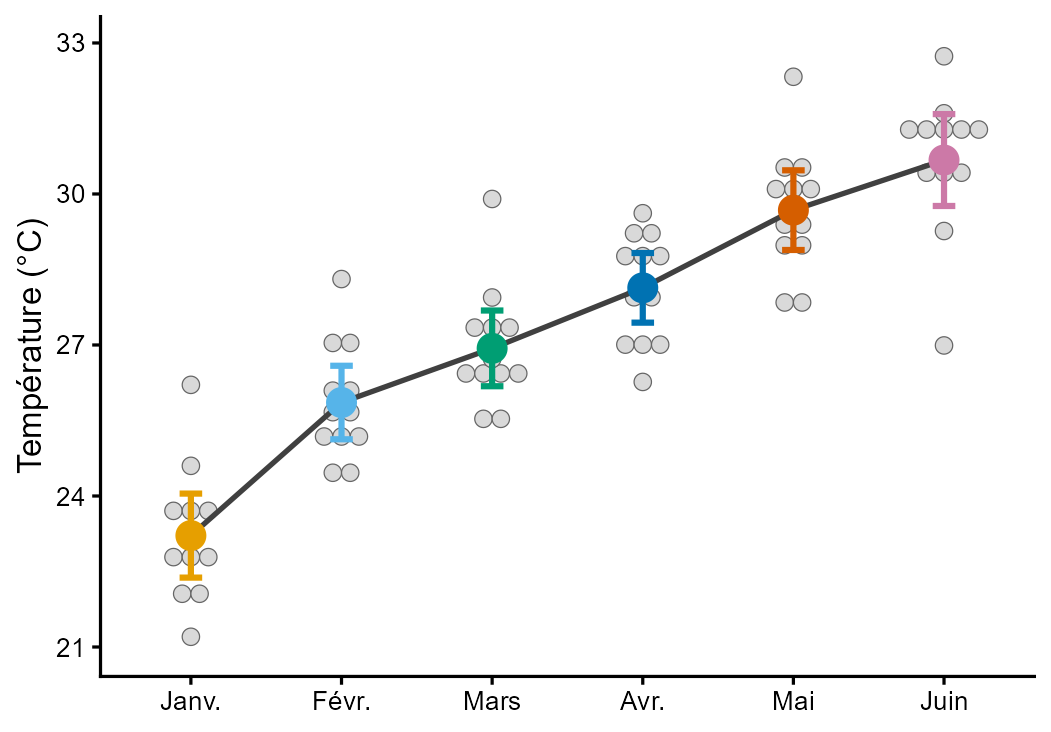
Points + moyennes reliées
Chaque mesure empilée en points, la moyenne de chaque groupe avec son intervalle et la ligne qui relie les moyennes : toutes les observations restent visibles.
Distributions · 5 crédits
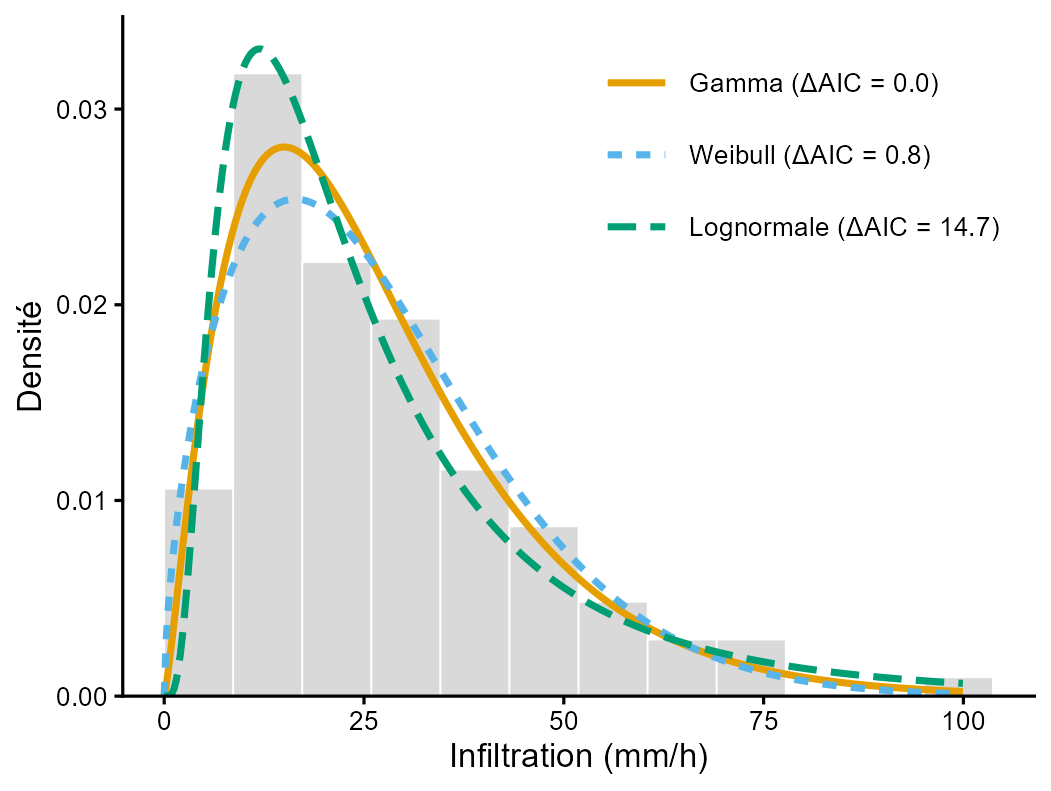
Lois ajustées + AIC
L’histogramme de chaque variable et les lois de sa nature ajustées par maximum de vraisemblance, classées par AIC (ou BIC) : la meilleure en trait plein.
Loi des données et transformation · 5 crédits
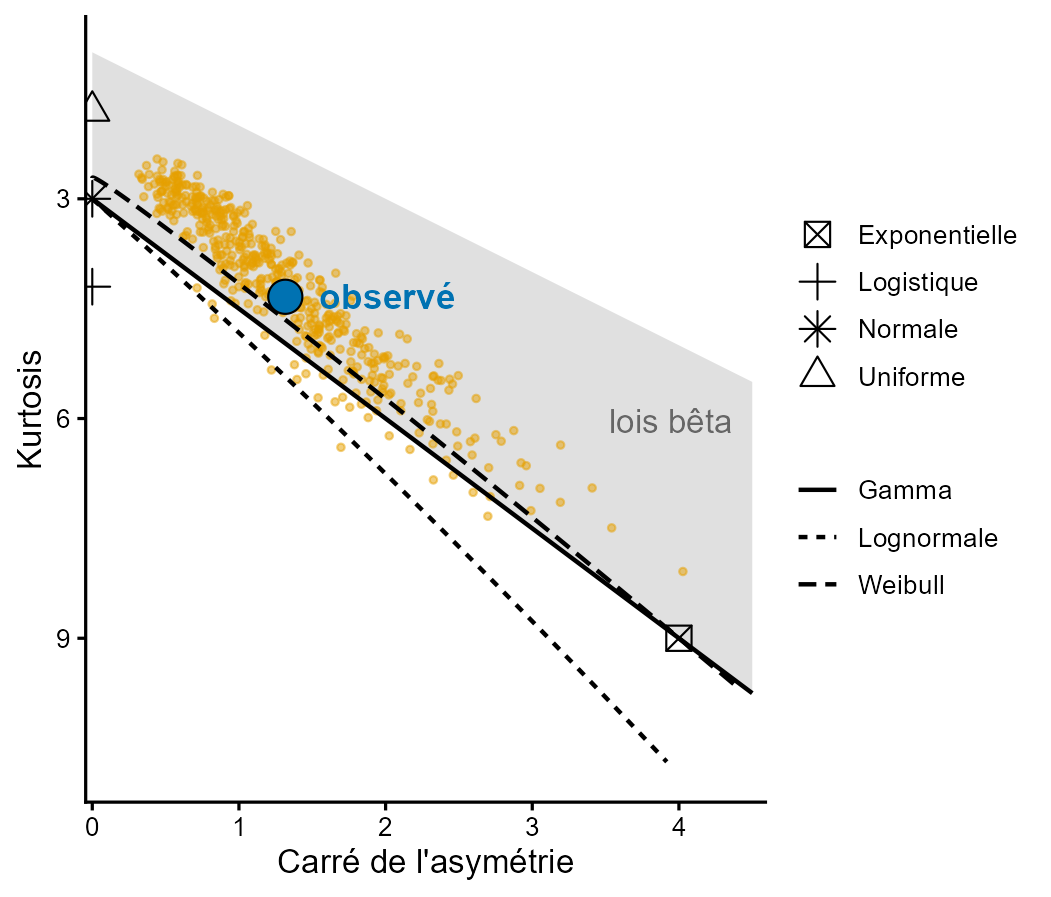
Plan de Cullen et Frey
Le plan de Cullen et Frey : l’asymétrie² et la kurtosis de chaque variable placées parmi celles des lois usuelles, avec, sur demande, un nuage bootstrap qui montre leur incertitude.
Loi des données et transformation · 5 crédits
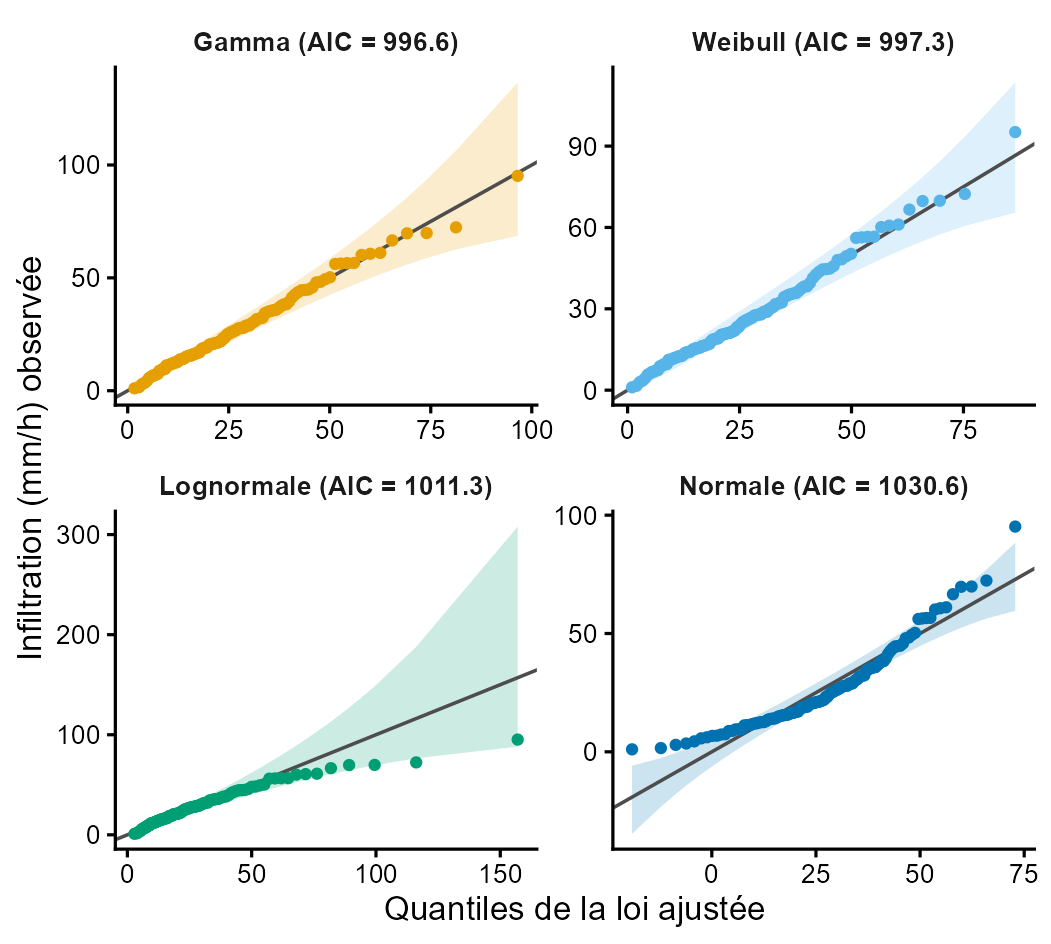
QQ-plot de quatre lois
Les quantiles observés contre ceux de quatre lois ajustées, avec l’enveloppe à 95 % : la loi qui convient suit la diagonale.
Loi des données et transformation · 5 crédits
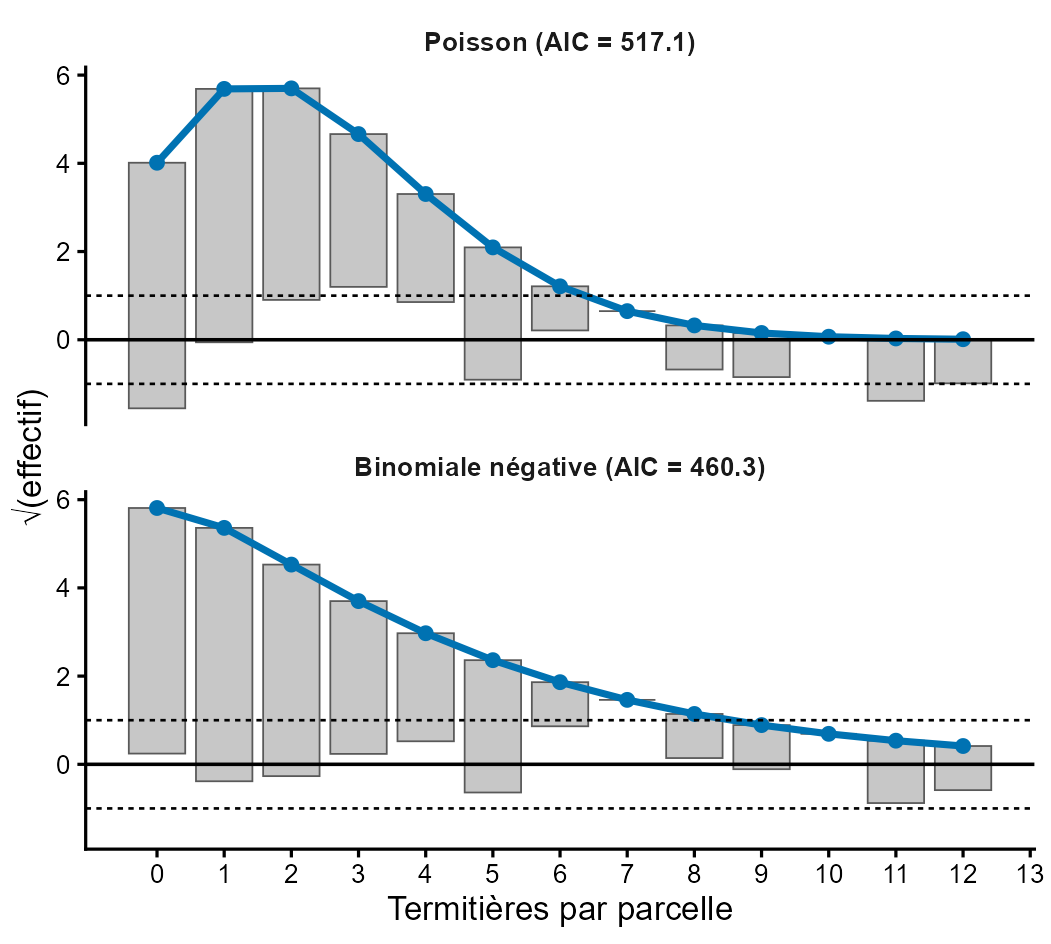
Rootogramme Poisson / binomiale négative
Pour des comptages : les effectifs observés de chaque valeur face à ceux qu’attendent une loi de Poisson et une binomiale négative, en racine carrée : on voit d’où vient la surdispersion.
Loi des données et transformation · 5 crédits
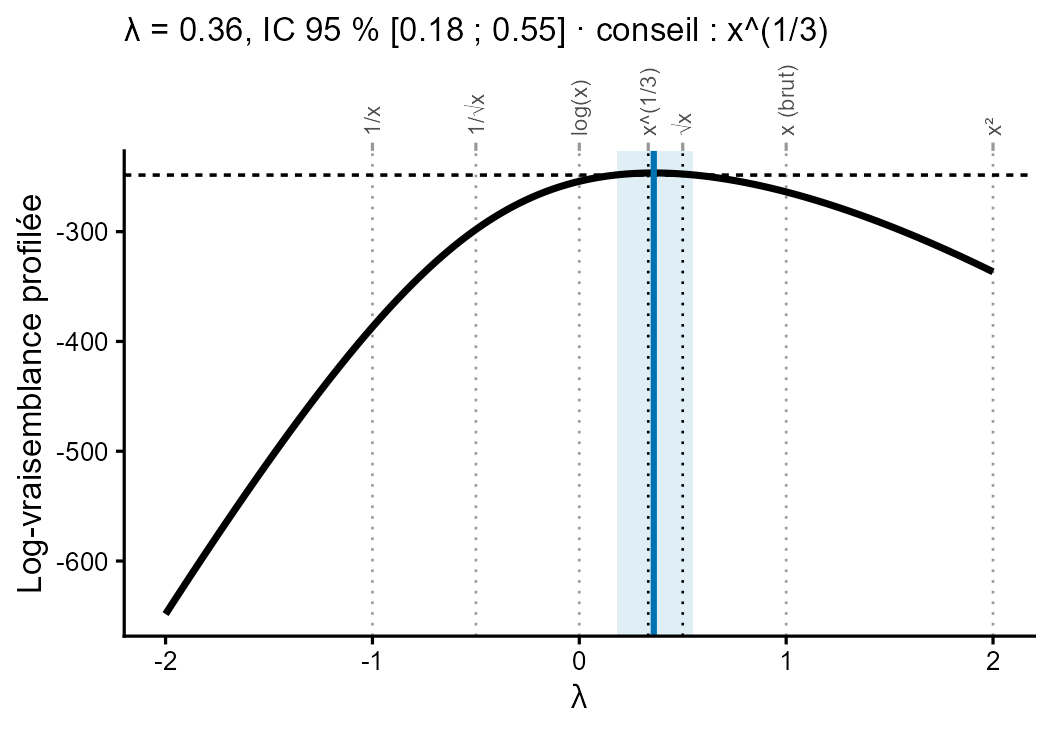
Profil de Box-Cox
Chaque variable avant et après la transformation conseillée (Box-Cox avec son λ, log, logit…), avec la loi normale de référence, l’asymétrie et le test de Shapiro-Wilk.
Loi des données et transformation · 5 crédits
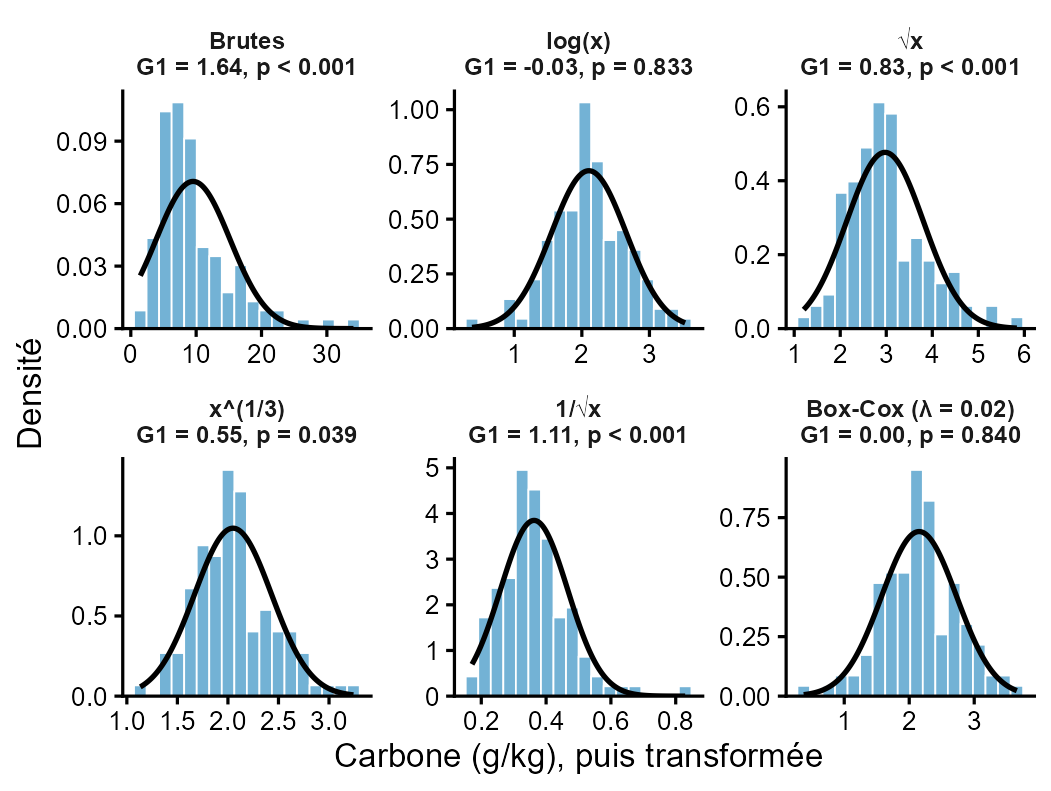
Transformations comparées
Les valeurs brutes puis transformées de plusieurs façons (log, racines, logit, Box-Cox, Yeo-Johnson…), côte à côte avec l’asymétrie et le test de Shapiro-Wilk de chacune.
Loi des données et transformation · 5 crédits
Comparaison de groupes25 figures
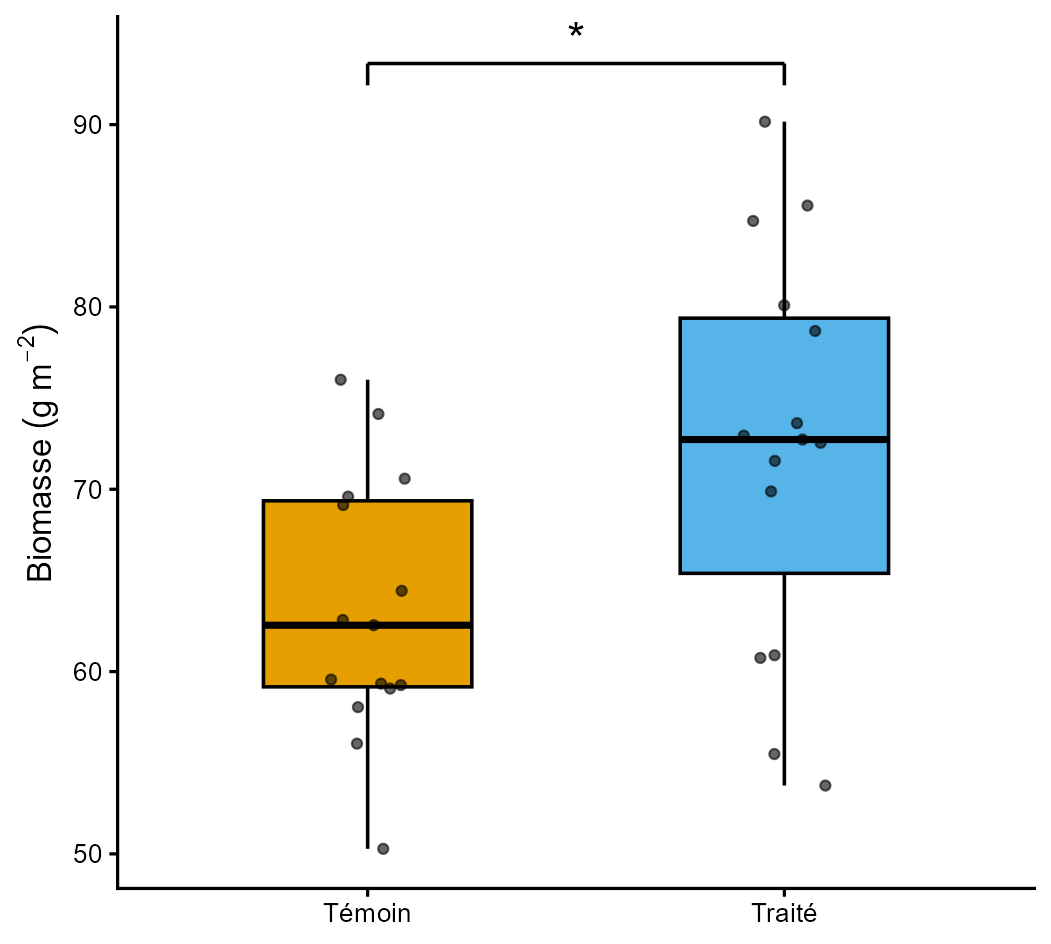
Deux groupes + étoiles
Deux groupes en boîtes à moustaches et le résultat du test (t de Welch, de Student ou Mann-Whitney) en étoiles au-dessus.
Test t / Mann-Whitney · 5 crédits
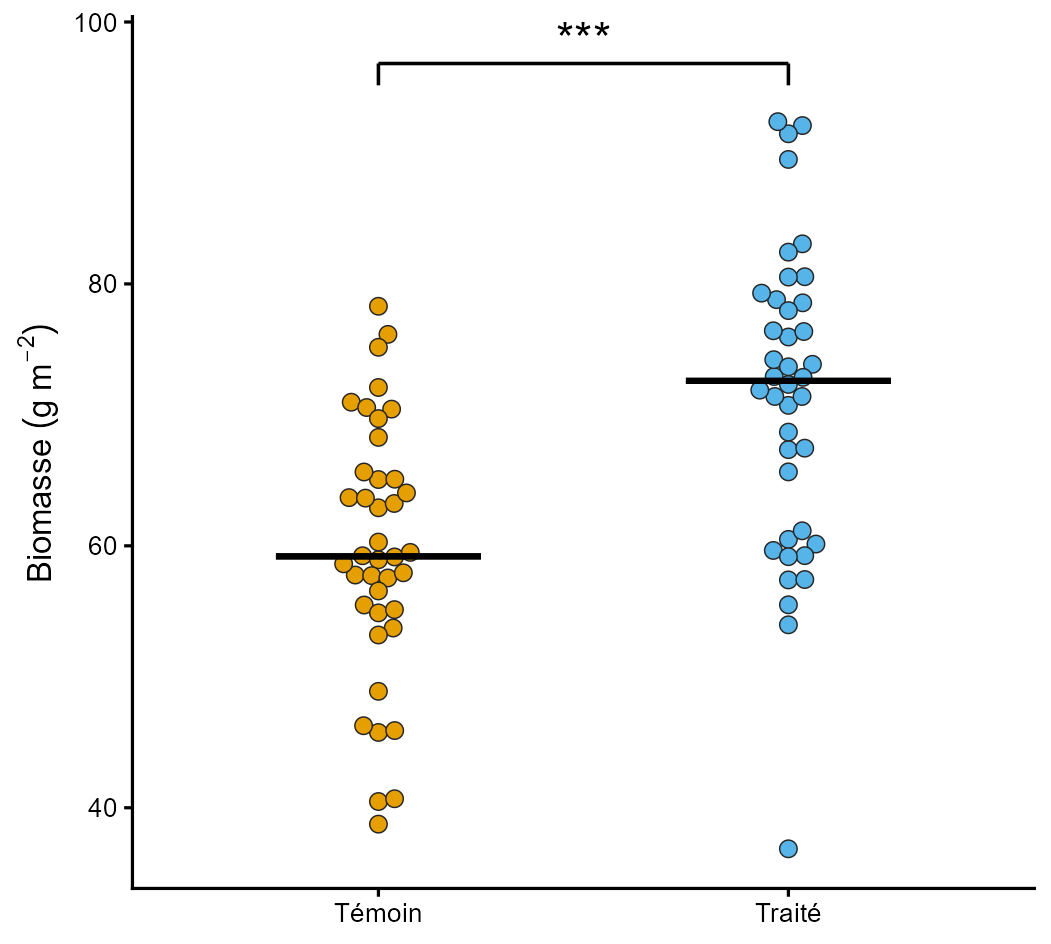
Essaim de points + étoiles
Toutes les observations des deux groupes, côte à côte sans se chevaucher, la médiane de chaque groupe et le résultat du test en étoiles : idéal pour de petits effectifs.
Test t / Mann-Whitney · 5 crédits
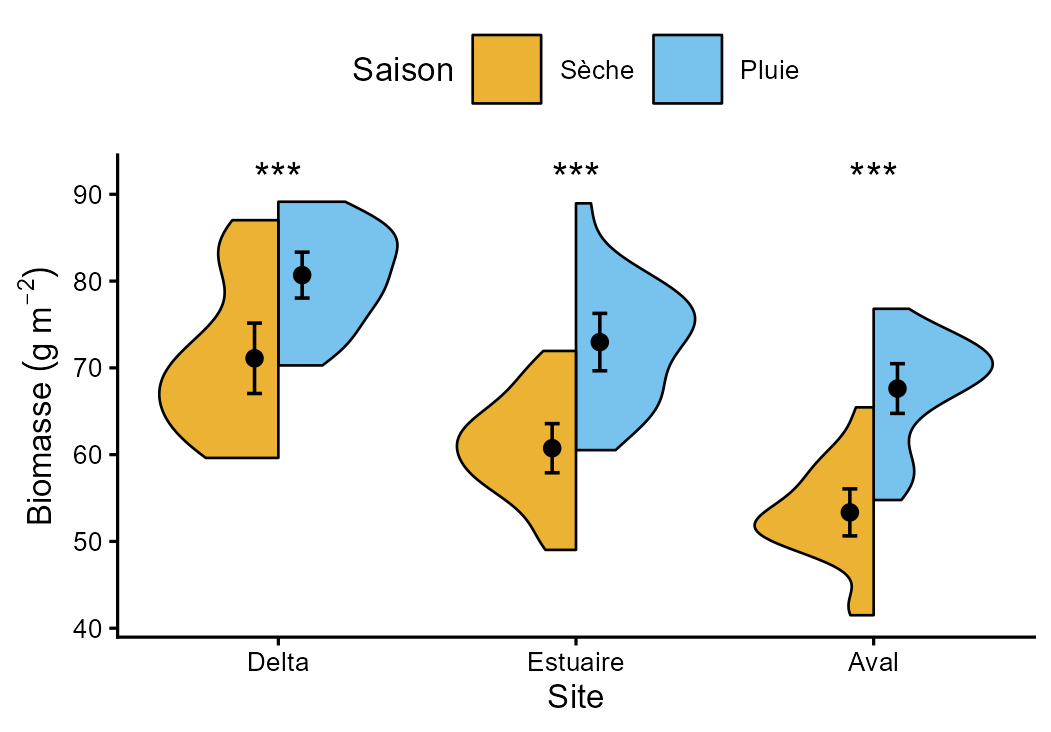
Violons scindés
Les deux groupes face à face dans un même violon, une moitié chacun, avec leur moyenne et leur intervalle : la différence de forme se lit de part et d’autre de l’axe.
Test t / Mann-Whitney · 5 crédits
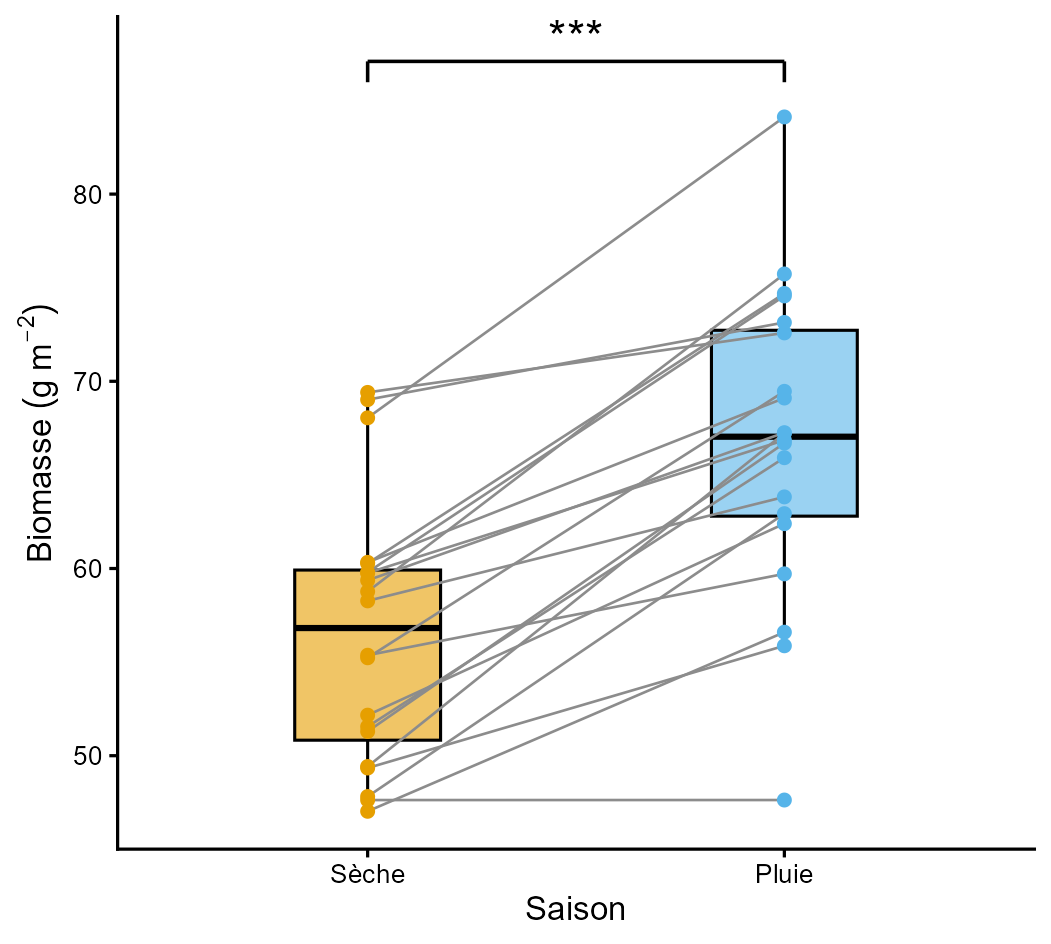
Mesures appariées reliées
Les mêmes unités mesurées deux fois (avant / après, deux saisons) : une ligne relie les deux mesures de chacune, on voit qui monte et qui descend ; le test porte sur les différences.
Test t / Mann-Whitney · 5 crédits
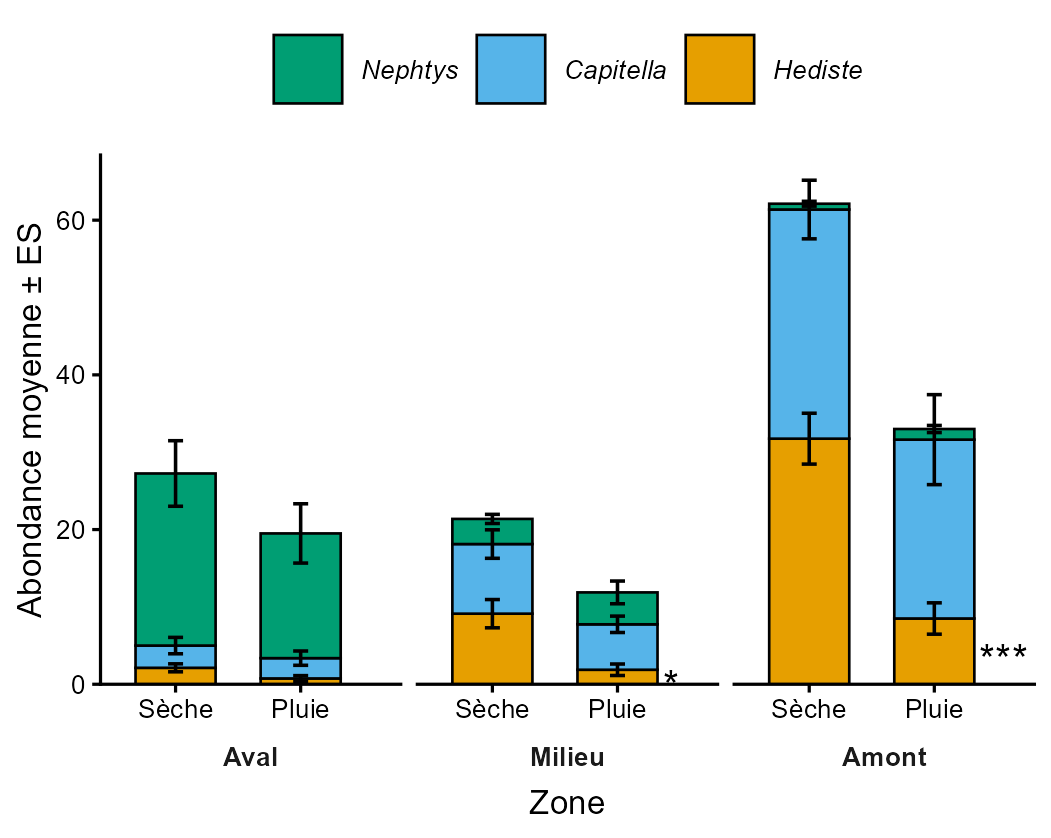
Barres empilées côte à côte
Les parts d’un même total (espèces, fractions d’une biomasse) empilées en barres, les deux groupes côte à côte ; une étoile marque chaque partie qui change entre eux.
Test t / Mann-Whitney · 5 crédits
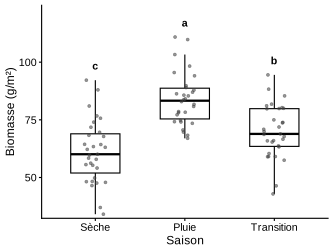
Boîtes à moustaches + lettres
Une boîte à moustaches par groupe et les lettres du test post-hoc après l’ANOVA à un facteur : deux groupes qui partagent une lettre ne diffèrent pas significativement.
ANOVA à un facteur · 5 crédits
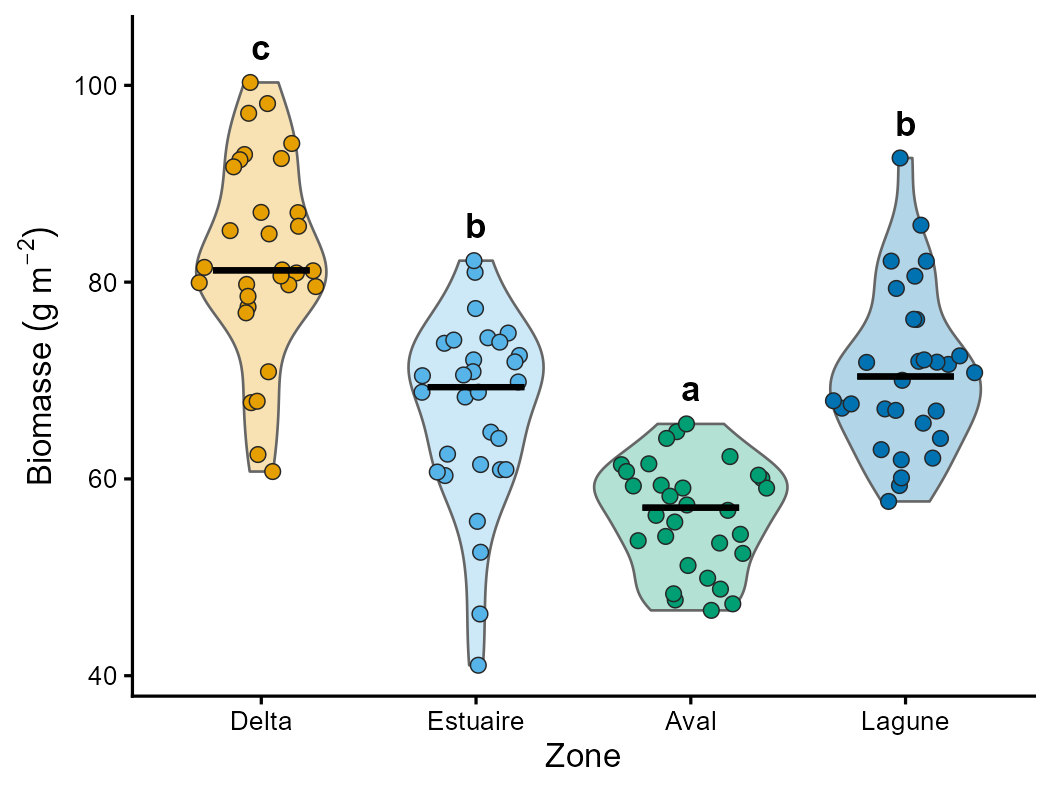
Sina + lettres
Chaque observation étalée selon la densité des valeurs de son groupe, la médiane et les lettres de Tukey après l’ANOVA à un facteur : la forme et les points à la fois.
ANOVA à un facteur · 5 crédits
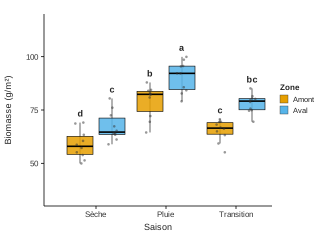
Boîtes groupées + lettres
Deux facteurs croisés (zone × saison) : une boîte par combinaison, colorée par le second facteur, et les lettres des comparaisons après l’ANOVA à deux facteurs avec interaction.
ANOVA à deux facteurs · 5 crédits
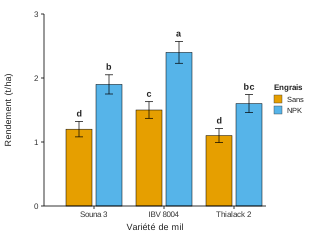
Barres ± erreur standard
La moyenne de chaque combinaison de deux facteurs en barres, ± erreur standard, et les lettres de significativité après l’ANOVA à deux facteurs.
ANOVA à deux facteurs · 5 crédits
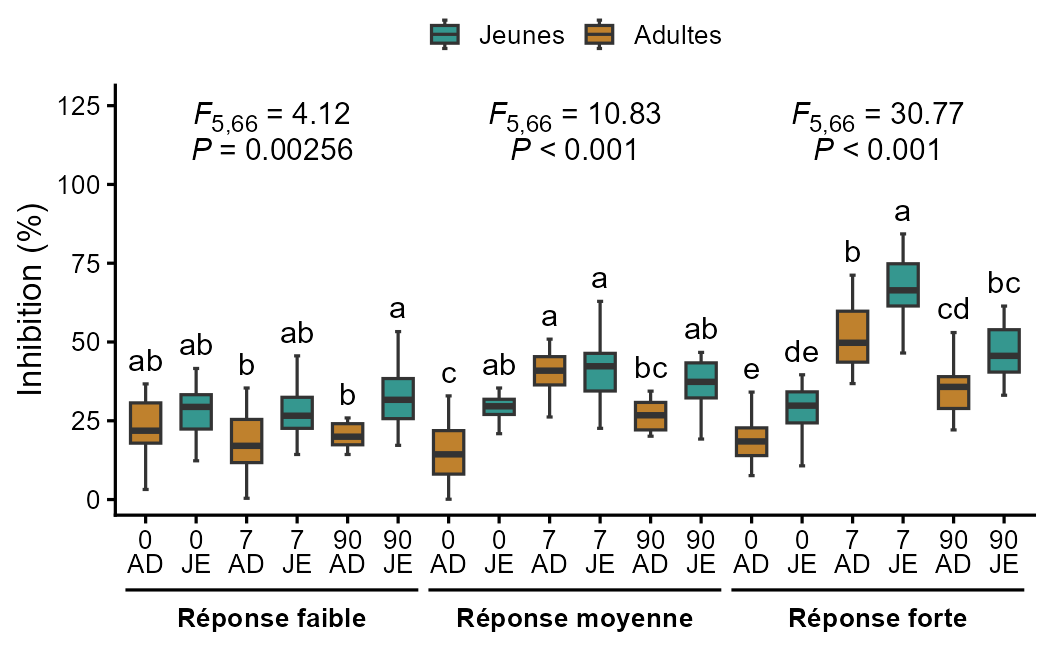
Boîtes par bloc : F, P et lettres
Des boîtes à moustaches réunies en blocs sous des crochets de l’axe ; dans chaque bloc, une ANOVA à un facteur avec son F (degrés de liberté en indice) et son P écrits au-dessus, et les lettres du test de Tukey sur chaque boîte, comme la figure de Nature Microbiology (2025).
ANOVA par bloc : F, P et lettres · 5 crédits
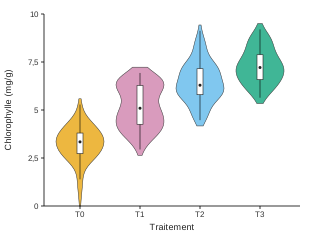
Diagramme en violon
La forme de la distribution de chaque groupe (deux modes, asymétrie) que la boîte ne montre pas, avec les lettres du test de Dunn après Kruskal-Wallis.
Kruskal-Wallis · 5 crédits
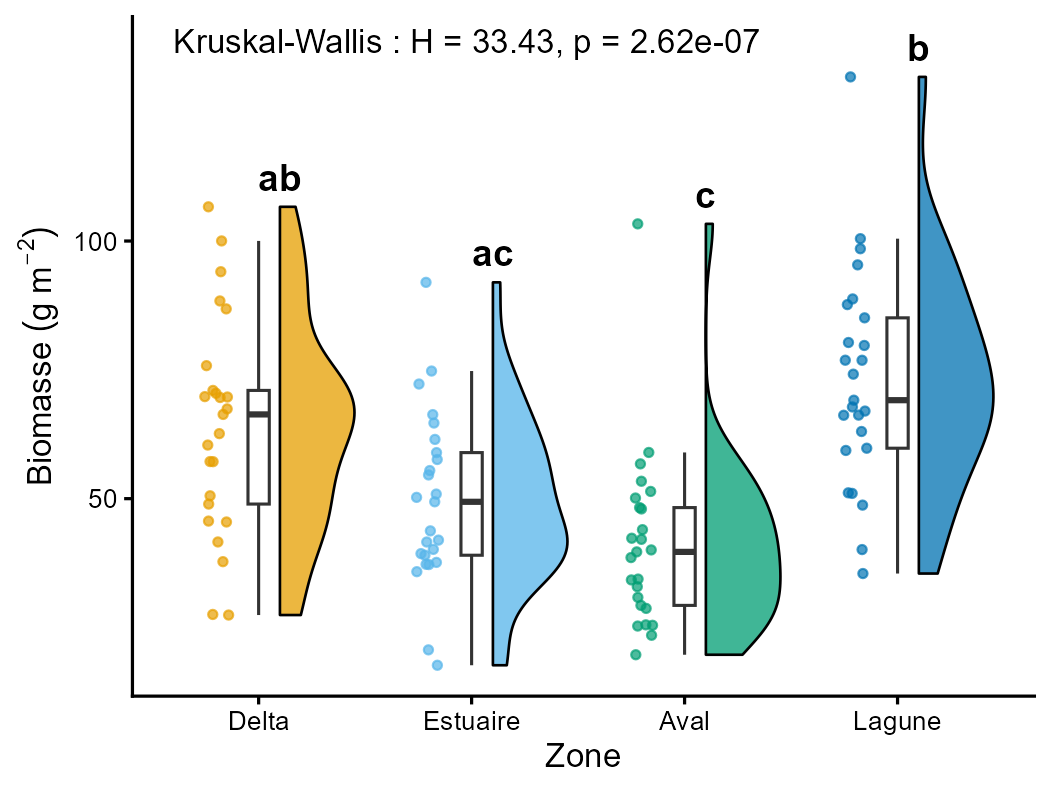
Raincloud + lettres
Pour chaque groupe un nuage de densité, une boîte et les observations, puis les lettres du test de Dunn après Kruskal-Wallis : forme, résumé et données sur une même ligne.
Kruskal-Wallis · 5 crédits
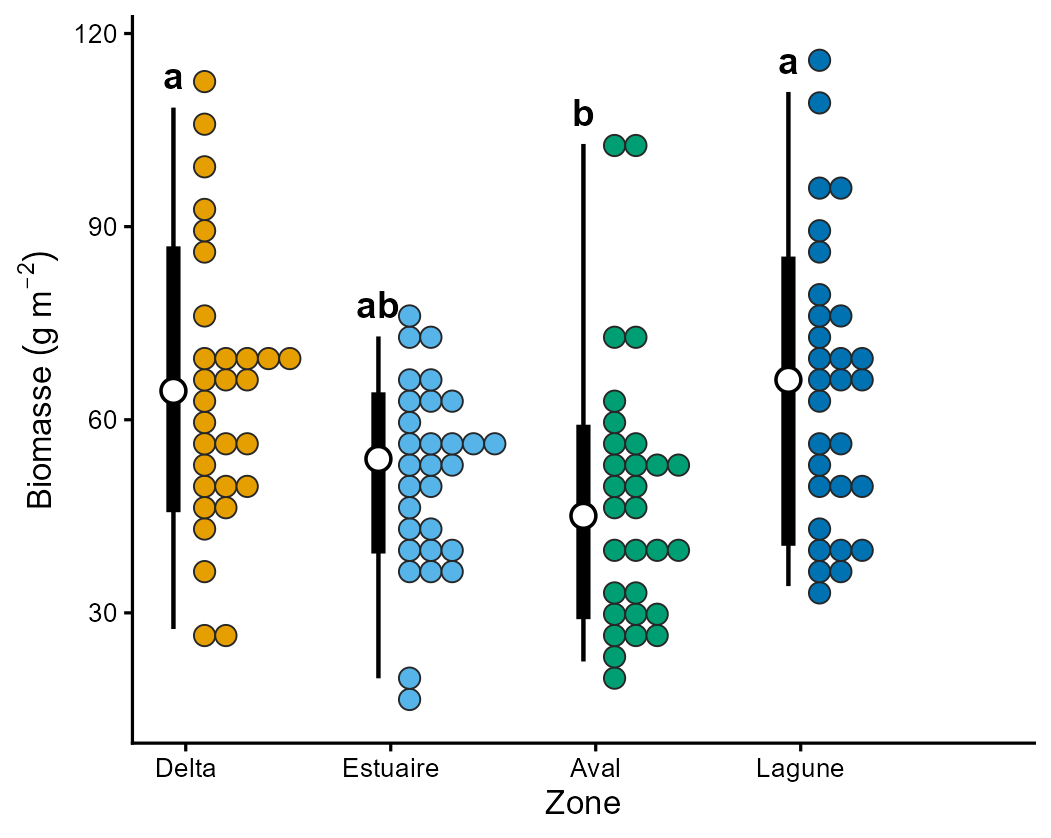
Points empilés + intervalles
Chaque observation empilée par classe de valeurs, la médiane et les 66 % et 95 % centraux de chaque groupe, avec les lettres de Dunn : une alternative sobre à la boîte.
Kruskal-Wallis · 5 crédits
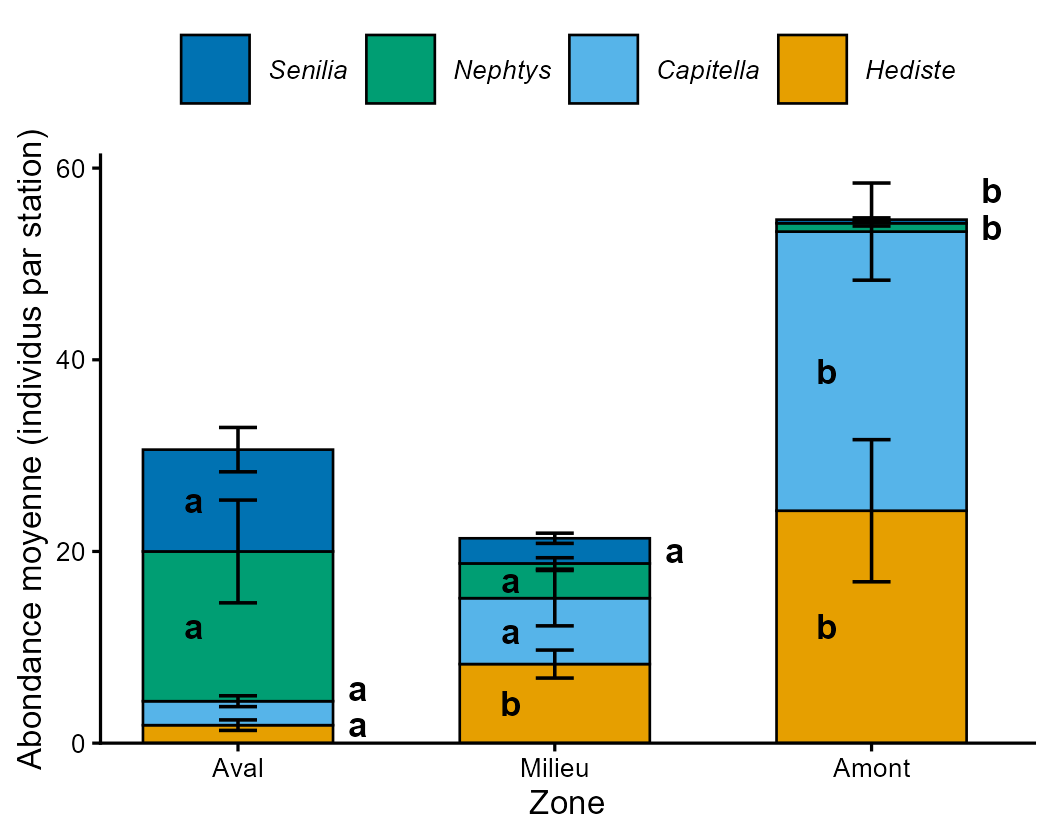
Barres empilées ± ES + lettres
La moyenne de chaque partie d’un total (espèce, genre) empilée par groupe, ± erreur standard, avec les lettres de Dunn de chaque partie dans son segment.
Kruskal-Wallis · 5 crédits
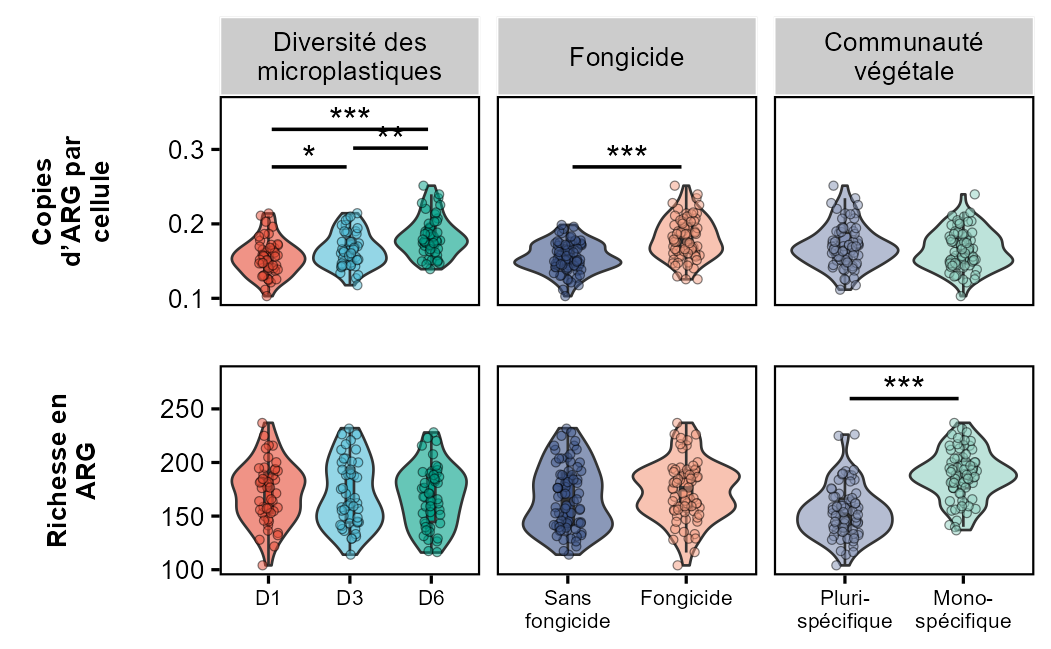
Grille de violons, mesures × facteurs
Chaque mesure en ligne, chaque facteur en colonne : violons, boîtes et points de chaque niveau, et dans chaque case les tests deux à deux ajustés en crochets étoilés.
Comparaisons en grille (Wilcoxon) · 5 crédits
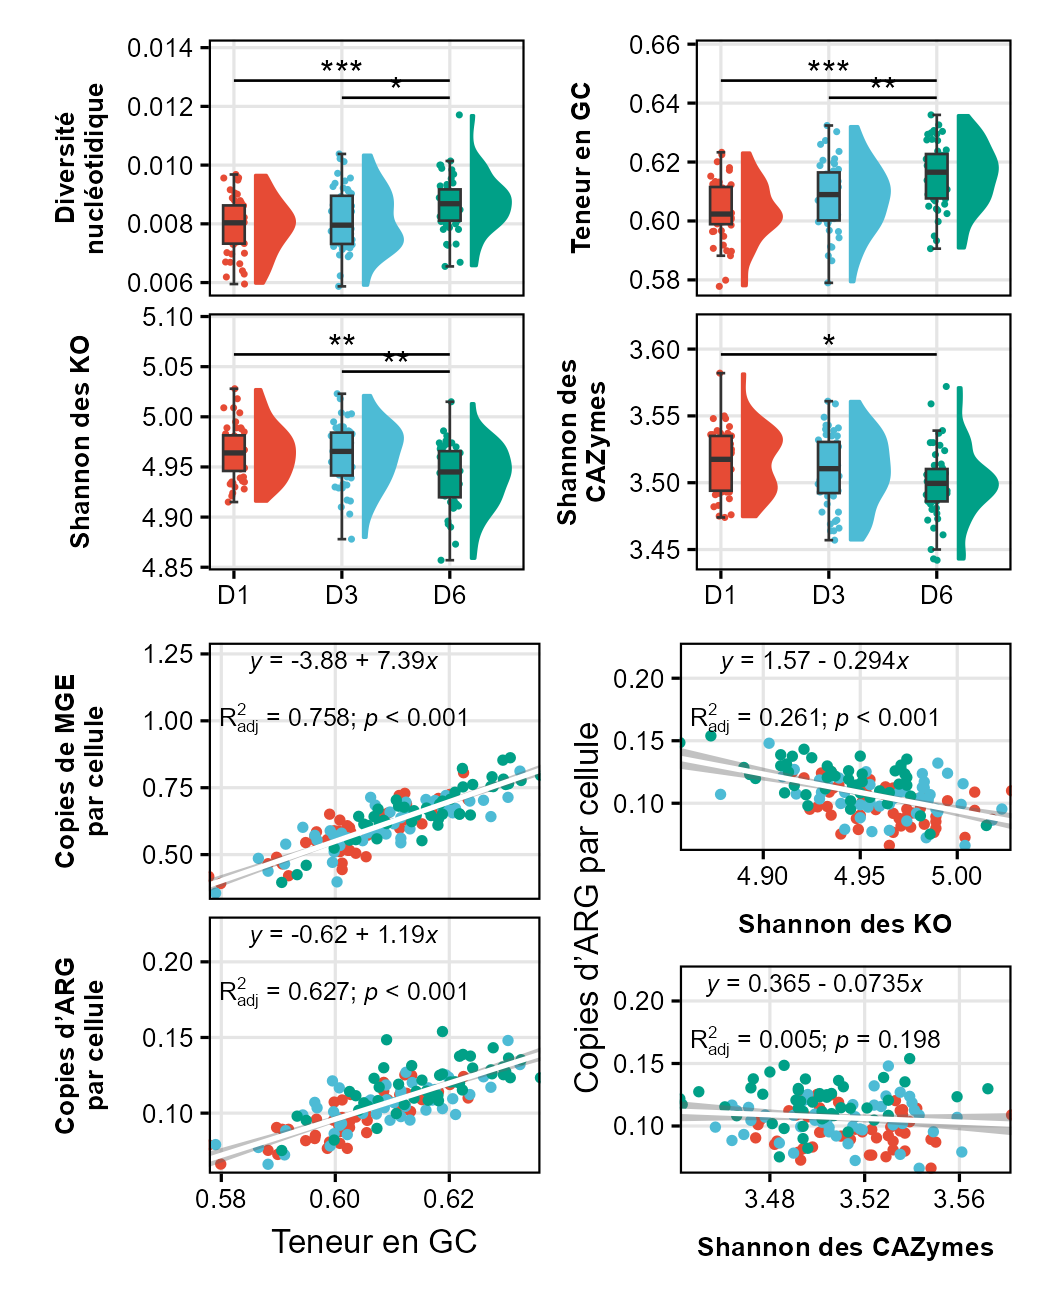
Raincloud + nuages de points et droites
En haut, les mesures comparées entre les niveaux d’un facteur en raincloud avec les crochets des tests ; en bas, chaque mesure en nuage de points contre une variable numérique, avec la droite, son intervalle, l’équation, le R² et p.
Comparaisons en grille (Wilcoxon) · 5 crédits
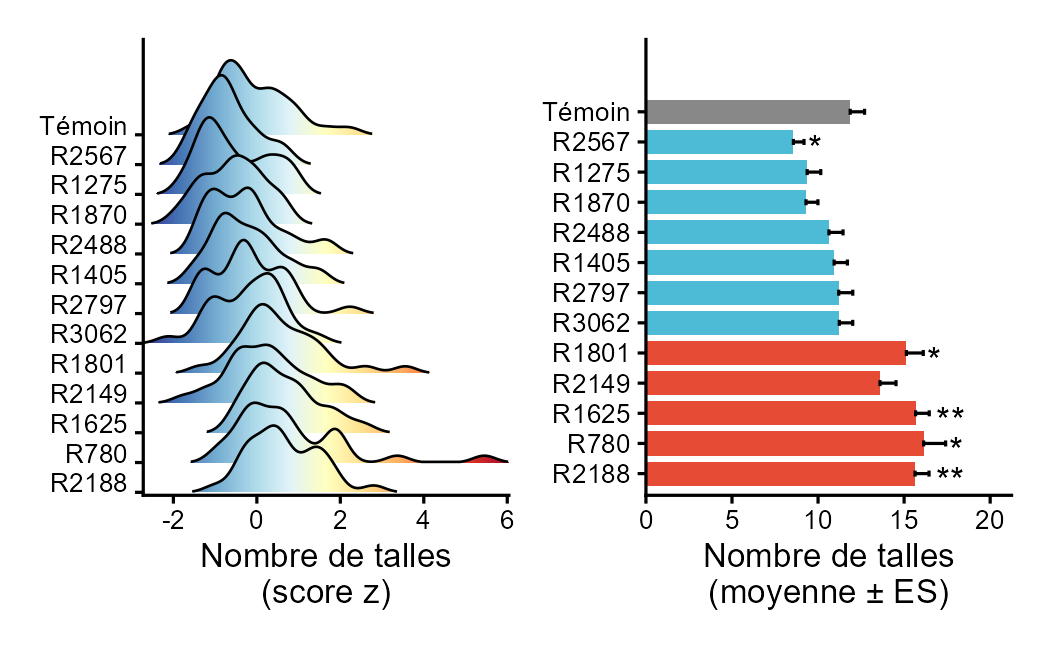
Crêtes en dégradé + barres contre un témoin
La distribution de chaque niveau en crête colorée selon la valeur, le témoin en haut ; à côté, la moyenne ± erreur standard de chacun, colorée selon qu’elle dépasse le témoin, avec les étoiles du test contre le témoin.
Comparaisons en grille (Wilcoxon) · 5 crédits
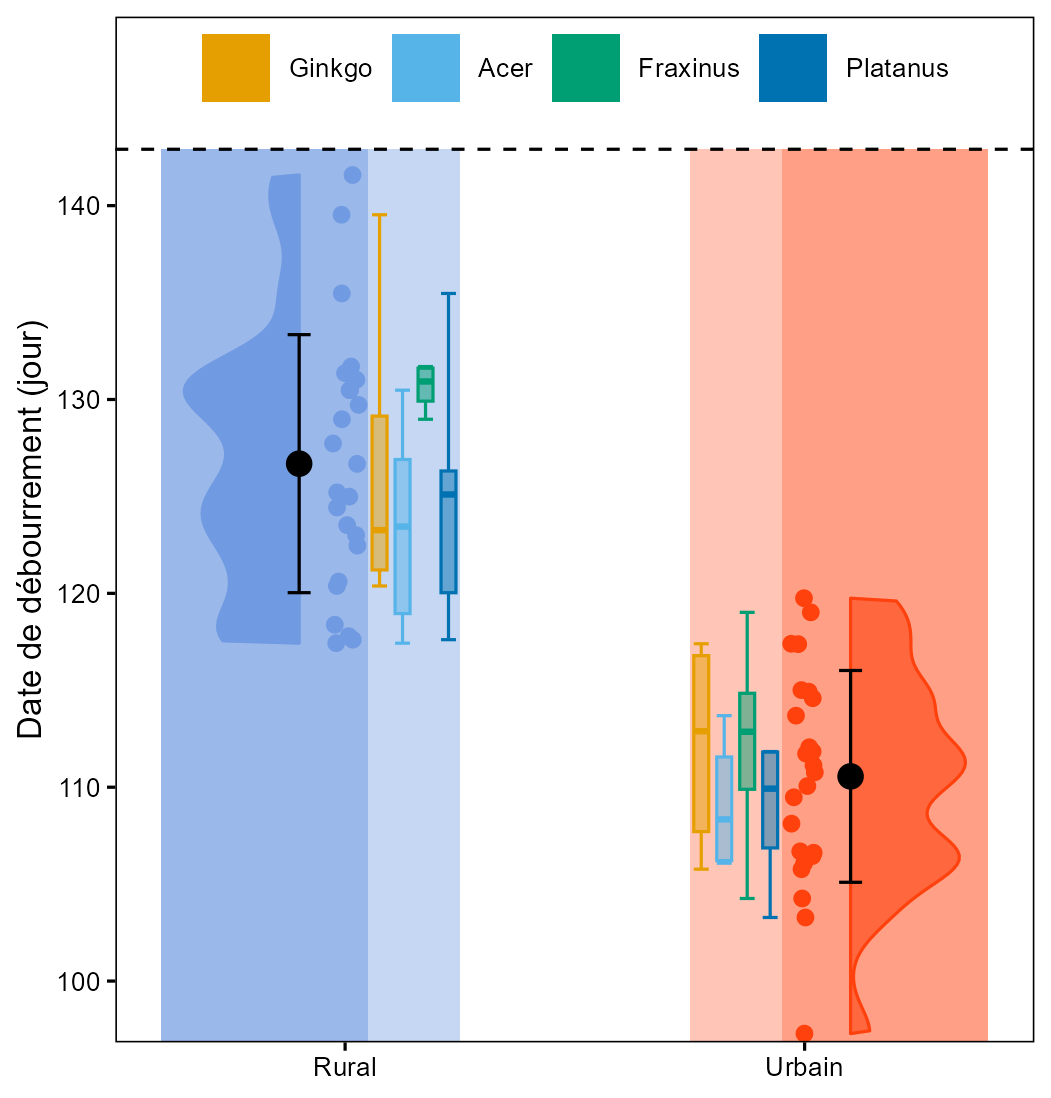
Demi-violons opposés + boîtes par espèce
Les niveaux d’un facteur face à face : chacun son demi-violon tourné vers l’extérieur, sa moyenne ± écart type, ses points et, de l’autre côté, une boîte par sous-groupe.
Comparaisons en grille (Wilcoxon) · 5 crédits
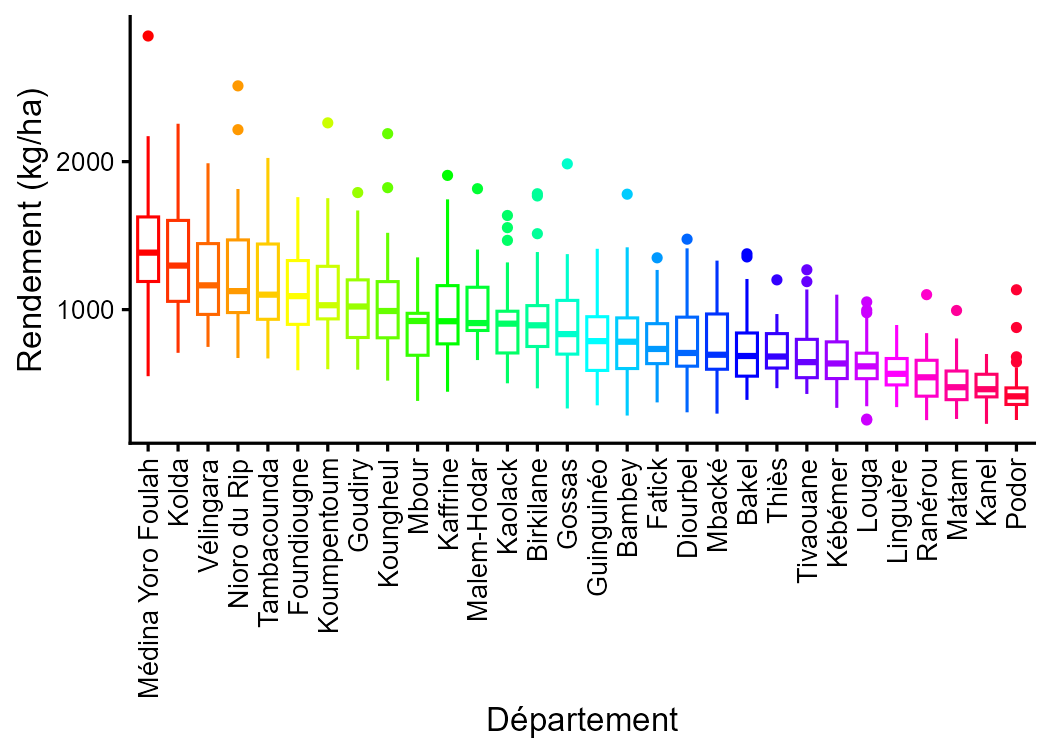
Boîtes triées par médiane
Une boîte à moustaches par groupe, de la plus haute médiane à la plus basse, chaque boîte de sa couleur le long du classement et sans légende : les noms des groupes se couchent, s’inclinent ou se redressent pour ne jamais se chevaucher. Le test de Kruskal-Wallis peut s’écrire au-dessus.
Boîtes triées par médiane · 5 crédits
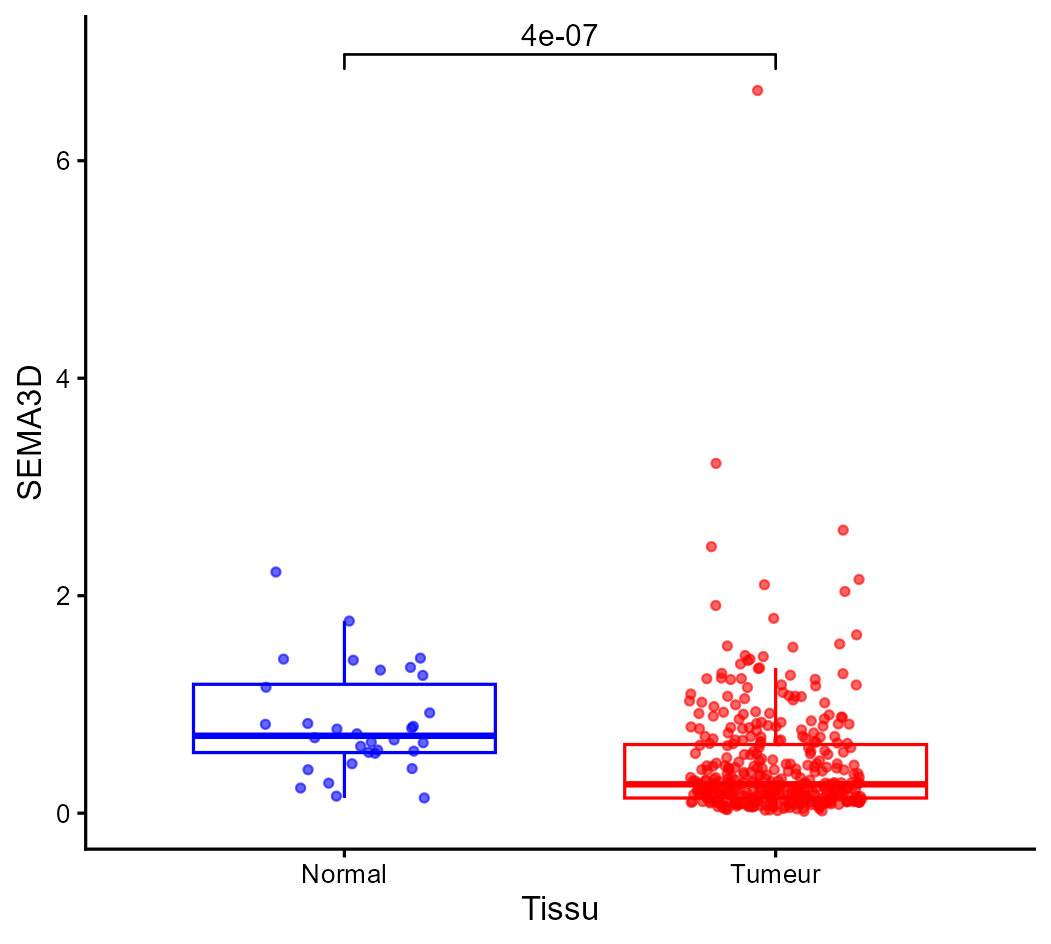
Boîtes et comparaisons deux à deux
Une boîte à moustaches par groupe aux contours colorés, ses points dispersés et, au-dessus, un crochet par paire de groupes avec sa p (test de Wilcoxon), comme ggpubr et stat_compare_means. Les crochets s’étagent pour que ni eux ni leurs p ne se chevauchent ; la figure s’allonge avec eux.
Boîtes et comparaisons deux à deux · 5 crédits
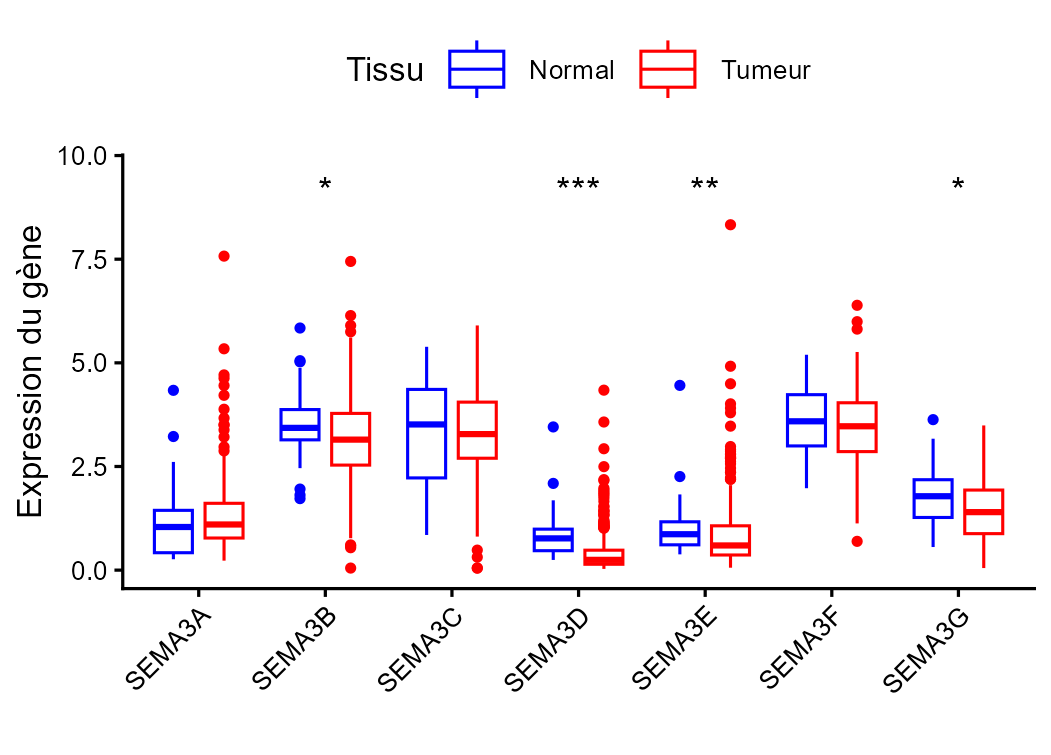
Boîtes groupées par variable
Plusieurs variables côte à côte, chacune en boîtes aux contours colorés par groupe, et au-dessus de chaque variable les étoiles de son test (Wilcoxon par défaut), comme ggpubr et stat_compare_means. Les noms des variables se couchent, s’inclinent ou se redressent selon la largeur ; les étoiles rapetissent et les p se redressent plutôt que de se toucher.
Boîtes groupées par variable · 5 crédits
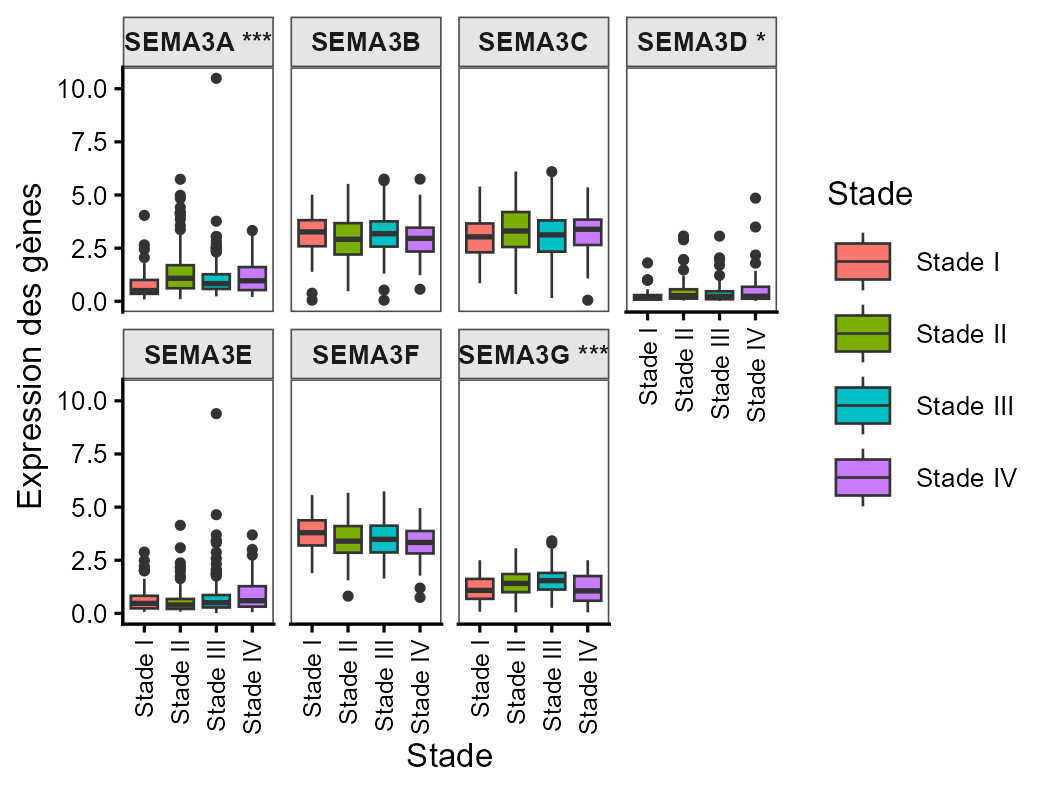
Boîtes en panneaux par variable
Un panneau par variable, une boîte remplie de la couleur de chaque groupe dans chacun, et les étoiles du test de la variable (Kruskal-Wallis ou Wilcoxon) dans le titre du panneau, comme facet_wrap et theme_bw. Les panneaux se rangent sur autant de lignes qu’il faut ; titres et noms des groupes rétrécissent, se coupent ou se redressent plutôt que de se toucher.
Boîtes en panneaux par variable · 5 crédits
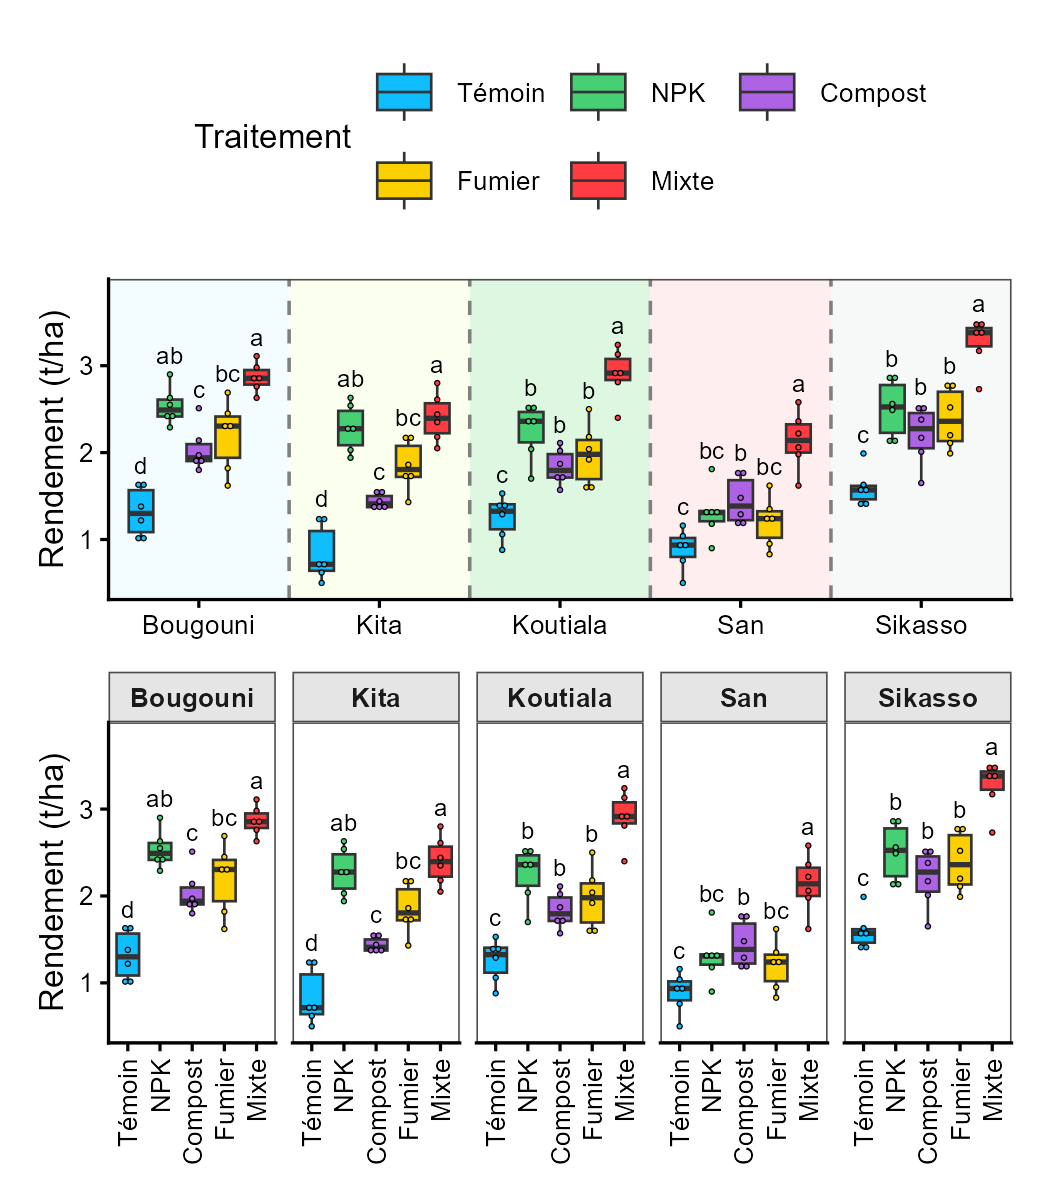
Boîtes groupées en bandes et panneaux
Dans chaque groupe, les boîtes des sous-groupes côte à côte sur une bande de couleur, séparées par des tirets, leurs points empilés ; en dessous, les mêmes boîtes, un panneau par groupe. Au-dessus de chaque boîte, sa lettre (a, b, c : même lettre, pas de différence) ou ses étoiles, au choix entre l’ANOVA et Tukey, Kruskal-Wallis et Dunn, le t de Welch ou Wilcoxon. Lettres, noms et titres se couchent, se redressent ou rétrécissent plutôt que de se toucher.
Boîtes groupées en bandes et panneaux · 5 crédits
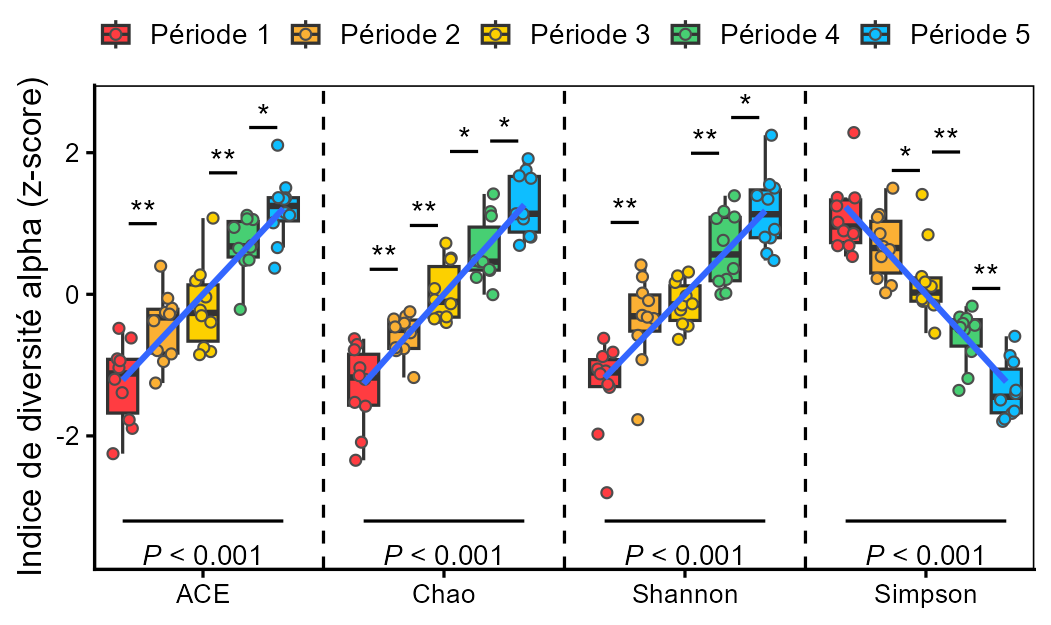
Boîtes et tendance par indice
Plusieurs indices côte à côte (centrés-réduits pour tenir sur un axe), une boîte par groupe ordonné dans chacun avec ses points, un trait étoilé entre les groupes successifs qui diffèrent (Wilcoxon), et la droite de chaque indice avec la p de sa pente écrite dessous (ggpmisc), comme le script. Les traits se posent juste au-dessus des boîtes sans se toucher, les p rétrécissent ou se redressent, la légende n’entre dans le panneau que si un coin est libre.
Boîtes et tendance par indice · 5 crédits
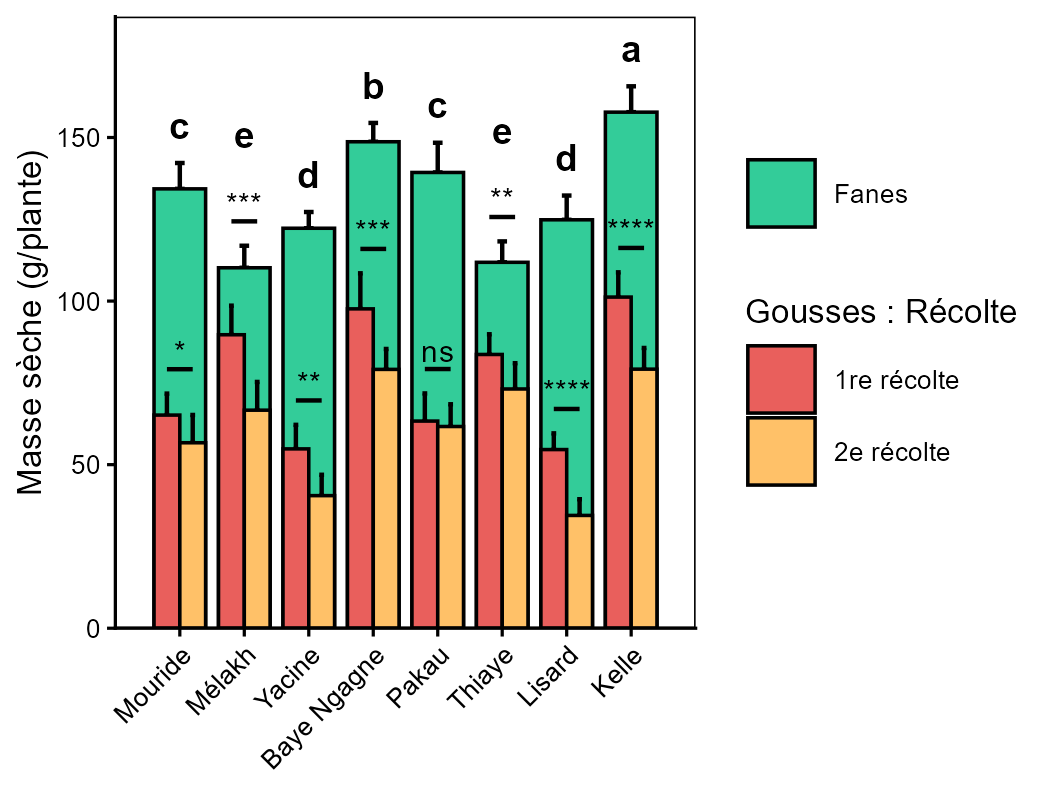
Barres imbriquées : lettres et étoiles
Une barre large par groupe pour une première mesure (moyenne ± écart-type) avec ses lettres (ANOVA puis LSD de Fisher corrigé par Bonferroni, agricolae) ; dedans, une barre par période pour une seconde mesure, les périodes de chaque groupe comparées par Wilcoxon (rstatix, p ajustées par Holm) et reliées par un trait étoilé, comme le script. Chaque trait reste dans sa barre large s’il tient sous son bord, sinon il passe au-dessus de sa moustache ; la lettre se pose au-dessus de tout.
Barres imbriquées : lettres et étoiles · 5 crédits
Liens entre variables18 figures
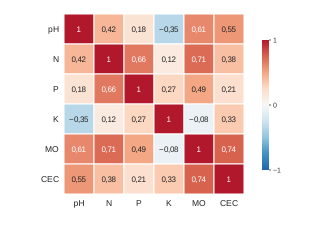
Matrice de corrélation
Toutes les corrélations deux à deux en cercles ou en carrés, de la taille et de la couleur du coefficient ; les cases non significatives après correction peuvent rester vides.
Corrélation et régression · 5 crédits
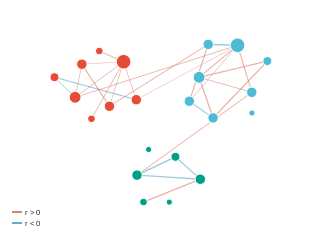
Réseau de corrélations
Les variables reliées par leurs corrélations fortes : l’épaisseur du lien dit la force, sa couleur le signe ; les variables isolées restent à l’écart.
Corrélation et régression · 5 crédits
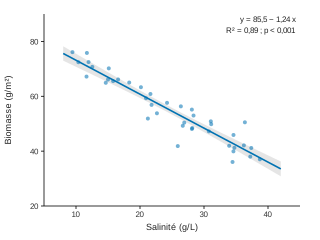
Régression et IC 95 %
La relation entre deux variables : le nuage de points, la droite (ou la courbe) ajustée et sa bande de confiance, l’équation et le R².
Corrélation et régression · 5 crédits
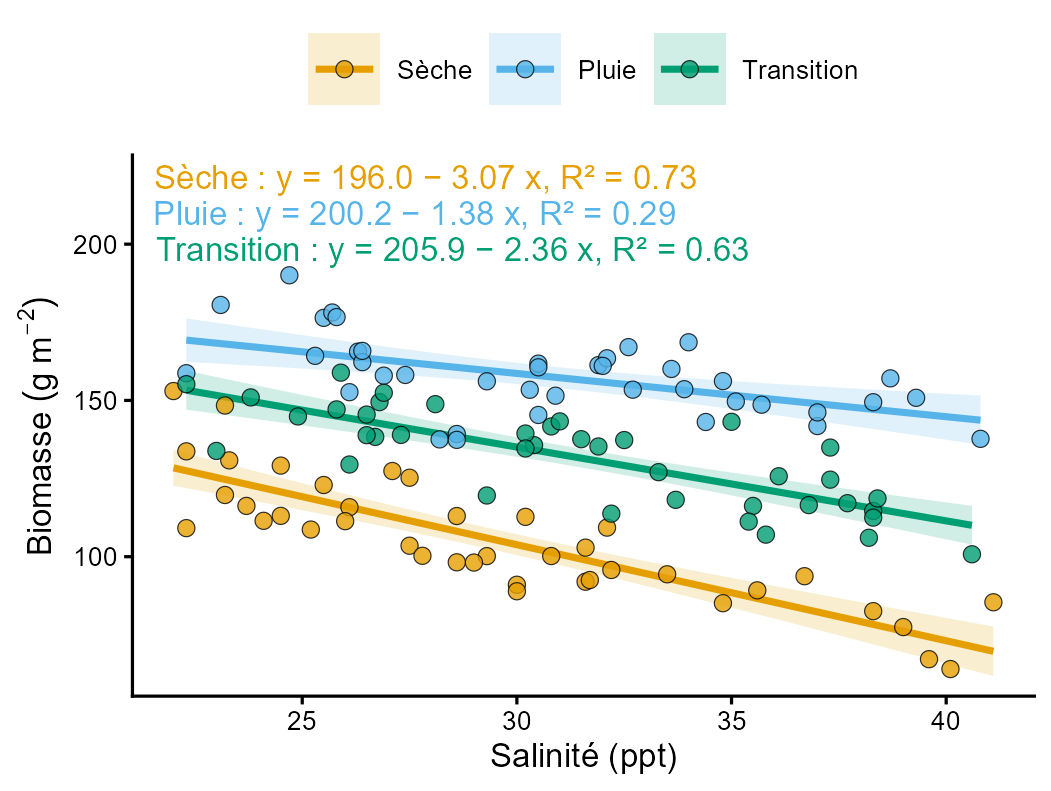
Une droite par groupe
Une droite (ou une courbe) par groupe, dans la couleur du groupe, et le test qui dit si les pentes diffèrent : comparer des tendances.
Corrélation et régression · 5 crédits
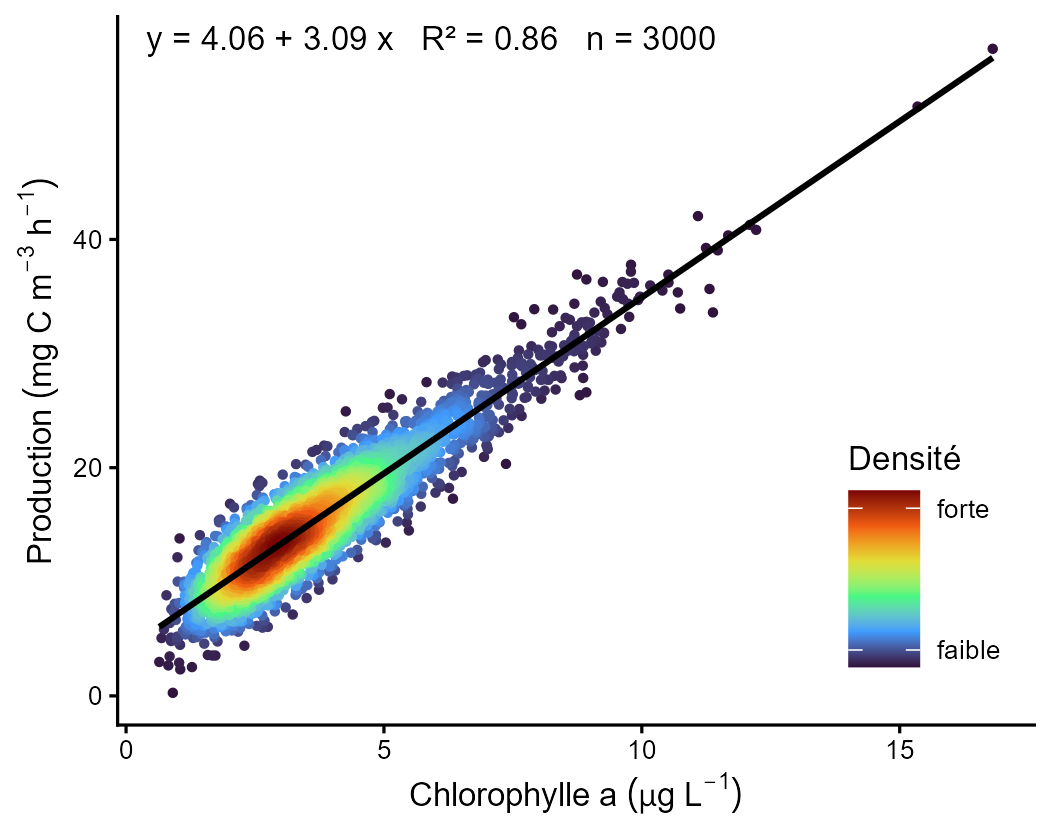
Nuage coloré par densité
Un grand nuage de points colorés selon leur densité locale, avec la droite ajustée : on voit où se concentrent les mesures quand les points se superposent.
Corrélation et régression · 5 crédits
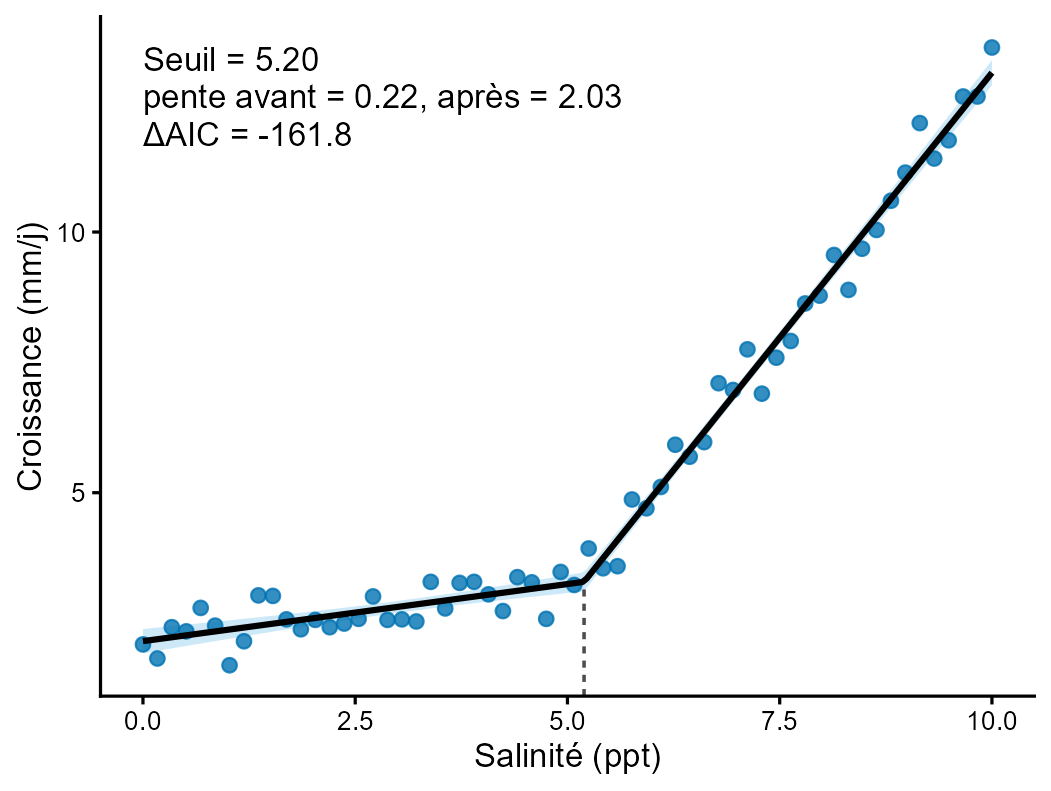
Rupture de pente
Deux droites raccordées en un point de rupture estimé : où la réponse change de rythme, et si deux droites font mieux qu’une.
Corrélation et régression · 5 crédits
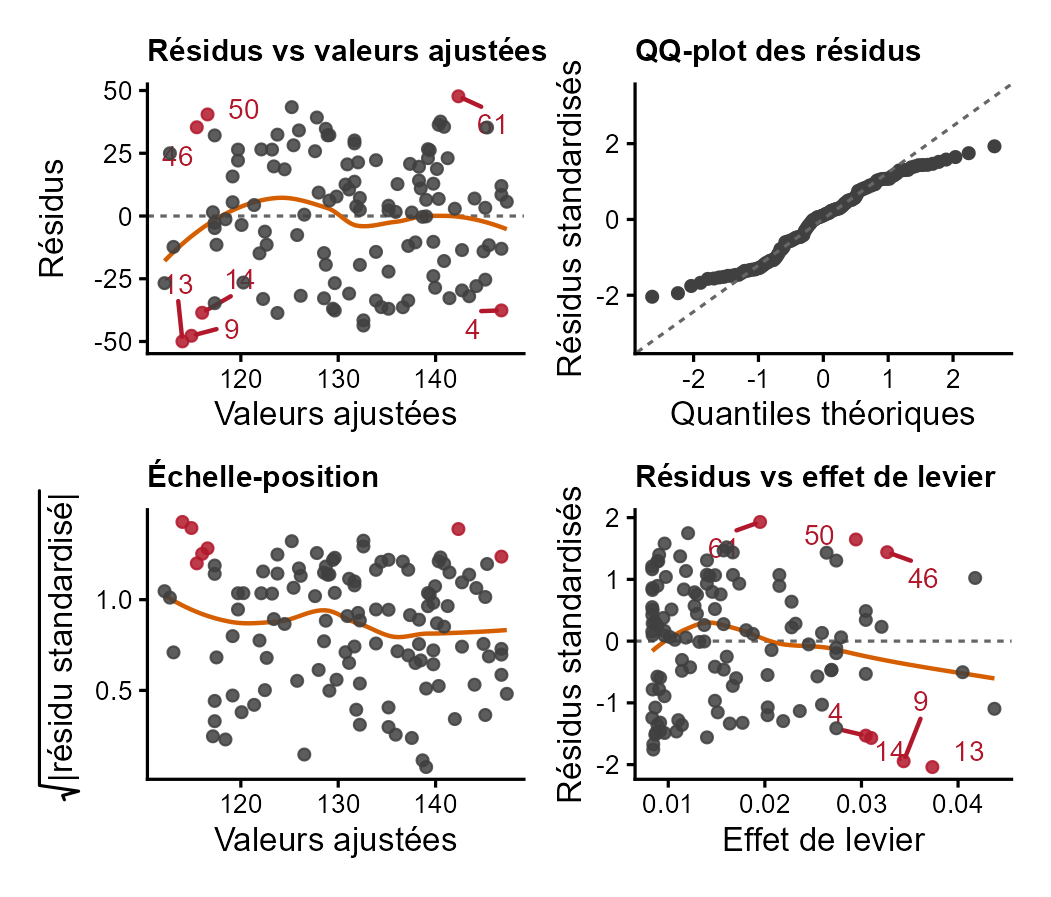
Diagnostics de la régression
Les quatre vérifications d’une régression linéaire : résidus contre valeurs ajustées, QQ-plot, échelle-position et distance de Cook (les points qui tirent la droite).
Corrélation et régression · 5 crédits
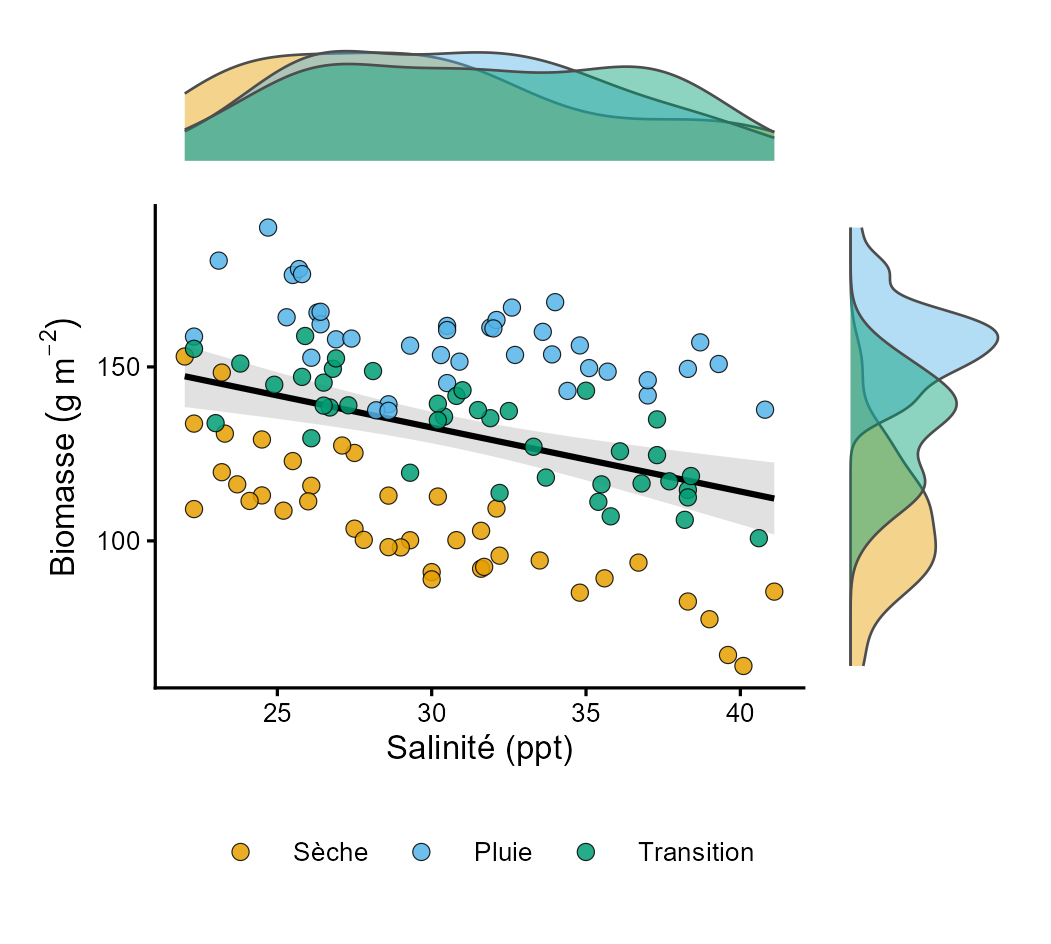
Régression + marges
Le nuage de points et sa droite ajustée, avec en haut et à droite la densité de chaque variable.
Corrélation et régression · 5 crédits
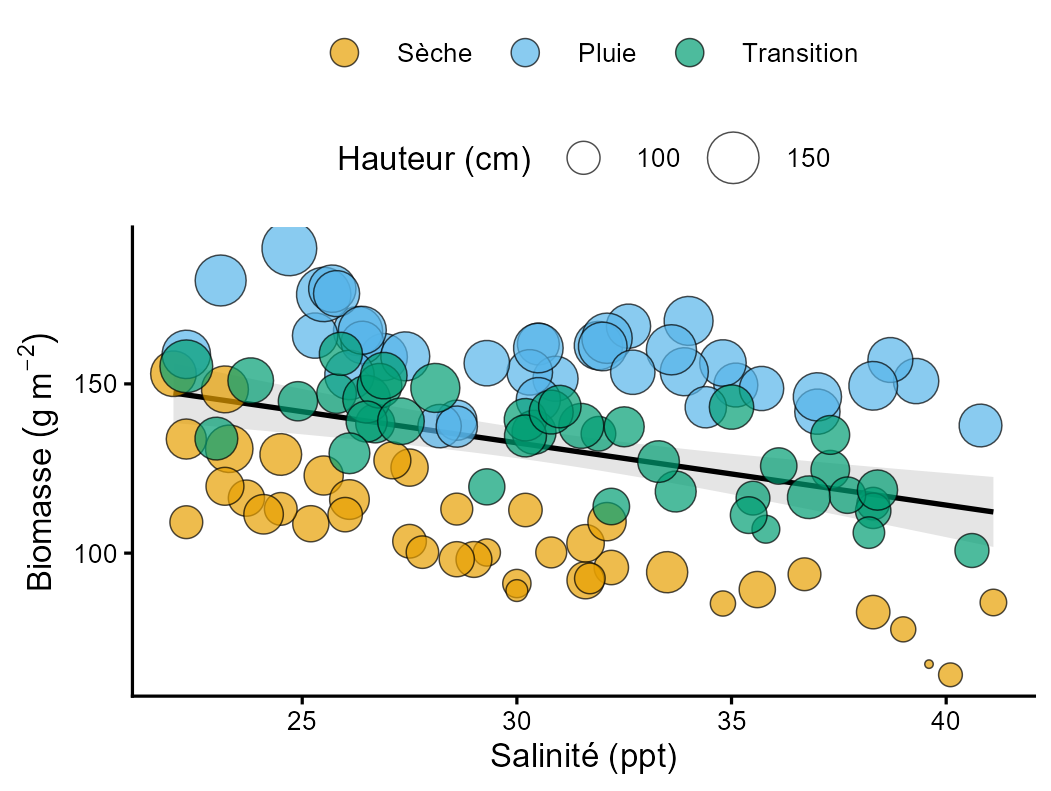
Bulles : une 3ᵉ variable
Le nuage de points d’une régression où la taille de chaque point porte une troisième variable (hauteur, effectif, pluie).
Corrélation et régression · 5 crédits
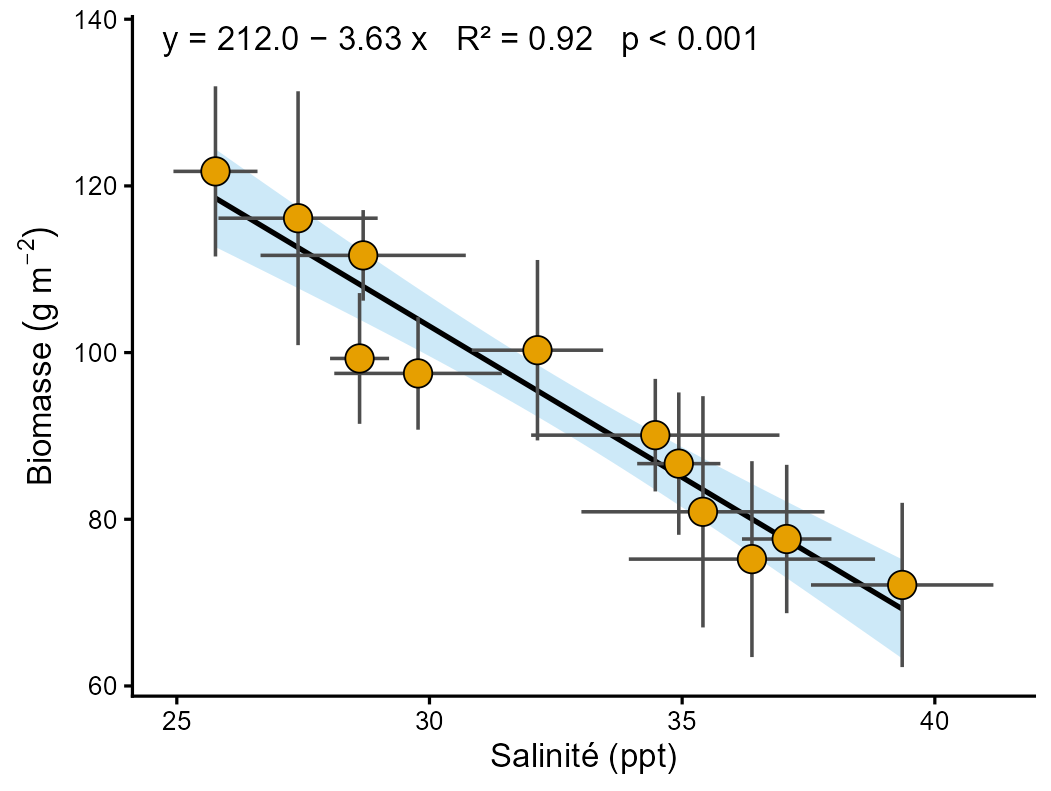
Moyennes ± erreur en X et Y
Une moyenne par groupe, ses barres d’erreur sur les deux axes, et la régression qui passe par les moyennes : la tendance entre stations, sites ou lots.
Corrélation et régression · 5 crédits
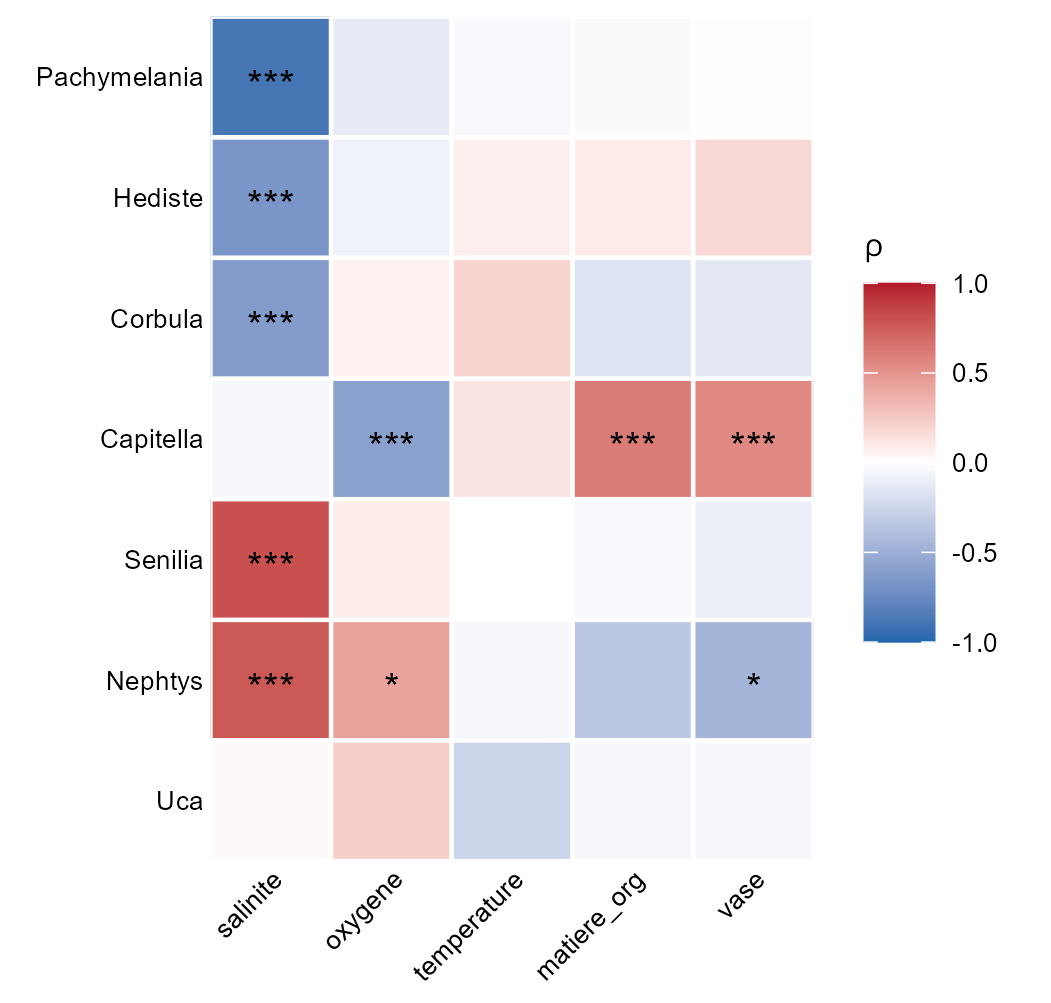
Heatmap X × Y étoilée
Chaque réponse (ligne) corrélée à chaque facteur (colonne) en heatmap, avec les étoiles de significativité dans les cases.
Corrélations croisées et Mantel · 5 crédits
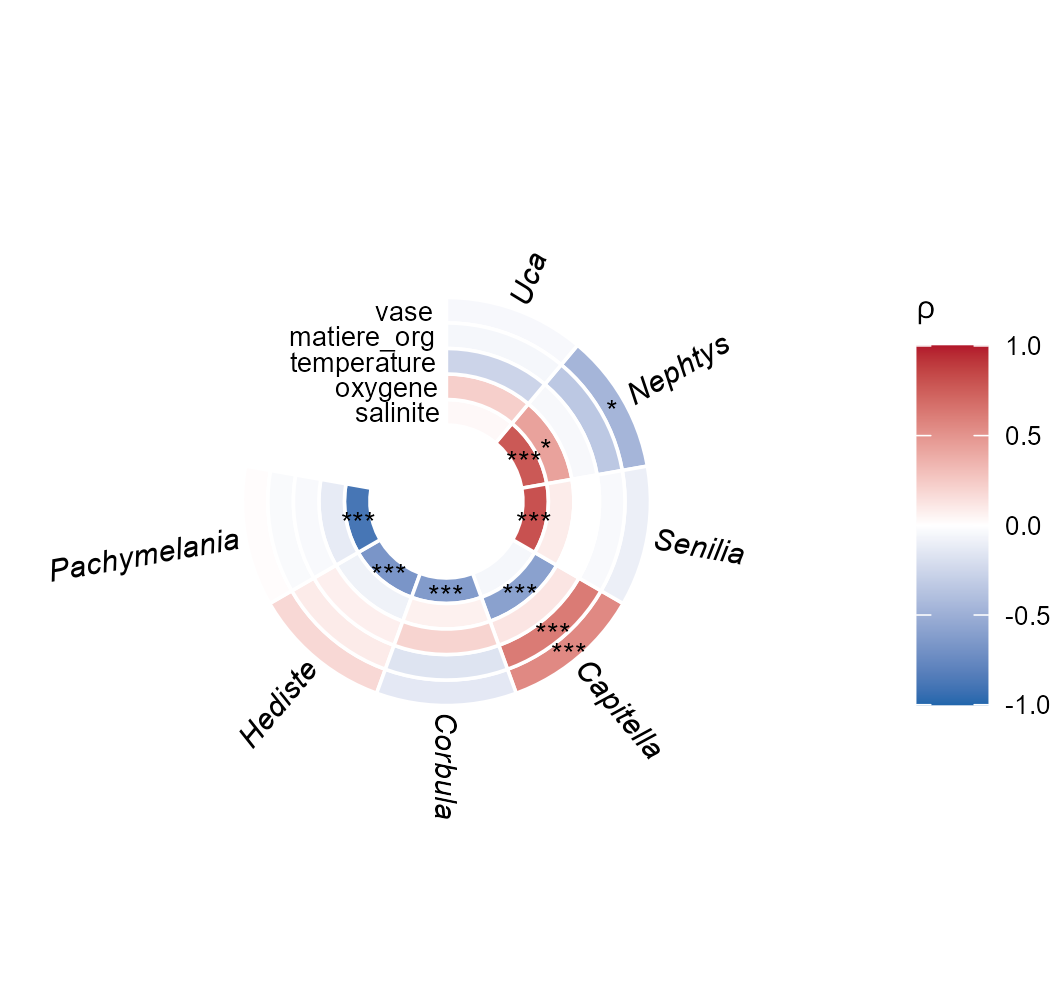
Heatmap circulaire
La matrice des corrélations X × Y enroulée en cercle : un secteur par réponse, un anneau par facteur, les étoiles dans les cases.
Corrélations croisées et Mantel · 5 crédits
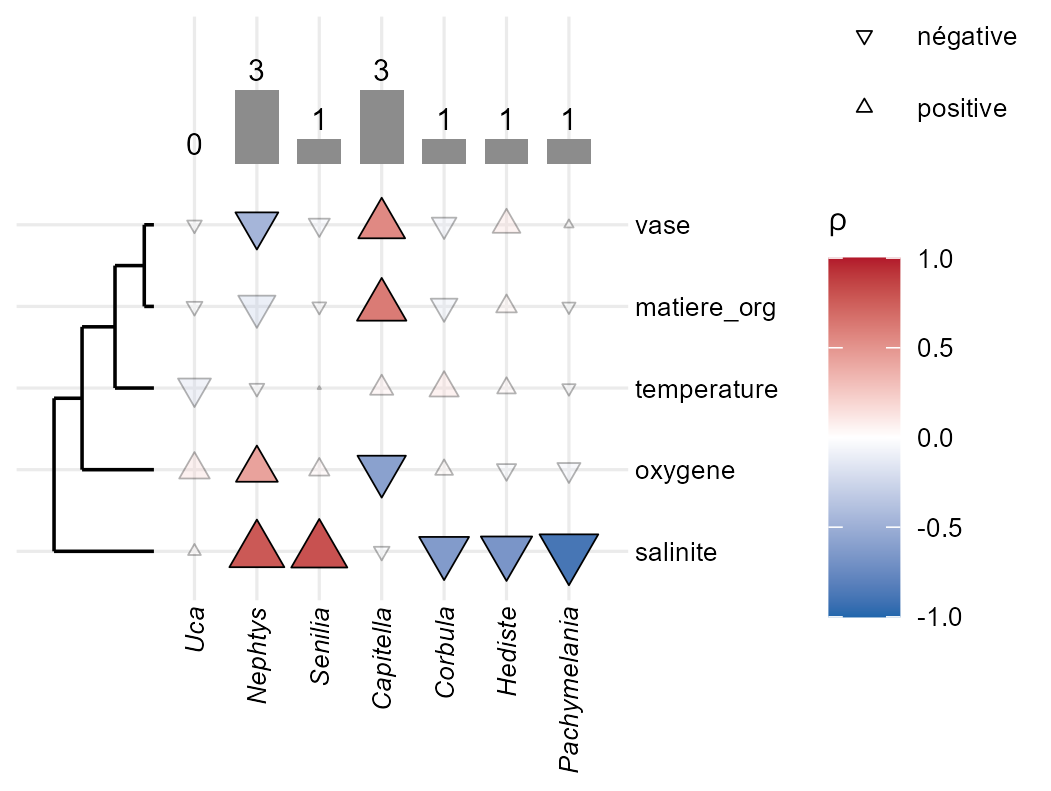
Triangles ▲▼ et arbre
▲ pour un lien positif, ▼ pour un négatif, de la taille de la corrélation ; un arbre regroupe les facteurs et des barres comptent les liens significatifs de chaque réponse.
Corrélations croisées et Mantel · 5 crédits
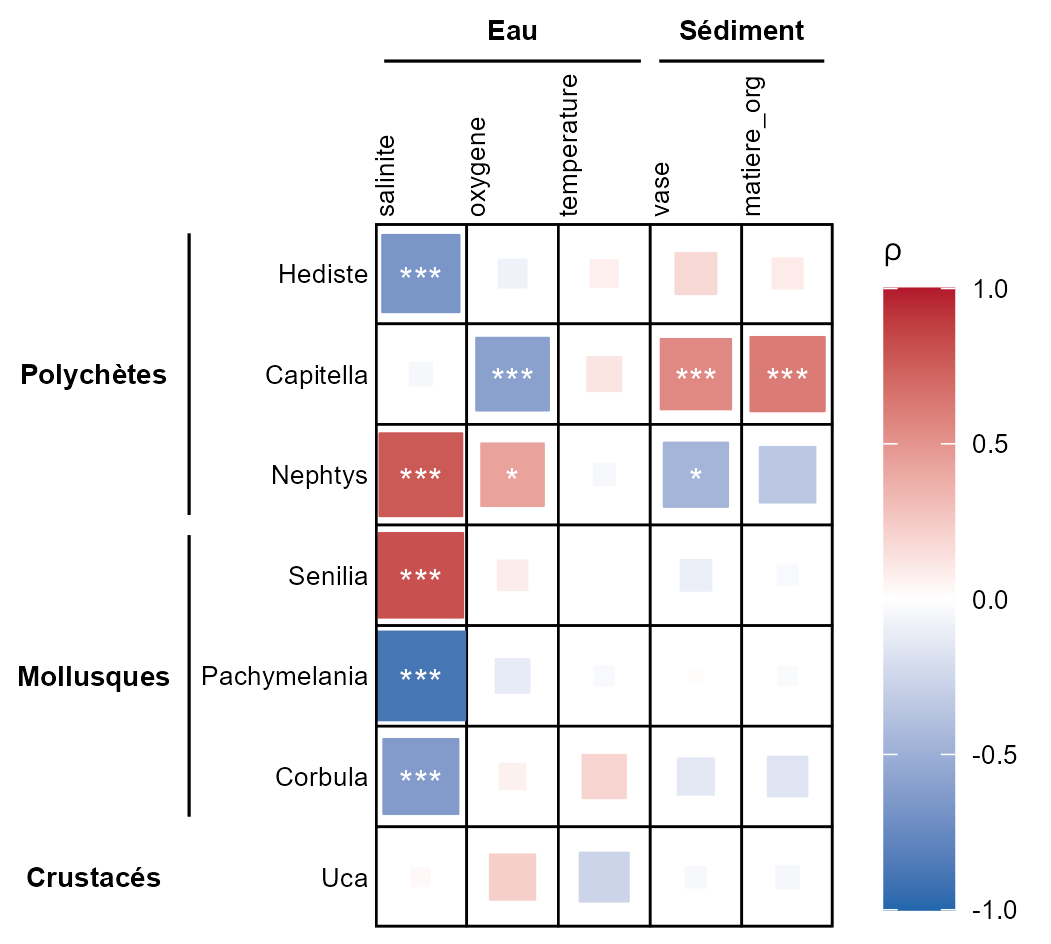
Carrés proportionnels, axes emboîtés
Dans chaque case encadrée, un carré de la taille de la corrélation et de la couleur de son signe, les étoiles au centre ; réponses et facteurs regroupés sous des bandeaux colorés.
Corrélations croisées et Mantel · 5 crédits
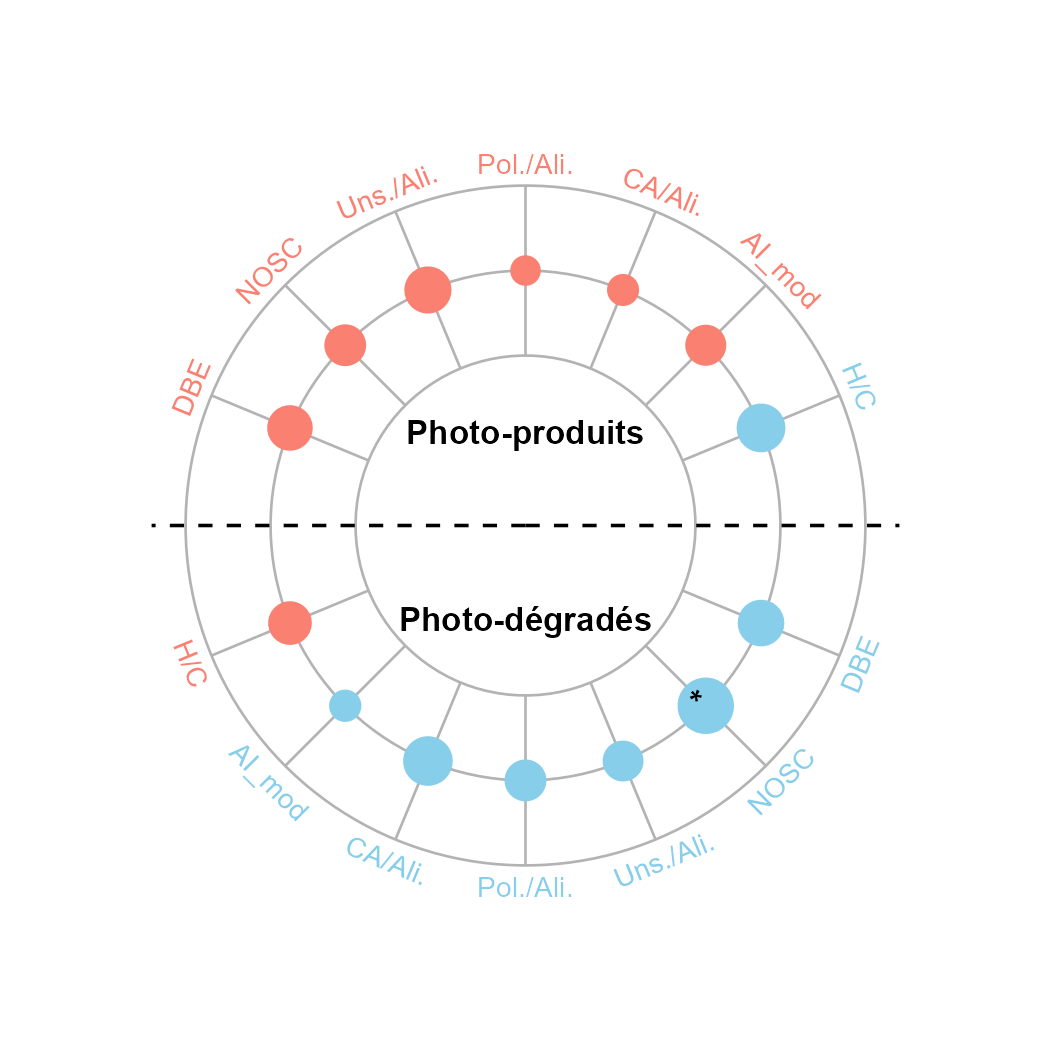
Bulles en anneau symétriques
Les facteurs tout autour d’un anneau, une moitié par réponse : chaque bulle a la taille de la corrélation et la couleur de son signe, ses étoiles au centre, le nom des réponses dans le trou.
Corrélations croisées et Mantel · 5 crédits
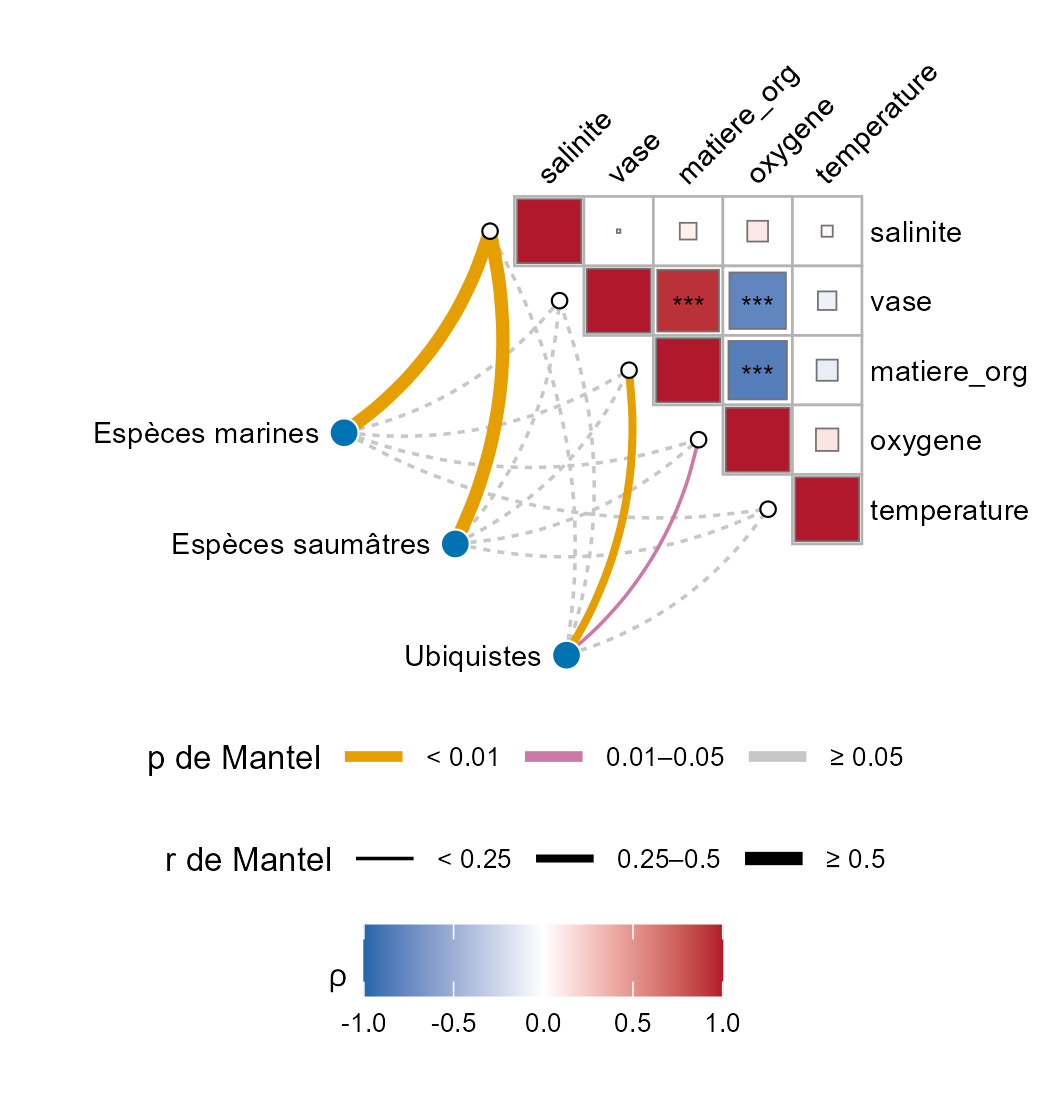
Test de Mantel + triangle
Les corrélations entre facteurs en triangle, et des courbes qui relient chaque bloc de réponses aux facteurs : le test de Mantel dit si la composition suit chaque facteur.
Corrélations croisées et Mantel · 5 crédits
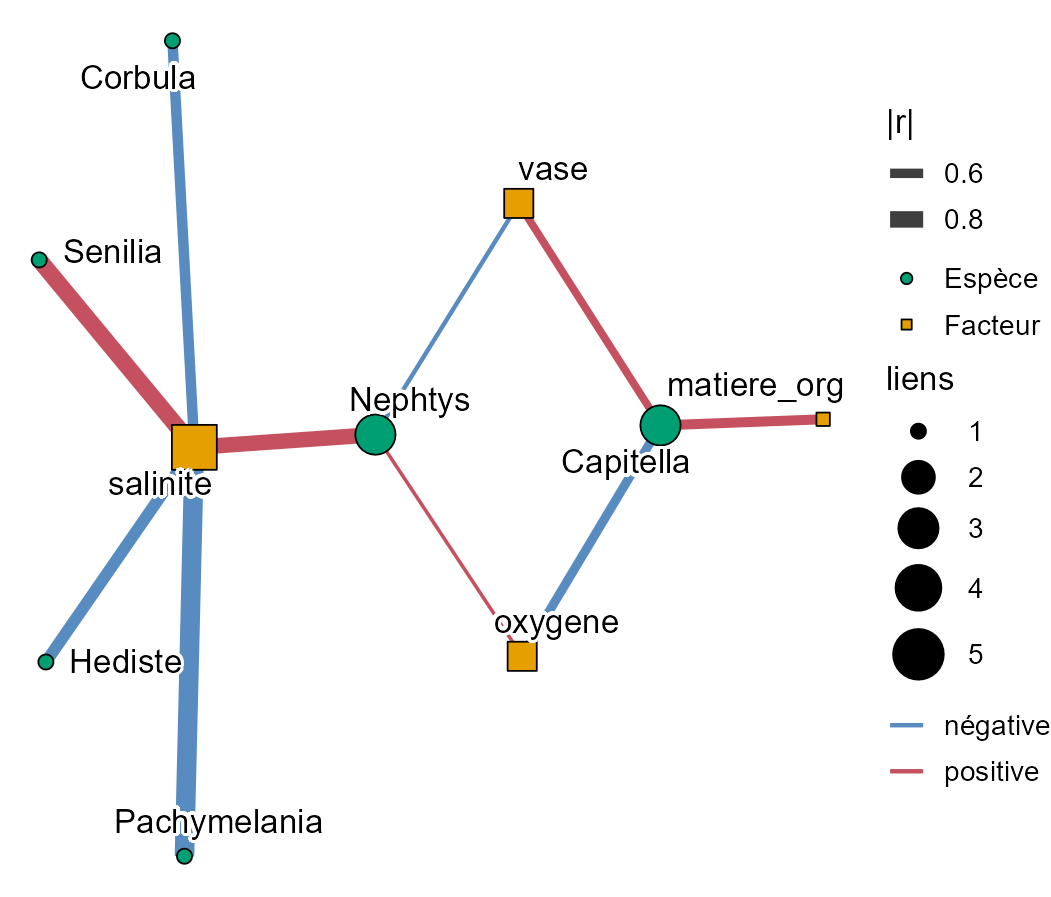
Réseau biparti espèces-milieu
Facteurs (carrés) et réponses (ronds) reliés par leurs corrélations significatives et fortes ; la couleur du lien donne le sens.
Corrélations croisées et Mantel · 5 crédits
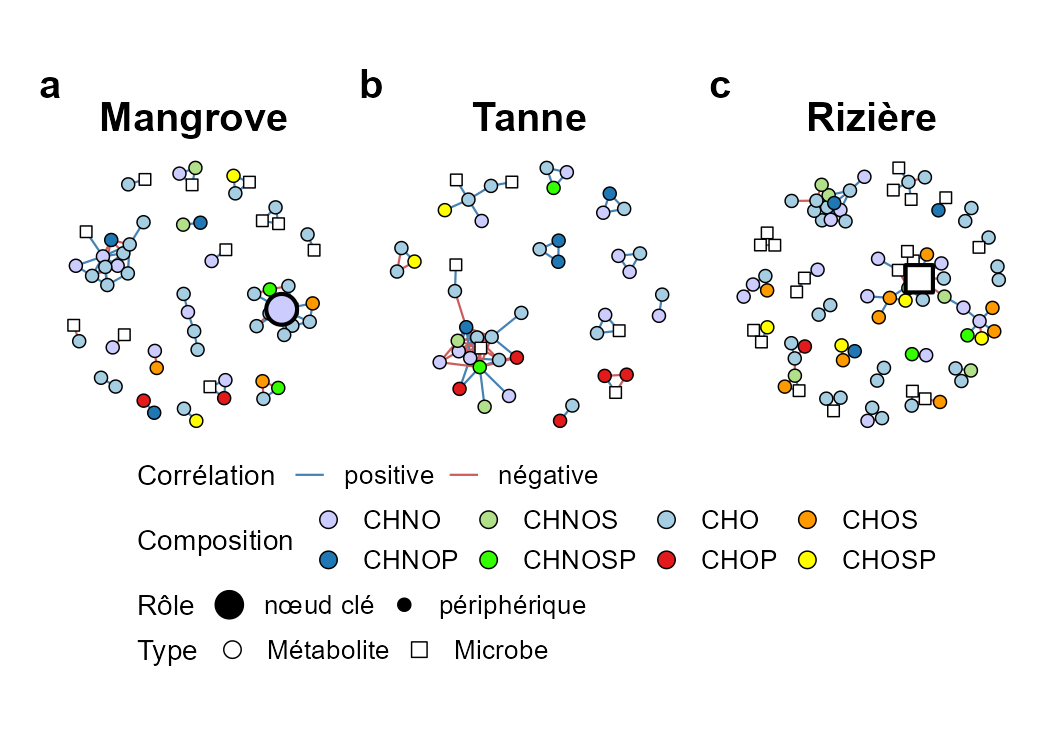
Réseaux de co-occurrence par milieu
Un réseau de co-occurrence par milieu, côte à côte, comme l’article (Nature Microbiology, 2024) : un nœud par microbe ou métabolite, un lien quand deux éléments varient ensemble (bleu) ou en sens contraires (rouge) au-delà d’un seuil, les métabolites en ronds colorés par leur composition élémentaire, les microbes en carrés, les nœuds clés (hubs et connecteurs, selon Zi et Pi) en grand.
Réseaux de co-occurrence par milieu · 5 crédits
Variables qualitatives (effectifs)5 figures
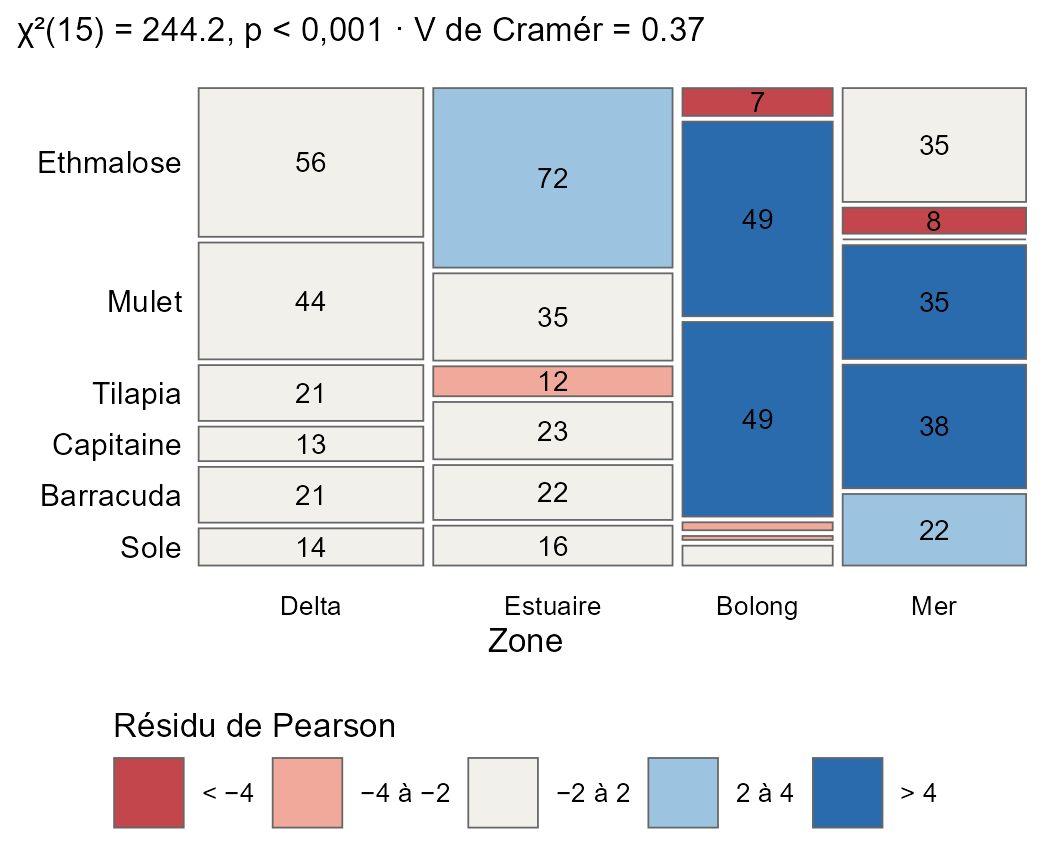
Mosaïque et résidus de Pearson
Chaque catégorie aussi large que son effectif, chaque case aussi haute que sa part ; en bleu les cases plus remplies qu’attendu sous l’indépendance, en rouge les moins remplies.
Tableau de contingence · 5 crédits
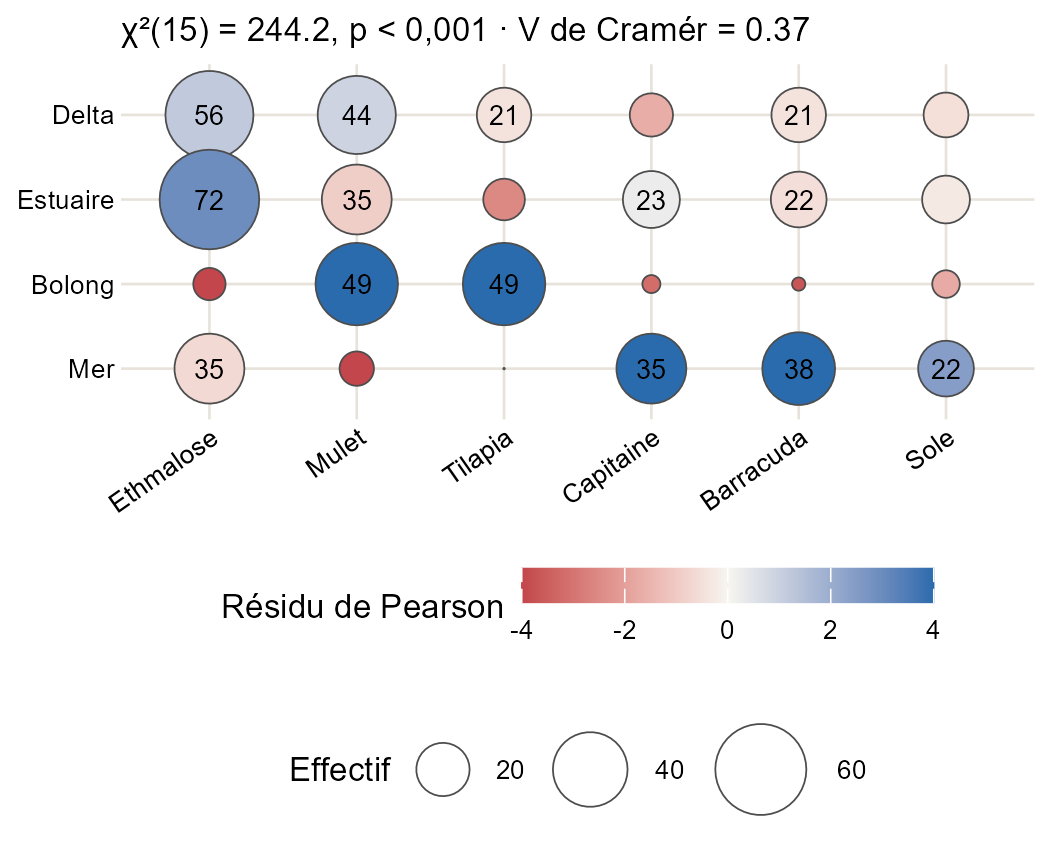
Ballons d’un tableau croisé
Une bulle par case du tableau croisé, d’aire proportionnelle à l’effectif, colorée par son écart à l’indépendance (résidu de Pearson).
Tableau de contingence · 5 crédits
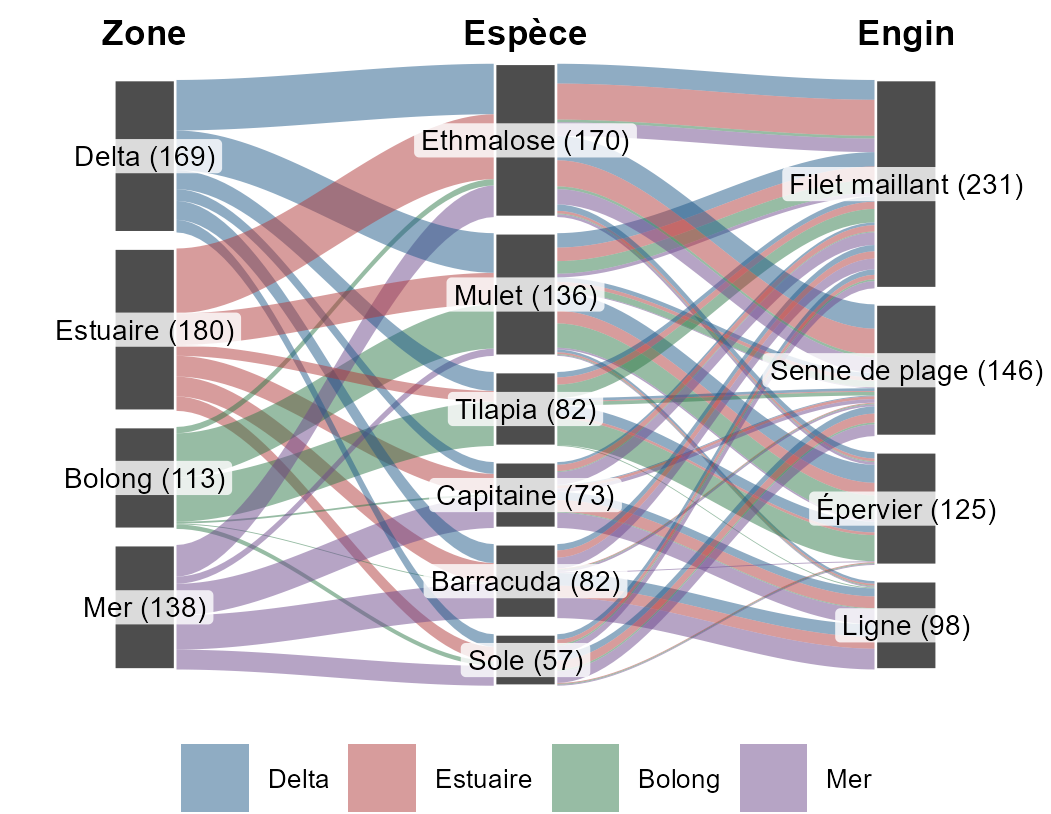
Sankey (alluvial) de trois variables
Les observations qui s’écoulent d’une variable qualitative à la suivante, en rubans aussi larges que les effectifs : deux à quatre variables enchaînées.
Tableau de contingence · 5 crédits
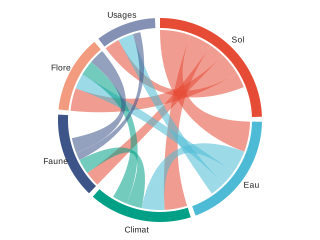
Diagramme de cordes
Un tableau croisé en diagramme de cordes : chaque catégorie sur l’anneau, un lien par case aussi large que son effectif, les noms autour.
Tableau de contingence · 5 crédits
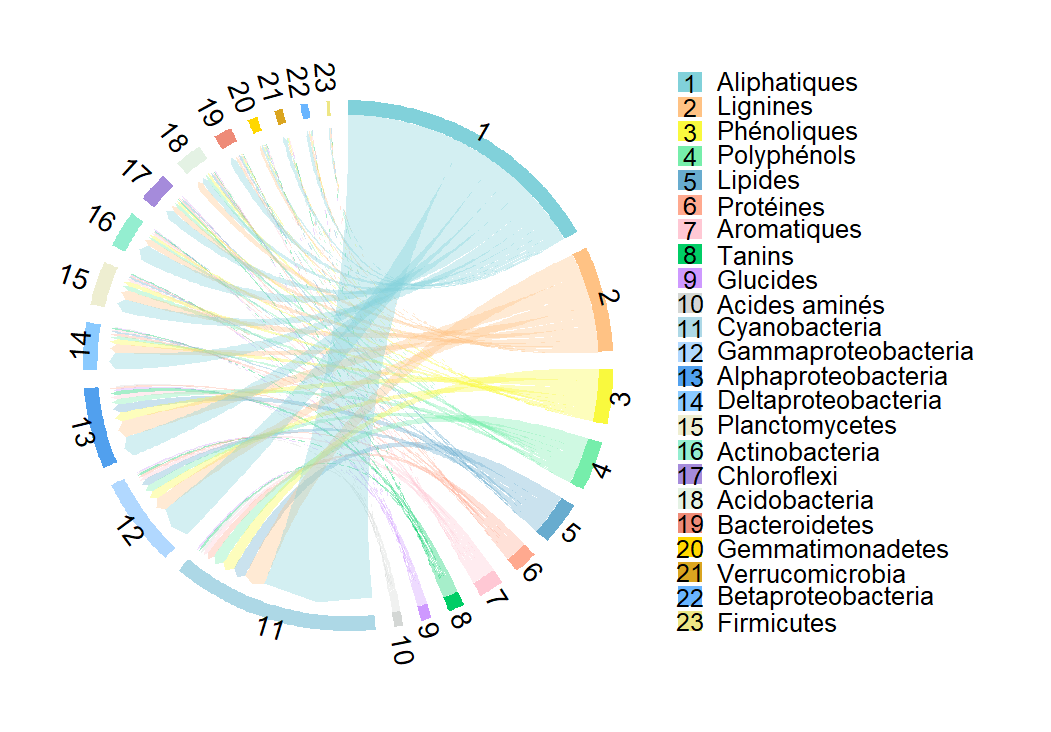
Cordes numérotées + légende
Le diagramme de cordes d’un tableau croisé, chaque secteur numéroté sur son anneau et nommé dans une légende à côté : lisible même avec de longs noms.
Tableau de contingence · 5 crédits
Expliquer une variable (régressions)12 figures
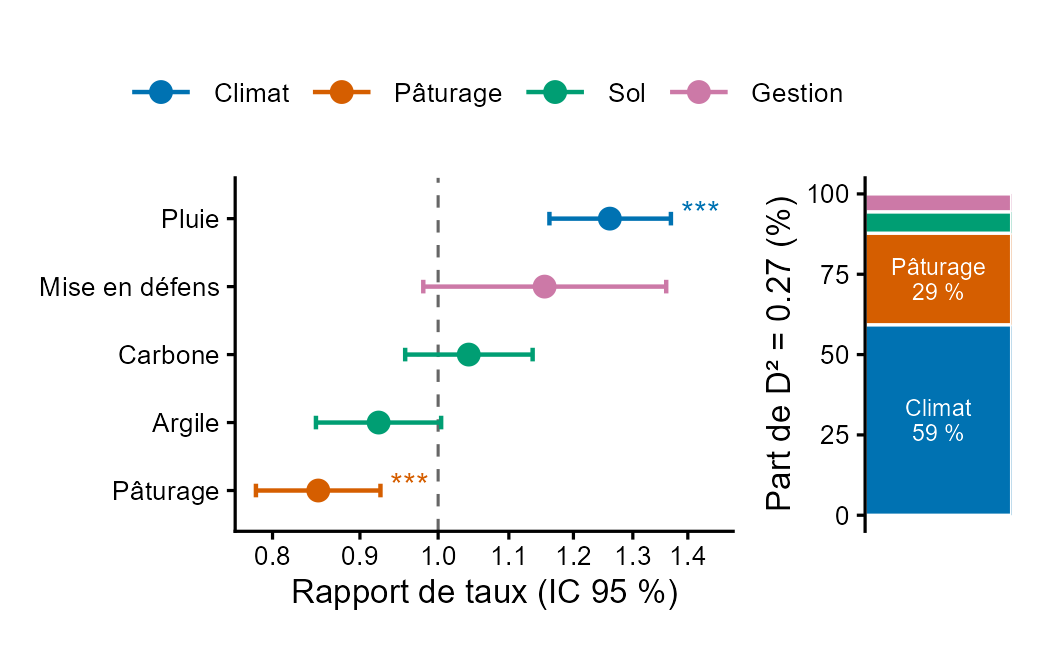
Coefficients + importance (glmm.hp)
Le coefficient de chaque prédicteur d’un GLM avec son intervalle, et à droite la part de la déviance expliquée qui revient à chaque prédicteur (partition hiérarchique).
Régression multiple et GLM · 5 crédits
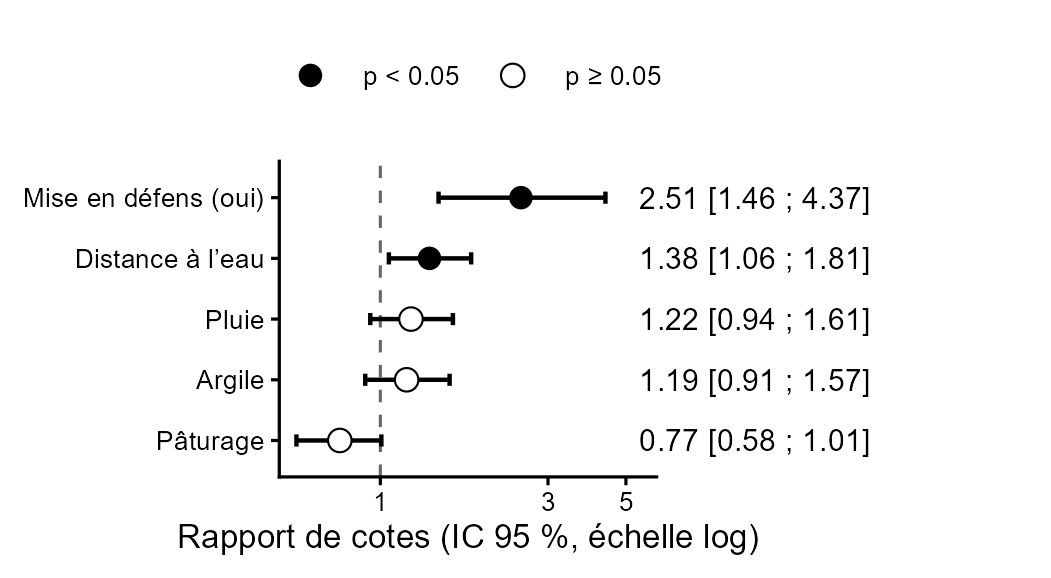
Rapports de cotes (forest plot)
Le rapport de cotes de chaque prédicteur d’une régression logistique et son intervalle à 95 %, sur une échelle log : à droite de 1, la présence devient plus probable.
Régression multiple et GLM · 5 crédits
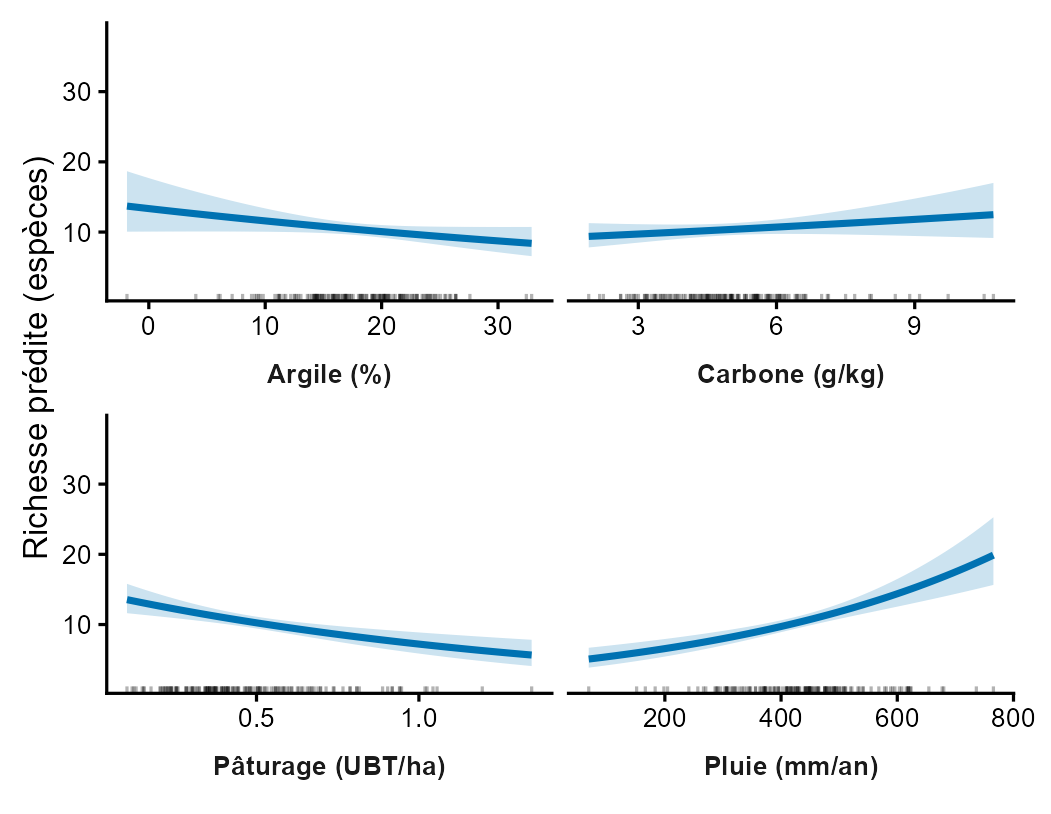
Effets prédits ± IC 95 %
La réponse prédite le long de chaque prédicteur, les autres fixés à leur moyenne, avec sa bande de confiance : l’effet de chacun sur l’échelle de la réponse.
Régression multiple et GLM · 5 crédits
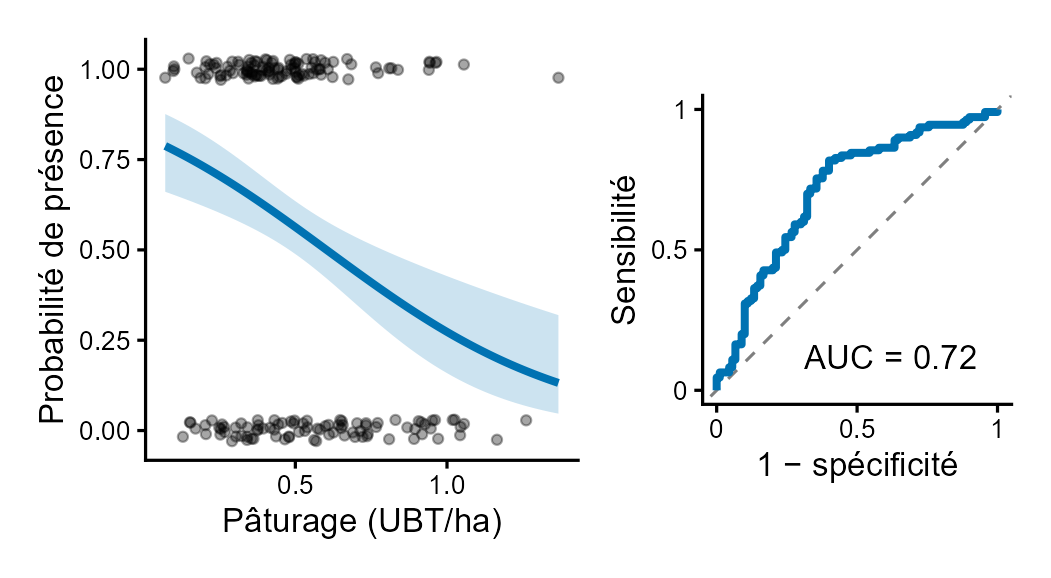
Régression logistique + ROC
La probabilité de l’événement selon chaque prédicteur, avec sa bande de confiance, et la courbe ROC du modèle avec son AUC.
Régression multiple et GLM · 5 crédits
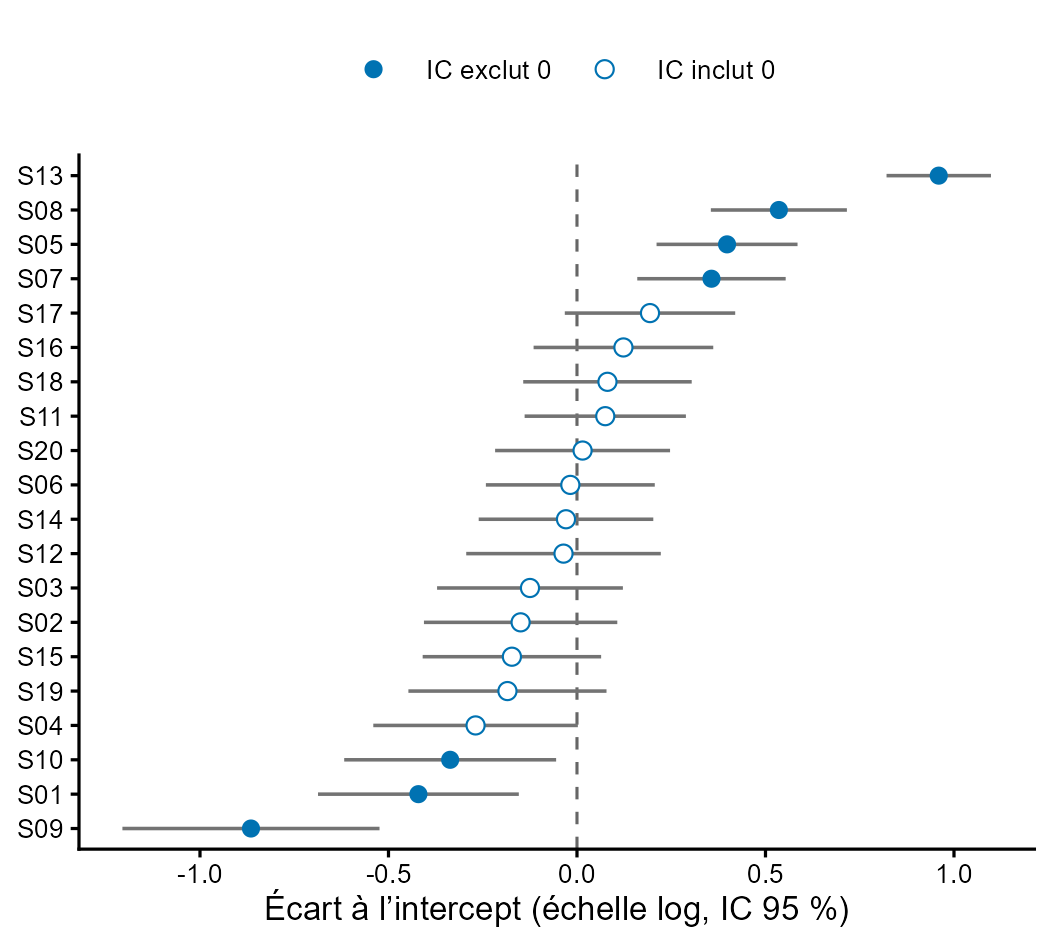
Effets aléatoires (chenille)
L’écart de chaque niveau d’un effet aléatoire (site, station) à l’intercept d’un GLMM, avec son intervalle à 95 %, rangés du plus bas au plus haut.
Régression multiple et GLM · 5 crédits
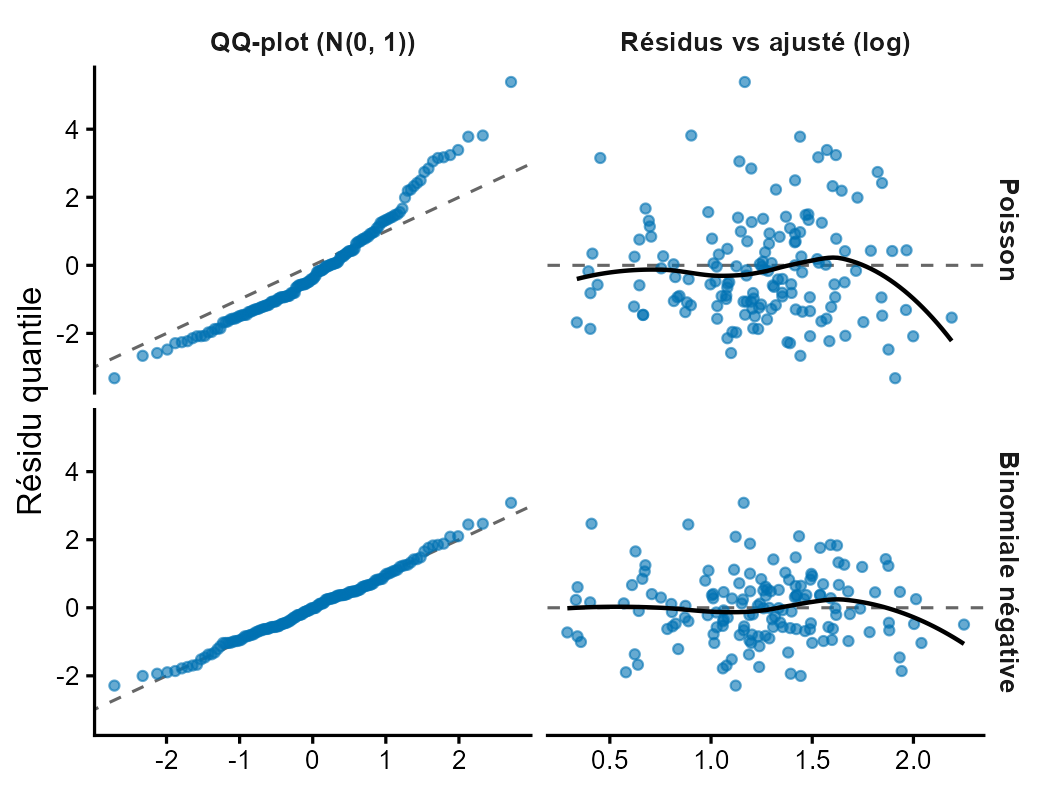
Résidus quantiles (Dunn-Smyth)
Les résidus quantiles randomisés (Dunn-Smyth) du modèle : ils suivent une loi normale quand la loi choisie convient. C’est le contrôle d’un modèle de comptage ou de 0/1.
Régression multiple et GLM · 5 crédits
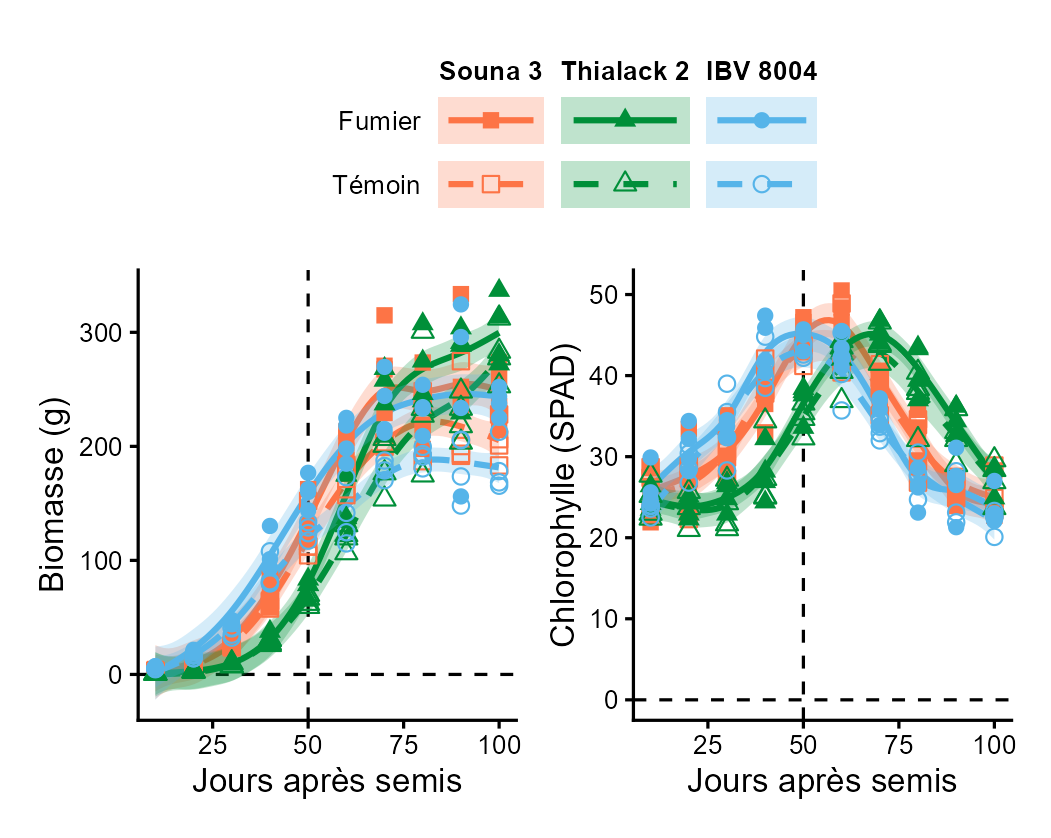
Courbes GAM, légende croisée
Une courbe lissée par combinaison de deux facteurs, avec sa bande de confiance : la couleur pour le premier, le trait plein ou tireté pour le second, réunis dans une légende croisée.
Régression lissée (GAM) · 5 crédits
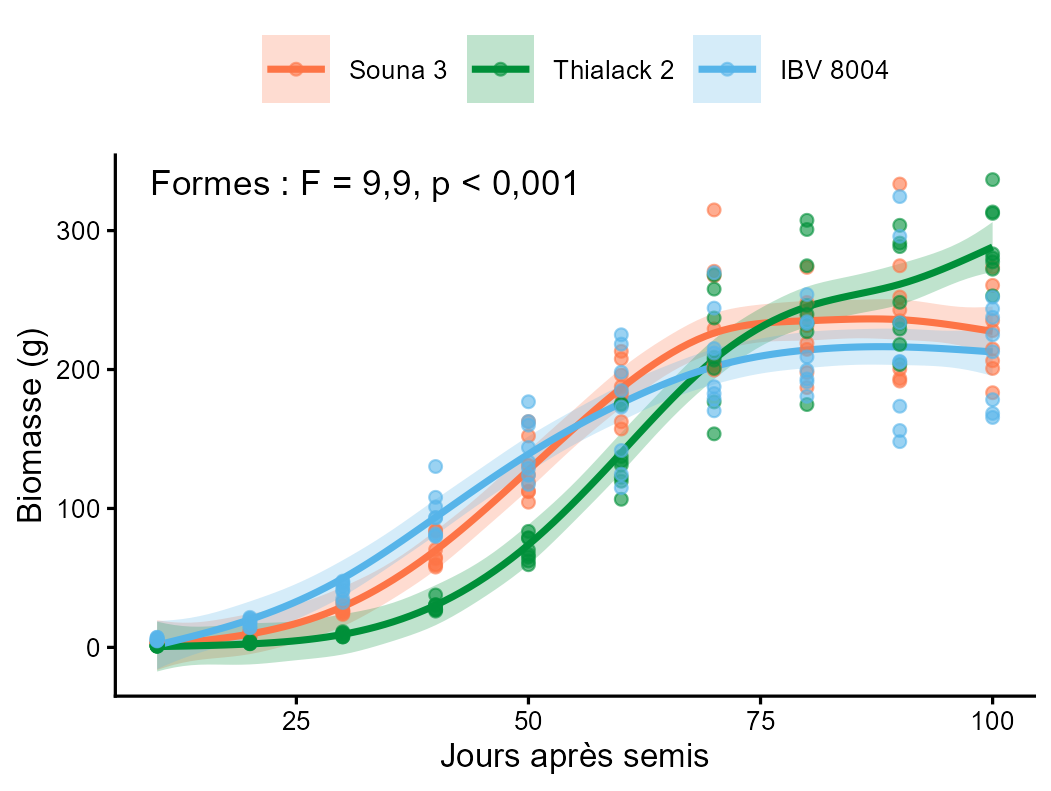
Une courbe par groupe, un seul modèle
Une courbe lissée par groupe dans un seul modèle additif (GAM) : les courbes prédites, leurs bandes, et le test qui dit si leurs formes diffèrent.
Régression lissée (GAM) · 5 crédits
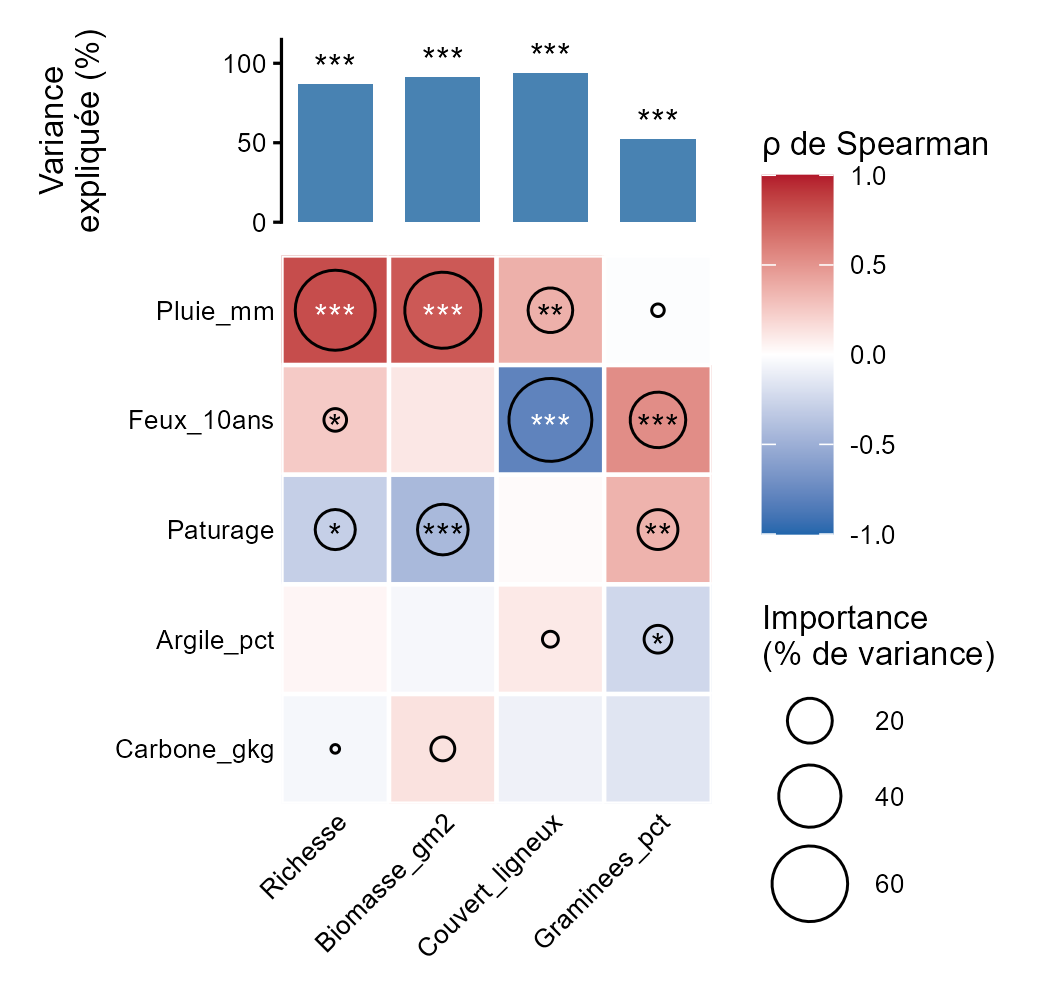
Corrélations + importance (relaimpo)
La corrélation de chaque réponse avec chaque facteur en heatmap, un cercle par facteur retenu dans son modèle (aire = importance LMG), et au-dessus la variance expliquée par chaque modèle.
Régression : importance des variables · 5 crédits
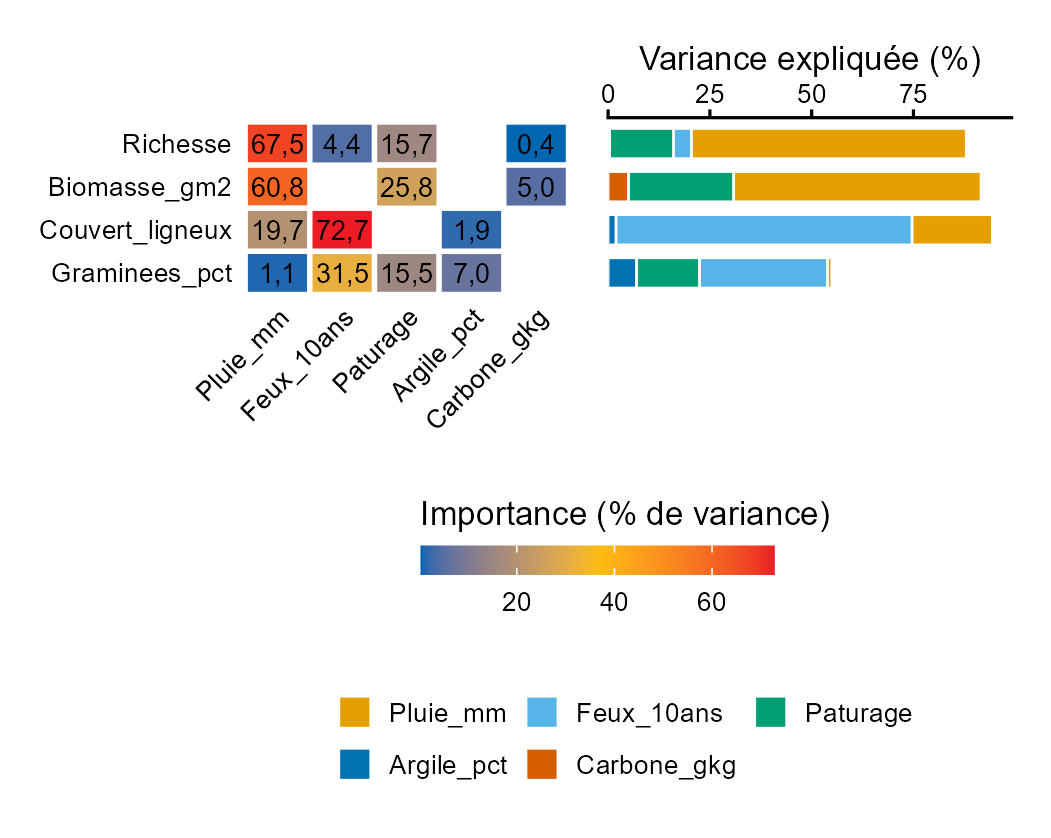
Importance en barres empilées
L’importance LMG de chaque facteur retenu, écrite dans une heatmap, à côté des barres empilées qu’elle forme pour chaque réponse : qui explique quoi, et combien.
Régression : importance des variables · 5 crédits
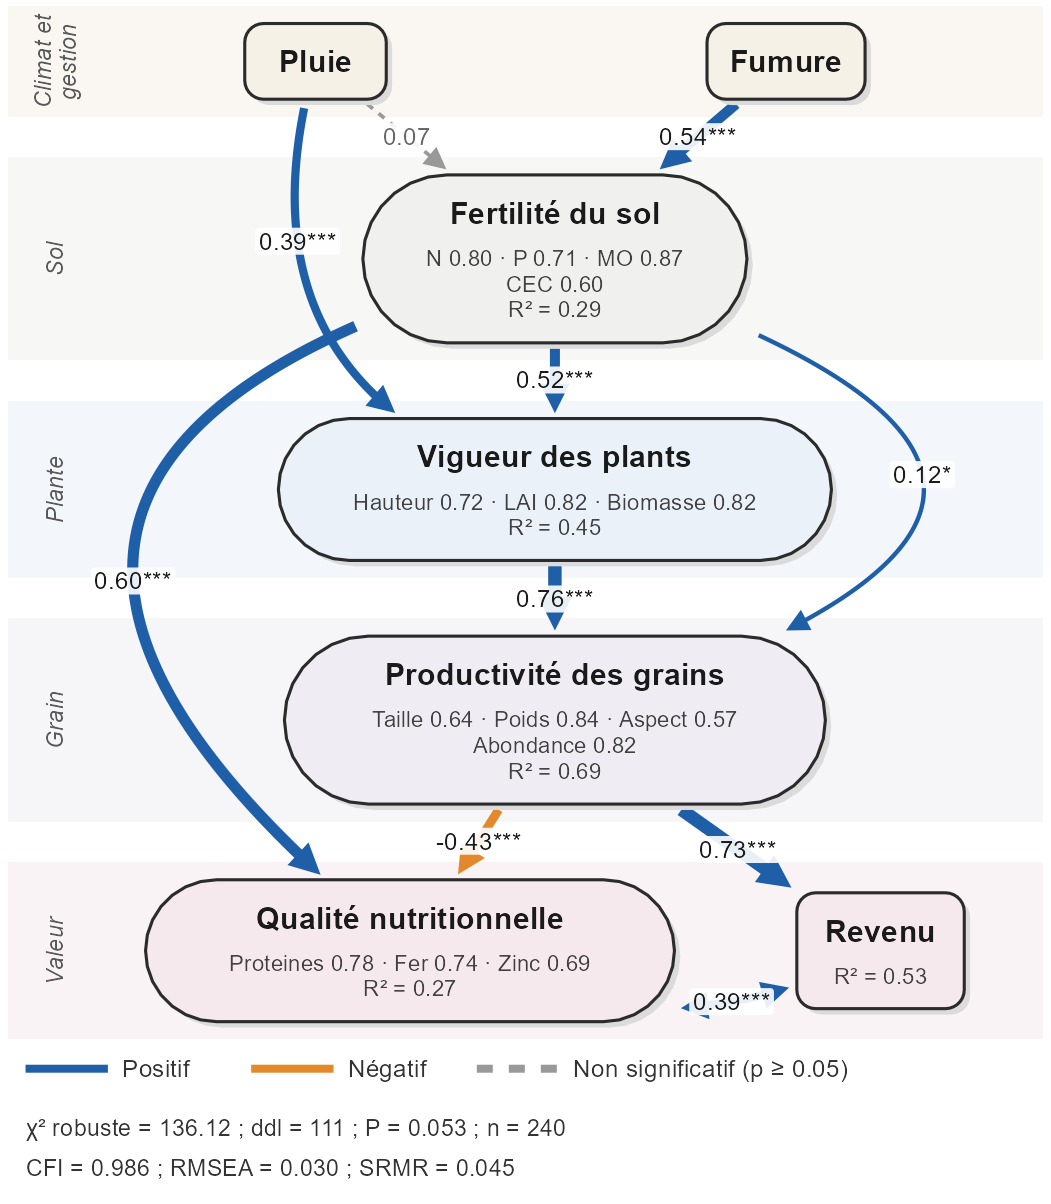
SEM à niveaux et variables latentes
Le diagramme d’un modèle d’équations structurelles en autant de niveaux que vous voulez, des causes en haut aux variables expliquées en bas : chaque variable faite de plusieurs colonnes est une variable latente (un ovale, avec les charges de ses colonnes), chaque chemin a son coefficient standardisé, sa couleur selon le signe et son épaisseur, et l’ajustement du modèle (χ², CFI, RMSEA, SRMR) est écrit dessous.
Équations structurelles : SEM et PLS-PM · 5 crédits
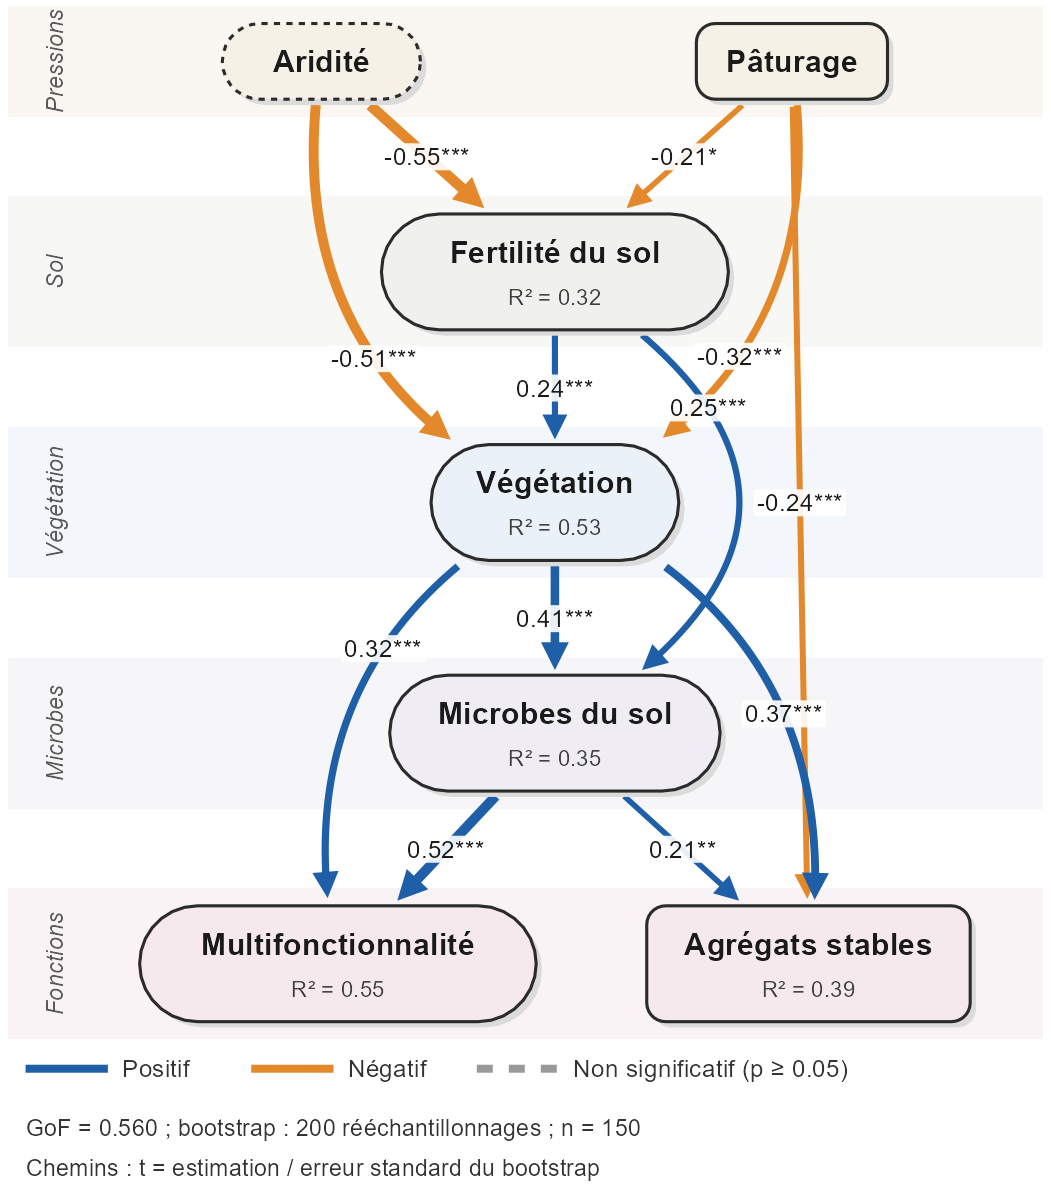
PLS-PM à niveaux, composites et bootstrap
Le diagramme d’un modèle de chemins PLS (PLS-PM) en niveaux : des blocs réflectifs (mode A) ou des indices composites formatifs (mode B, en tirets, avec les poids de leurs colonnes), les chemins standardisés testés par bootstrap, le R² de chaque variable expliquée et le GoF.
Équations structurelles : SEM et PLS-PM · 5 crédits
Expression des gènes (omique)9 figures
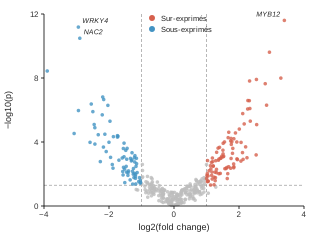
Volcano plot
Chaque gène (ou métabolite) placé selon l’ampleur de son changement (log2 fold change) et sa significativité (−log10 p ajustée) : à droite ce qui monte, à gauche ce qui baisse, les plus marqués nommés.
Volcano plot : expression différentielle · 5 crédits
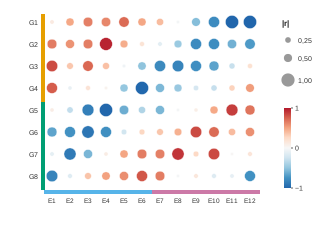
Heatmap à bulles
Les mêmes gènes dans plusieurs comparaisons : une bulle par gène et comparaison, sa couleur le log2 fold change (rouge en hausse, bleu en baisse), sa taille le −log10 de la p ajustée, un cerne noir quand le changement passe les seuils. Les gènes qui changent le plus sont rangés par profil (classification hiérarchique).
Heatmap à bulles : plusieurs comparaisons · 5 crédits
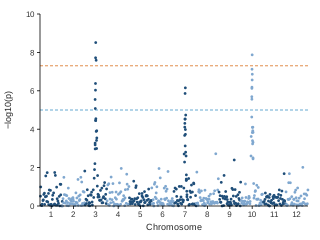
Manhattan plot
Chaque marqueur placé le long du génome par sa position, à la hauteur du −log10 de sa p-value, les chromosomes en couleurs alternées : la ligne en tirets marque le seuil pangénomique (5 × 10⁻⁸), la ligne pointillée le seuil suggestif (10⁻⁵), le meilleur marqueur de chaque pic est nommé. L’inflation génomique λ dit si les p-values sont fiables.
Manhattan plot (GWAS) · 5 crédits
Manhattan + encart sur le pic
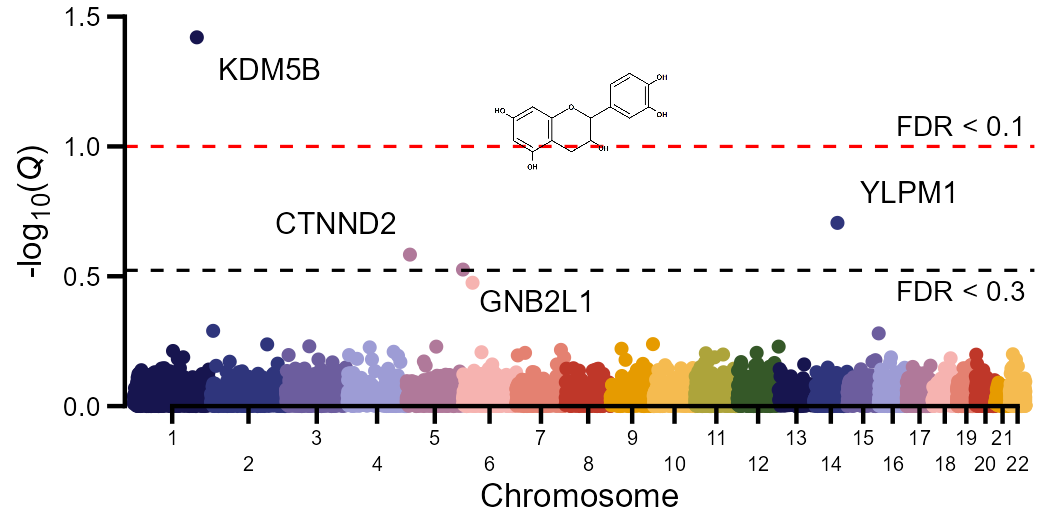
Les marqueurs le long du génome à la hauteur du −log10 de leur valeur Q (FDR), une couleur par chromosome : les seuils FDR 0.1 (rouge) et 0.3 nommés au bout de leur ligne, les marqueurs sous 0.3 nommés, et en encart un zoom sur les quelques mégabases autour du pic le plus fort.
Manhattan plot (GWAS) · 5 crédits
Enrichissement GO
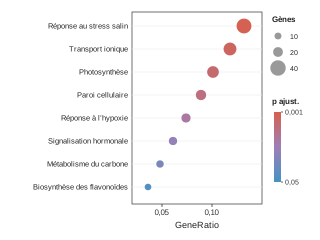
Les termes GO les plus significatifs en dot plot, comme clusterProfiler : chacun placé par son GeneRatio (la part des gènes d’intérêt qu’il contient), sa taille le nombre de gènes, sa couleur la p ajustée, du rouge (très significatif) au bleu.
Enrichissement (GO, KEGG) · 5 crédits
Enrichissement de métabolites (KEGG)
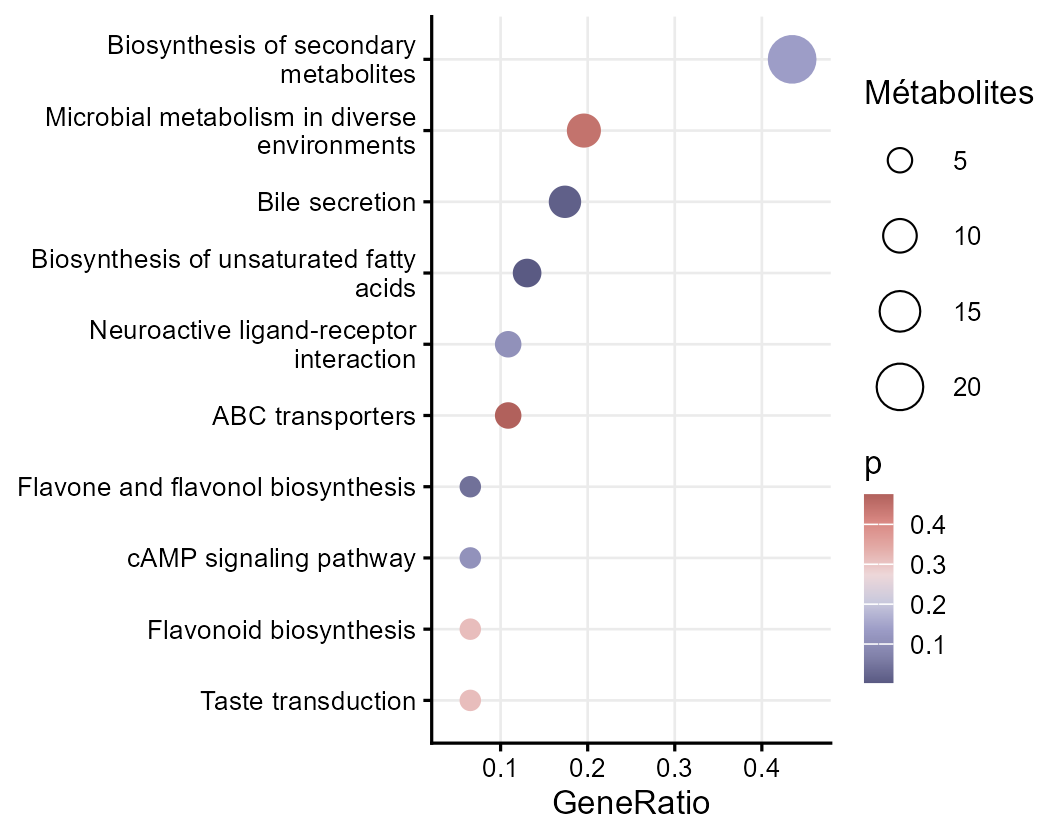
Les voies KEGG qui contiennent le plus de métabolites d’intérêt, testées par le test hypergéométrique de clusterProfiler::enricher contre les métabolites annotés : la taille de chaque point dit le nombre, sa couleur la p-value, sur le dégradé de l’article ; « Metabolic pathways », qui couvre presque tout, peut être laissée de côté.
Enrichissement (GO, KEGG) · 5 crédits
Double volcan (deux comparaisons)
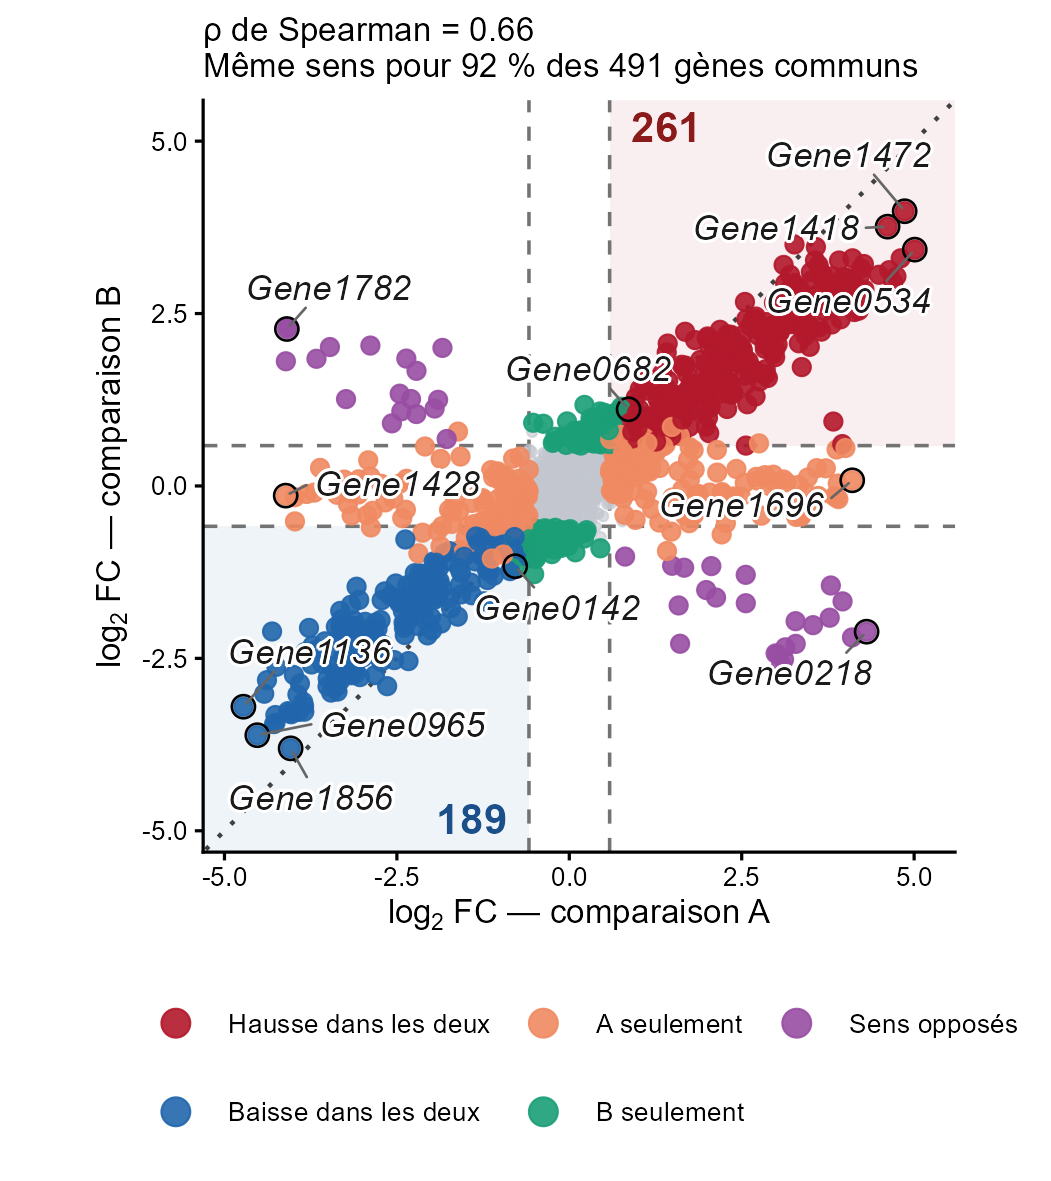
Chaque gène placé selon son log2 fold change dans deux comparaisons : ce qui varie dans les deux, dans une seule ou en sens opposés, les plus marqués nommés.
Double volcan : deux comparaisons · 5 crédits
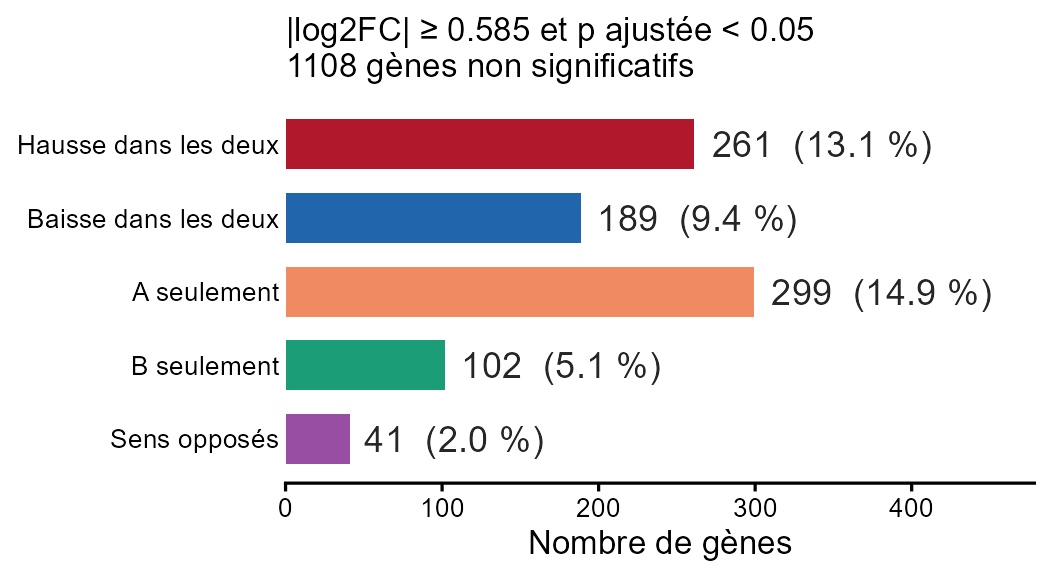
Gènes par profil
Le nombre de gènes de chaque profil (en hausse ou en baisse dans les deux comparaisons, dans une seule, en sens opposés) et leur part du total.
Double volcan : deux comparaisons · 5 crédits
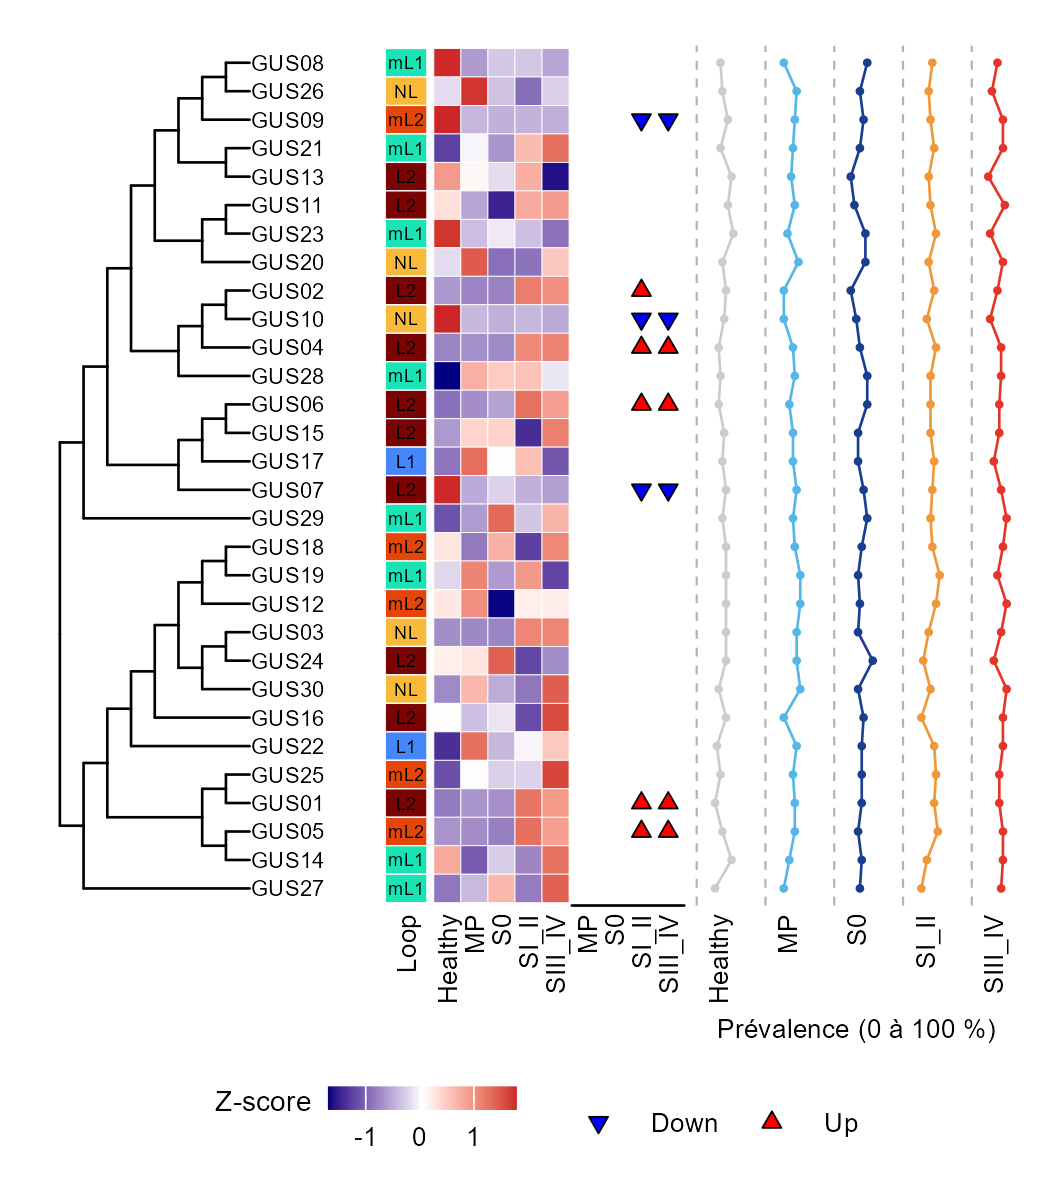
Arbre annoté : heatmap, ▲▼ et prévalence
Un arbre phylogénétique (ou une classification) et, alignés sur ses feuilles, la catégorie de chaque élément en tuiles, la heatmap des moyennes par groupe centrées-réduites, les hausses ▲ et baisses ▼ contre le groupe de référence et la prévalence dans chaque groupe, comme l’article (Nat Commun, 2025).
Arbre annoté : abondance, différences et prévalence · 5 crédits
Listes et ensembles2 figures
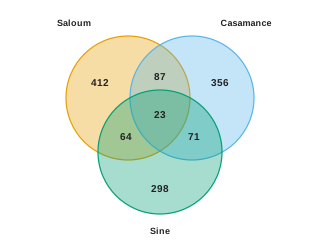
Diagramme de Venn
Deux à quatre ensembles en cercles (en ellipses pour quatre) qui se recoupent : chaque région porte le nombre d’éléments qu’elle contient (et sa part, au choix), chaque ensemble son nom et sa taille.
Ensembles : Venn et chevauchements · 5 crédits
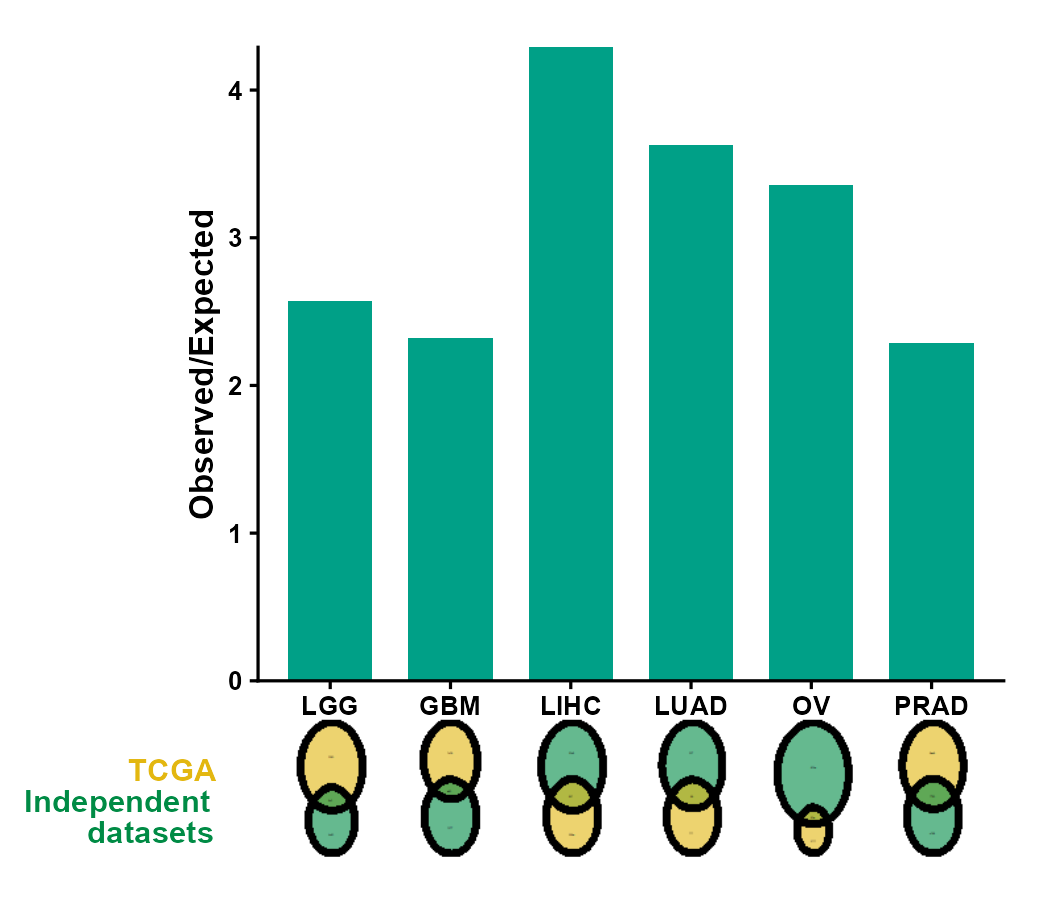
Barres + Venn de chaque groupe sous l’axe
Une barre par groupe pour le rapport entre le chevauchement observé de deux ensembles et celui que le hasard donnerait, avec les étoiles du test hypergéométrique, et sous le nom de chaque groupe le Venn de ses deux ensembles à aires proportionnelles, comme l’article (Nat Commun 2020).
Ensembles : Venn et chevauchements · 5 crédits
Classements sur plusieurs critères1 figure
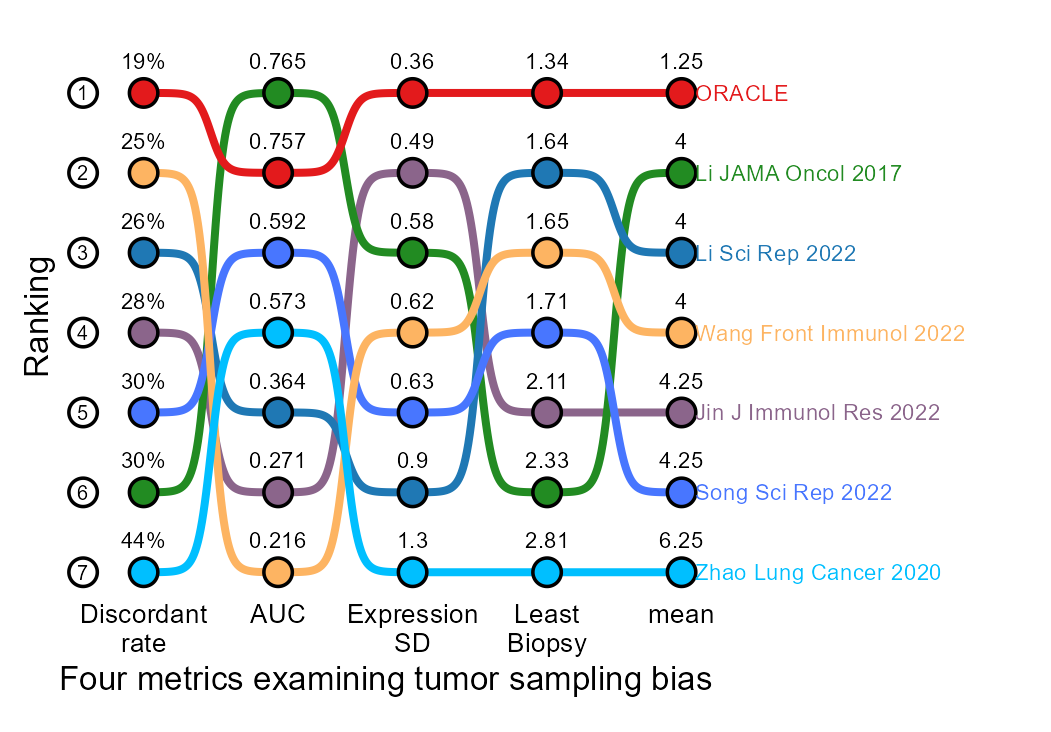
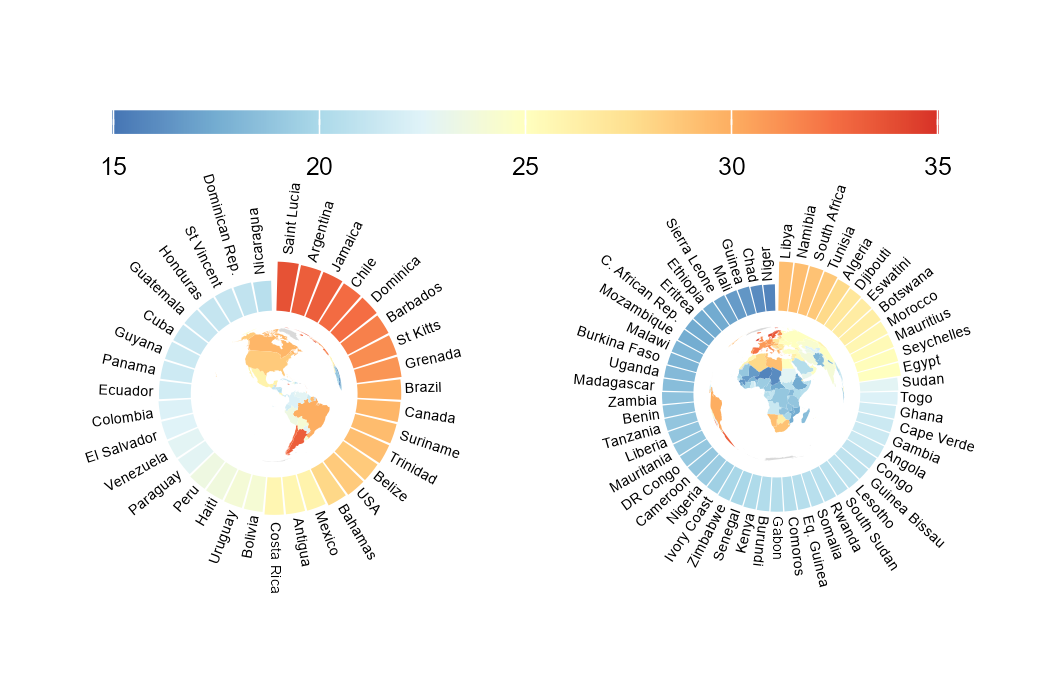
Composition des échantillons10 figures
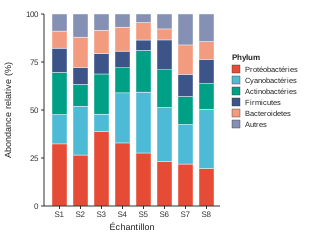
Barres empilées (%)
La composition de chaque échantillon en barre de 100 % : la part de chaque partie (espèce, genre, classe) dans le total.
Composition : abondances relatives · 5 crédits
Abondance relative + rubans
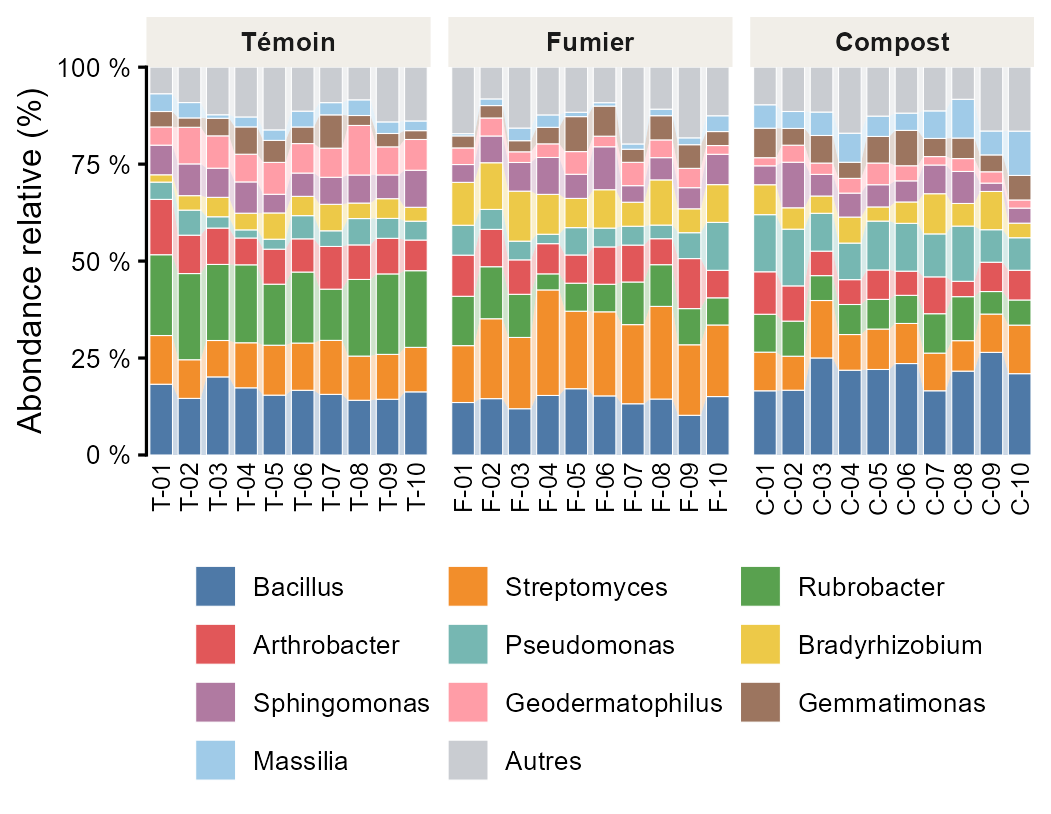
Chaque échantillon en barre de 100 %, la partie la plus abondante en bas, des rubans d’une barre à l’autre et un panneau par groupe : les changements de composition se suivent.
Composition : abondances relatives · 5 crédits
Flux de composition (alluvial)
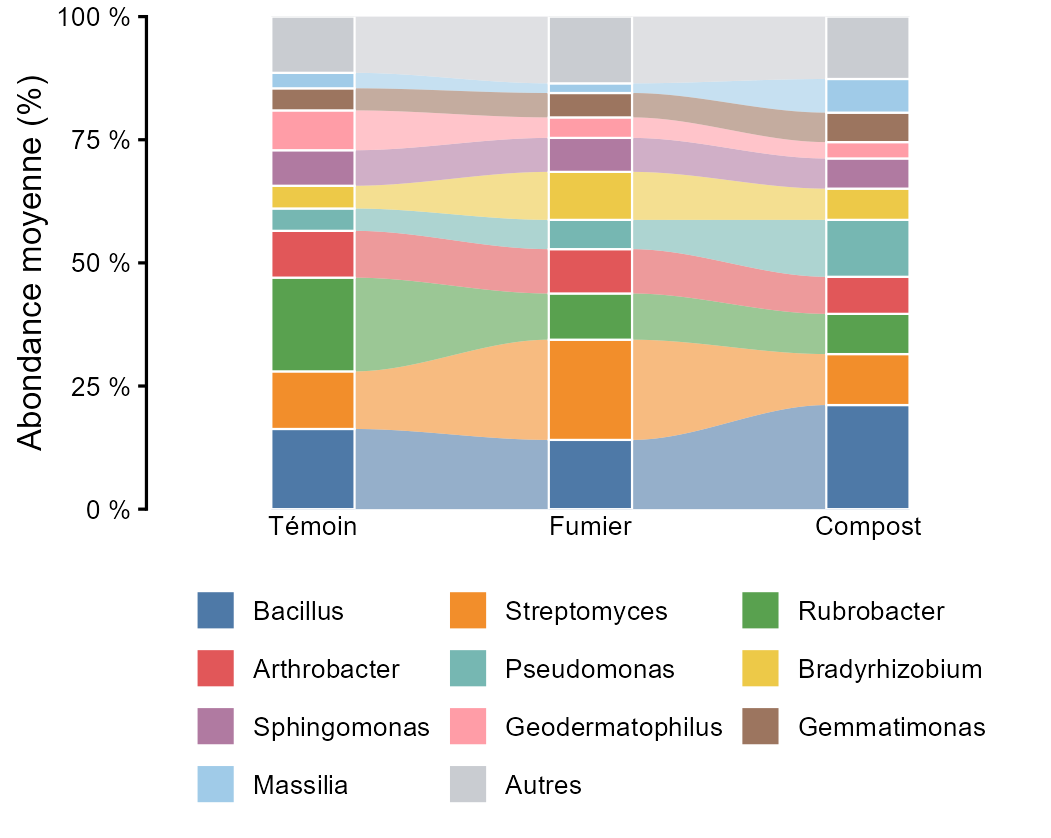
La composition moyenne de chaque groupe reliée au suivant par des courbes : la part de chaque partie qui monte ou descend d’un groupe à l’autre.
Composition : abondances relatives · 5 crédits
Alluvial le long des échantillons
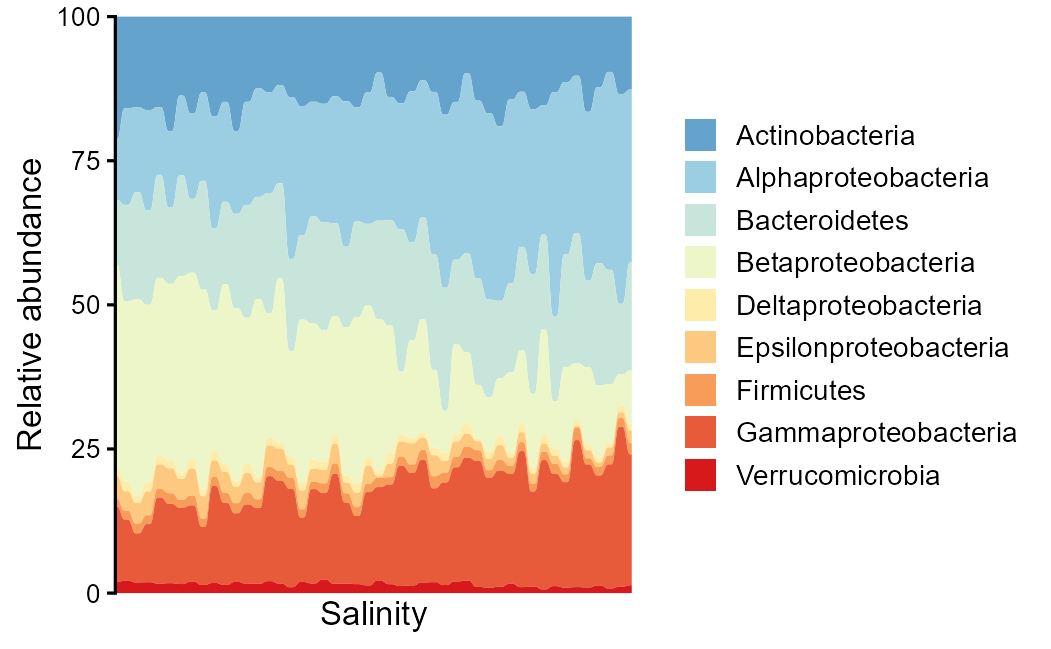
L’abondance relative des principales parties le long des échantillons, chaque partie en flux continu d’un échantillon au suivant.
Composition : abondances relatives · 5 crédits
Barres circulaires
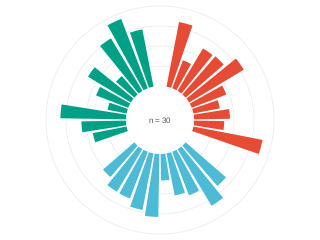
Beaucoup d’échantillons en peu de place : la composition de chacun en barre empilée disposée en cercle, les groupes séparés par un espace.
Composition : abondances relatives · 5 crédits
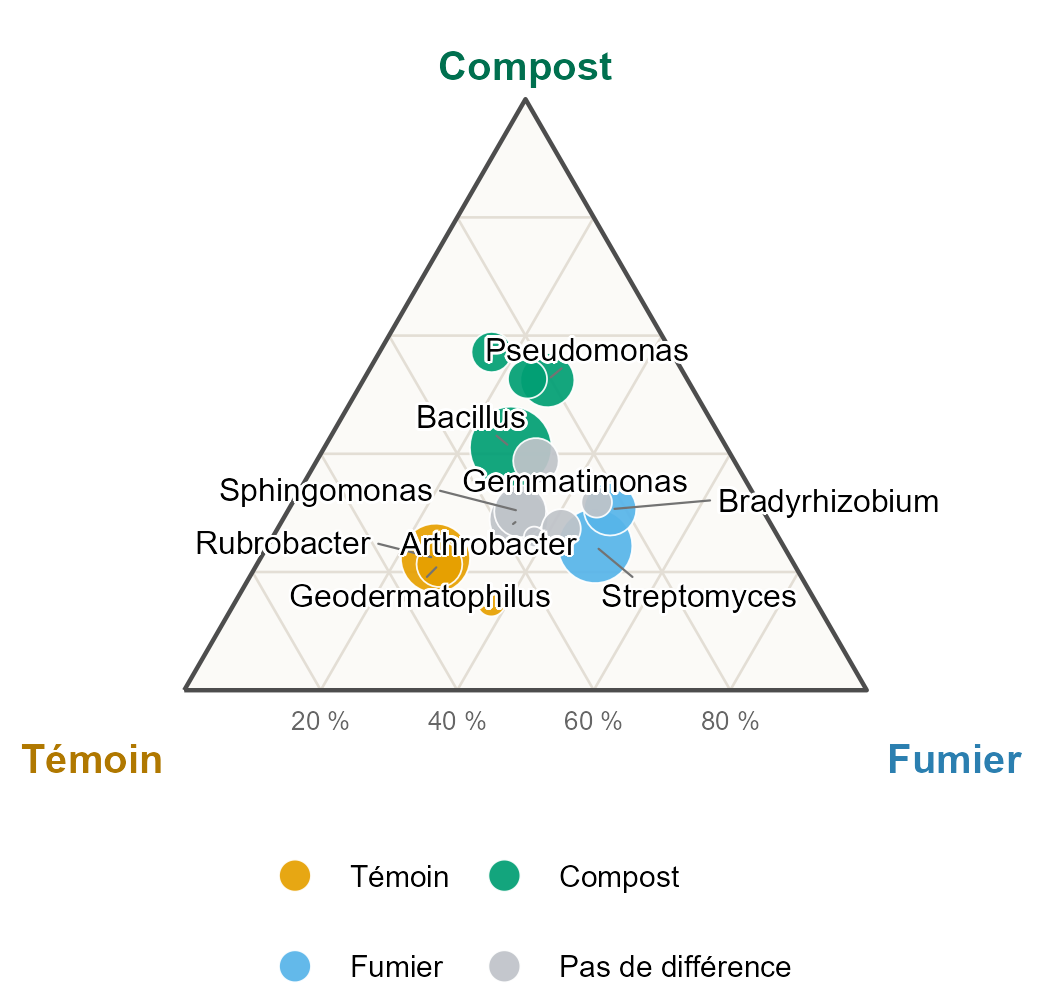
Diagramme ternaire (trois groupes)
Chaque partie placée dans un triangle selon la répartition de son abondance entre trois groupes, sa taille selon son abondance, sa couleur selon le groupe où elle est enrichie.
Composition : abondances relatives · 5 crédits
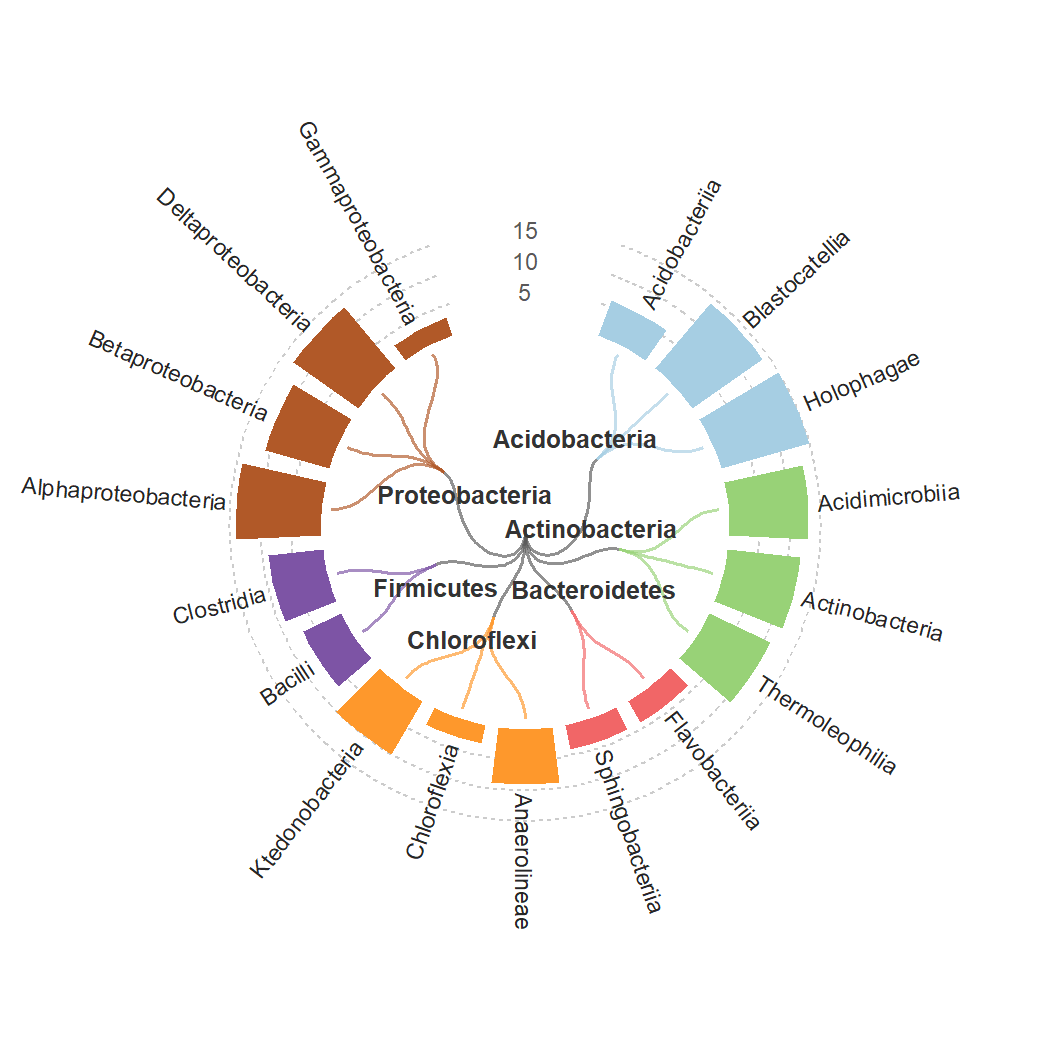
Arbre taxonomique et anneau de barres
La hiérarchie taxonomique d’une communauté en arbre circulaire, du centre vers les phylums puis les classes (ou les ordres), dans un anneau de barres : une par taxon, sa prévalence, son abondance ou son nombre d’OTU.
Arbre taxonomique circulaire · 5 crédits
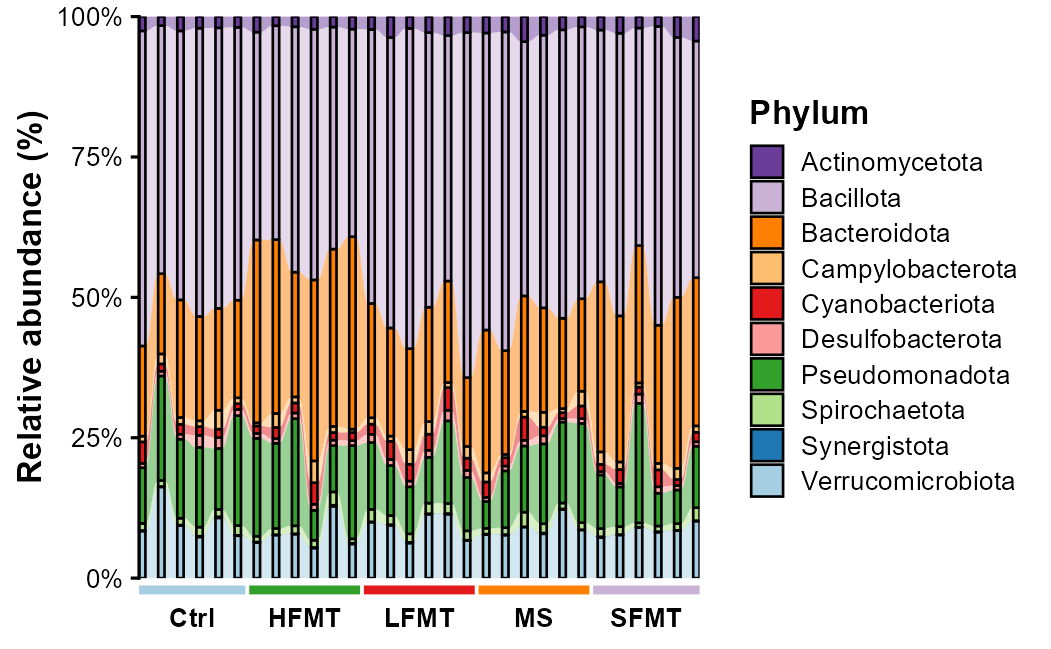
Composition 16S en flux, groupes en crochets
La composition de chaque échantillon à un rang (phylum, classe, genre…) en barres empilées à 100 %, reliées d’un échantillon à l’autre par des flux, les échantillons réunis sous un crochet de couleur par groupe, comme l’article (Microbiome, 2025).
Microbiote 16S : diversité alpha et composition · 5 crédits
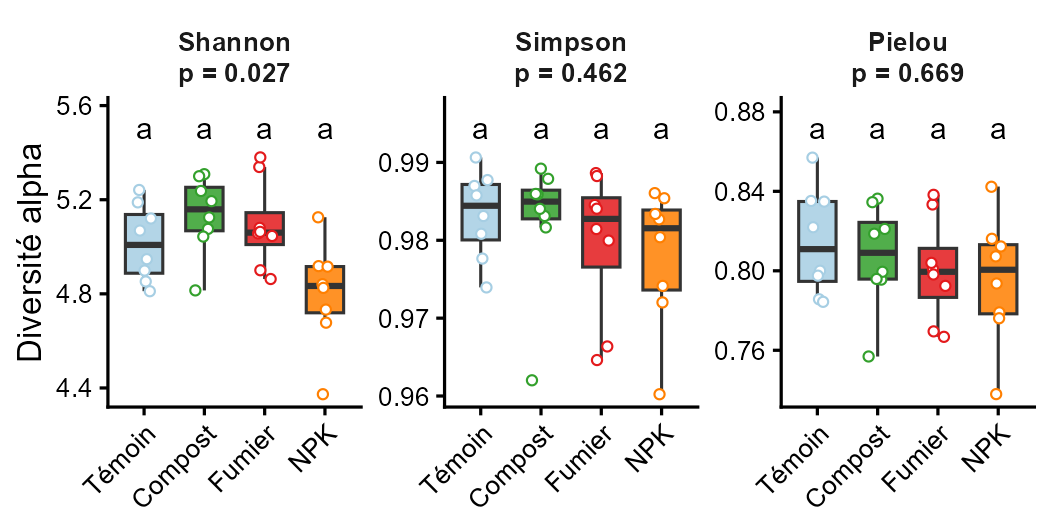
Diversité alpha par groupe + lettres
La diversité alpha de chaque échantillon (Shannon, Simpson, Pielou, et en option la richesse, Chao1 et ACE) en boîtes à moustaches par groupe, avec le test de Kruskal-Wallis et des lettres de comparaisons deux à deux.
Microbiote 16S : diversité alpha et composition · 5 crédits
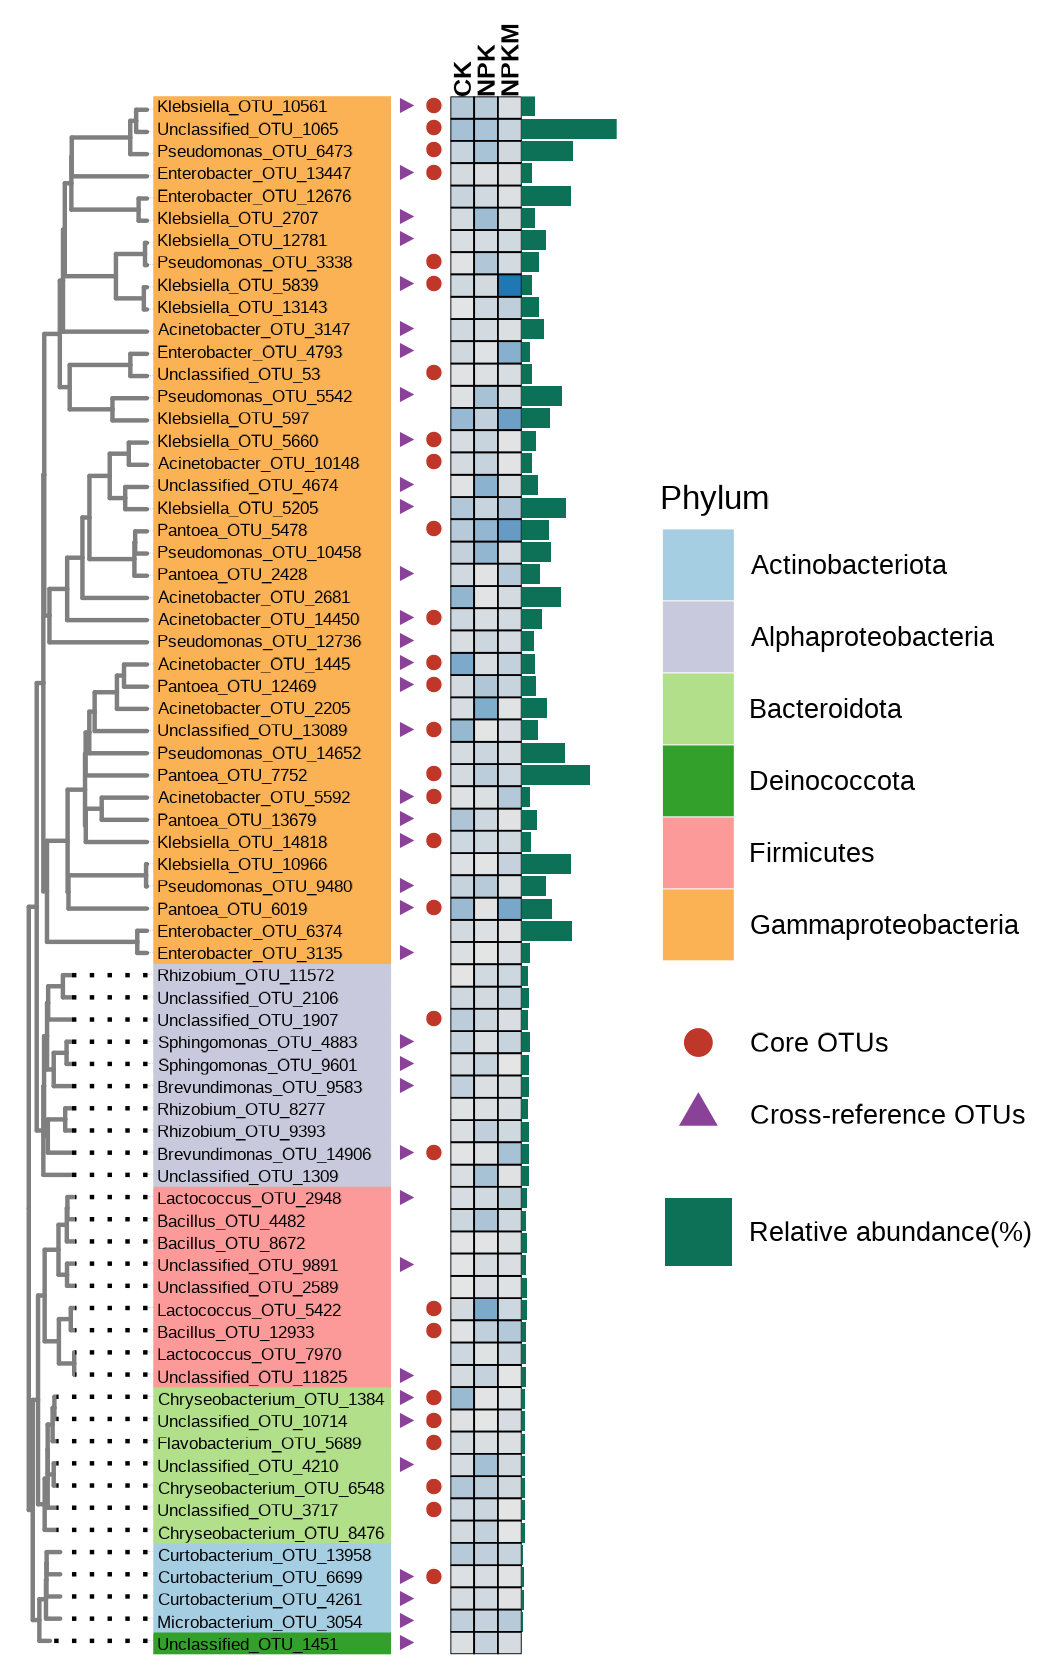
Arbre phylogénétique + panneaux alignés
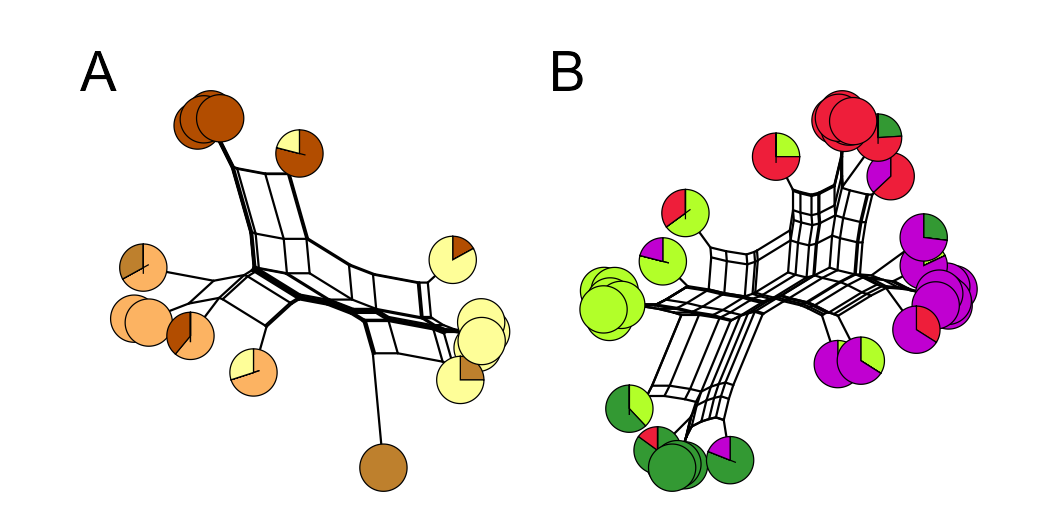
L’arbre des lignes (ggtree) et, alignés sur ses feuilles par aplot, leur catégorie en bandeau avec un nom écrit dedans, jusqu’à trois marques (● ► ■), une heatmap de quelques colonnes et une colonne en barres, comme l’article (Nat Commun).
Arbre et panneaux alignés · 5 crédits
Communautés : milieu et espace2 figures
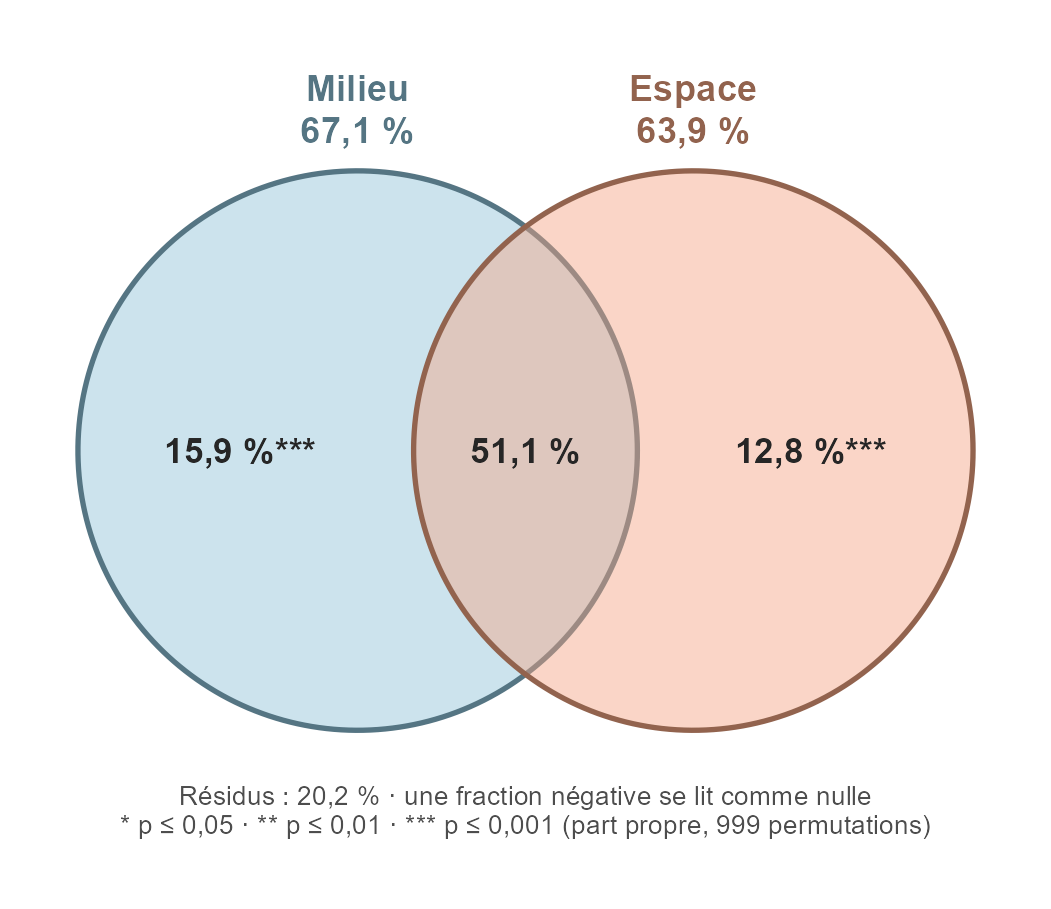
Partition de la variance (VPA)
La part de la composition en espèces expliquée par chaque bloc seul (milieu, gestion, espace), par plusieurs à la fois, et ce qui reste : des cercles qui se chevauchent.
Partition de la variance (VPA) · 5 crédits
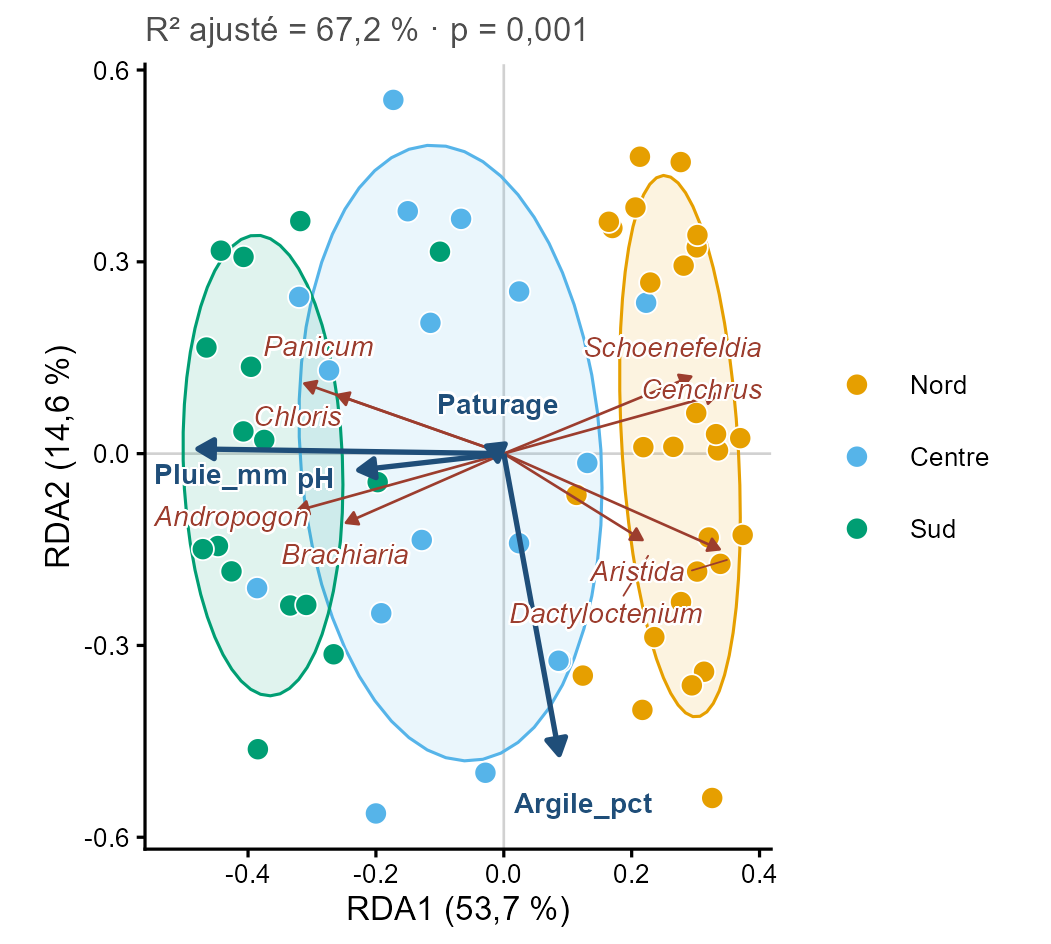
Triplot de la RDA
Les sites, les espèces et les flèches des variables explicatives sur les deux premiers axes d’une RDA : quelles espèces suivent quel facteur.
Partition de la variance (VPA) · 5 crédits
Structure de nombreuses variables8 figures
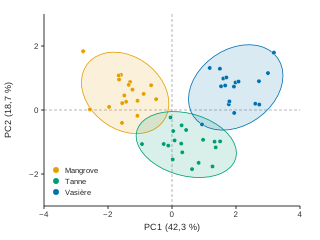
ACP avec ellipses
Une analyse en composantes principales : les observations sur les deux premiers axes, colorées par groupe avec leurs ellipses, pour voir si les groupes se séparent.
Analyse multivariée · 5 crédits
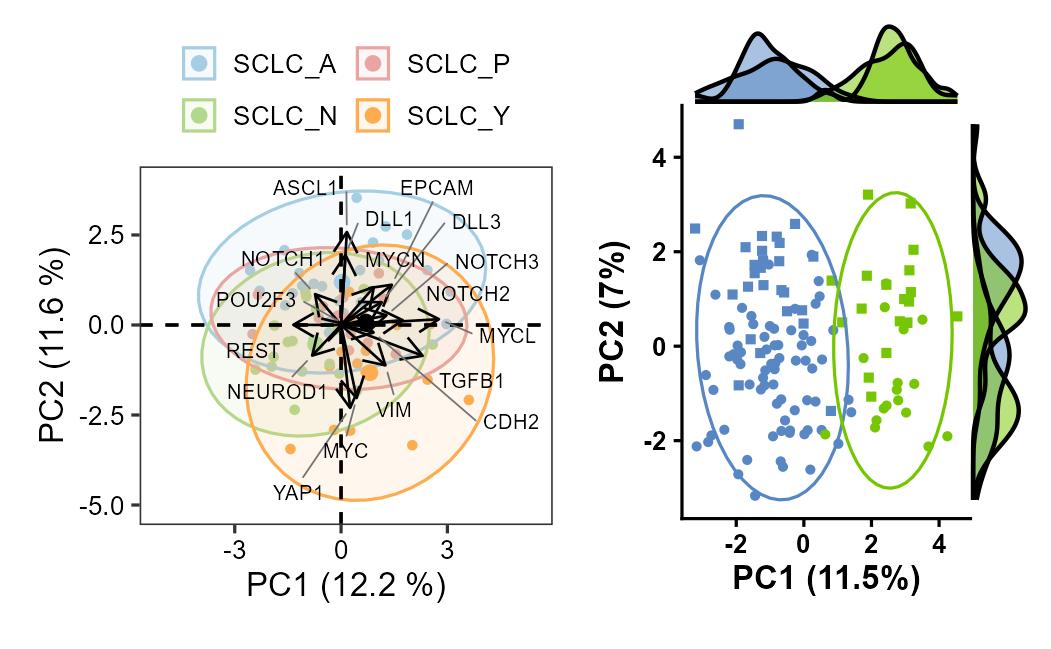
ACP : biplot de factoextra et densités des groupes en marge
Le biplot d’une ACP (observations, centre de chaque groupe, flèches des variables) avec la densité de chaque groupe en marge des deux axes.
Analyse multivariée · 5 crédits
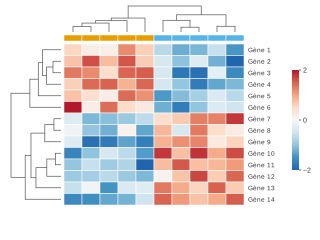
Heatmap avec clustering
Les observations en lignes et les variables en colonnes, colorées par leur valeur, regroupées par classification hiérarchique de part et d’autre : les classes qui se ressemblent.
Analyse multivariée · 5 crédits
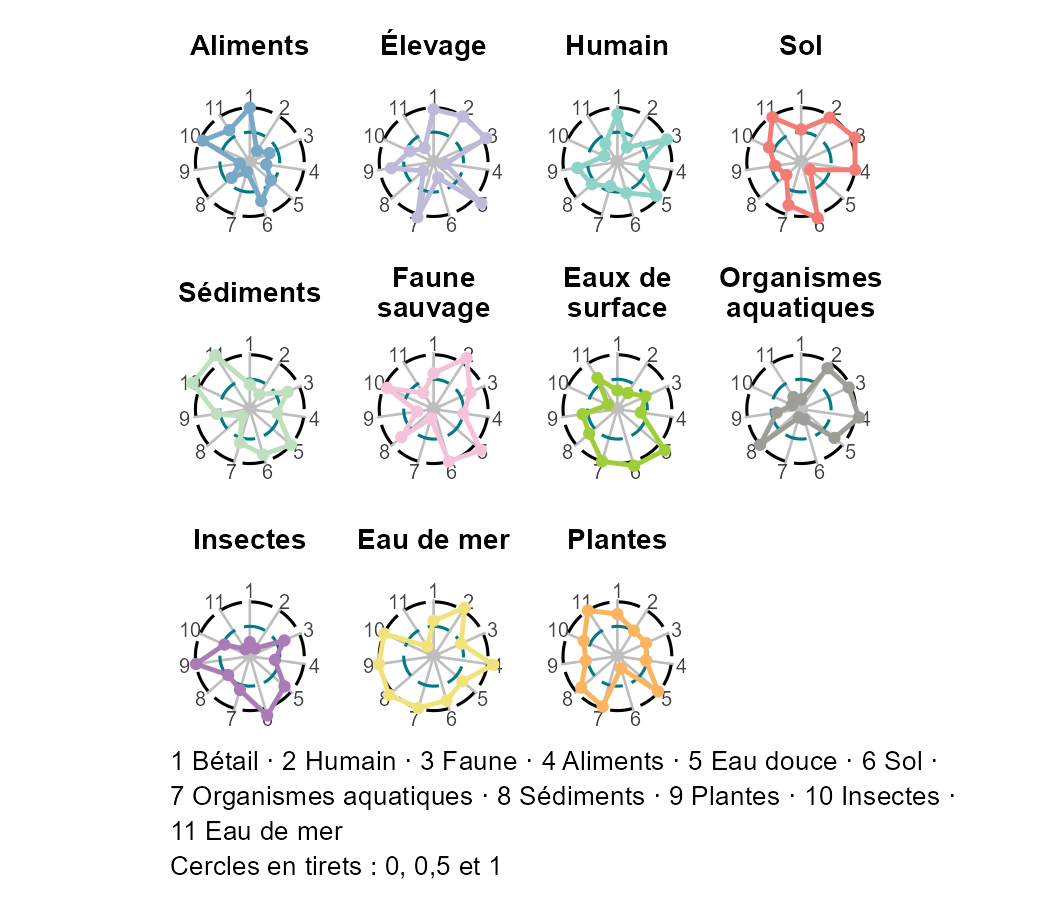
Radars des profils de groupes
Un radar par groupe, sa valeur moyenne sur chaque variable en rayon, les cercles du minimum, du milieu et du maximum en tirets : le profil de chaque groupe.
Analyse multivariée · 5 crédits
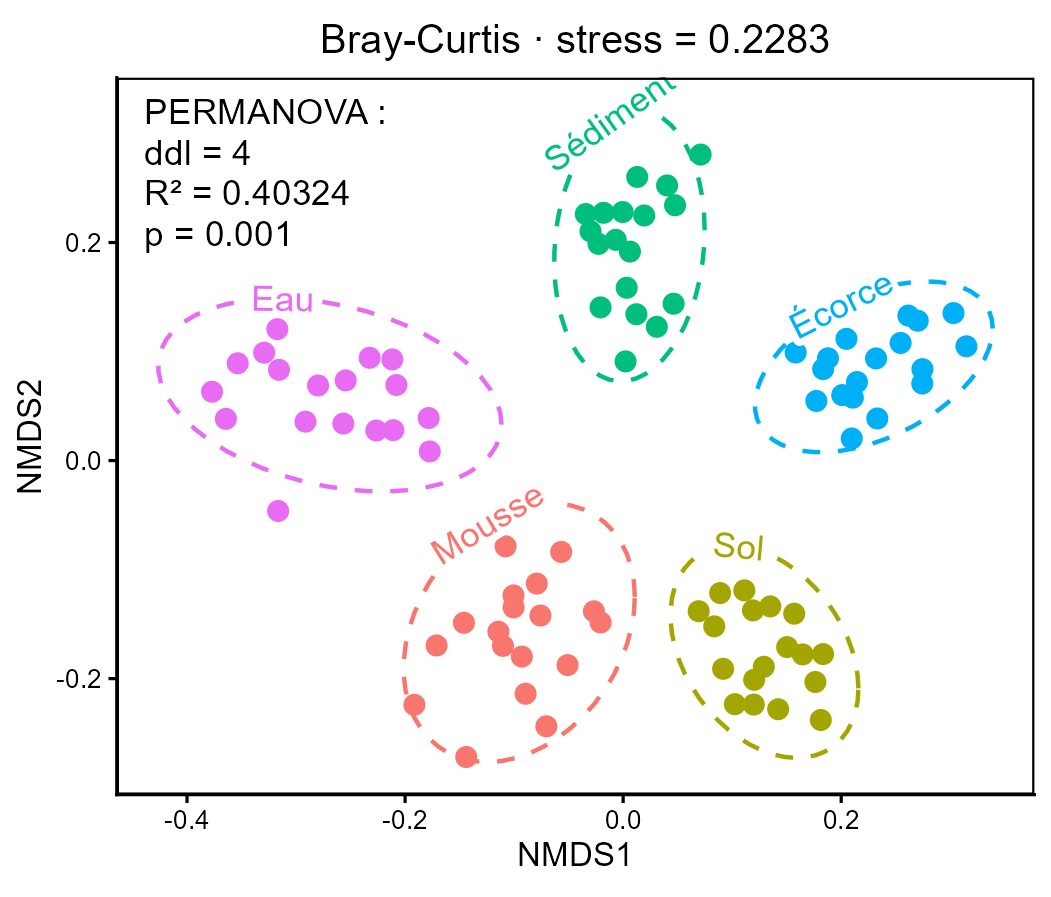
NMDS, ellipses nommées et PERMANOVA
Les échantillons ordonnés par NMDS, une ellipse de confiance par groupe qui porte son nom, le stress et la PERMANOVA : les groupes se distinguent-ils ?
Analyse multivariée · 5 crédits
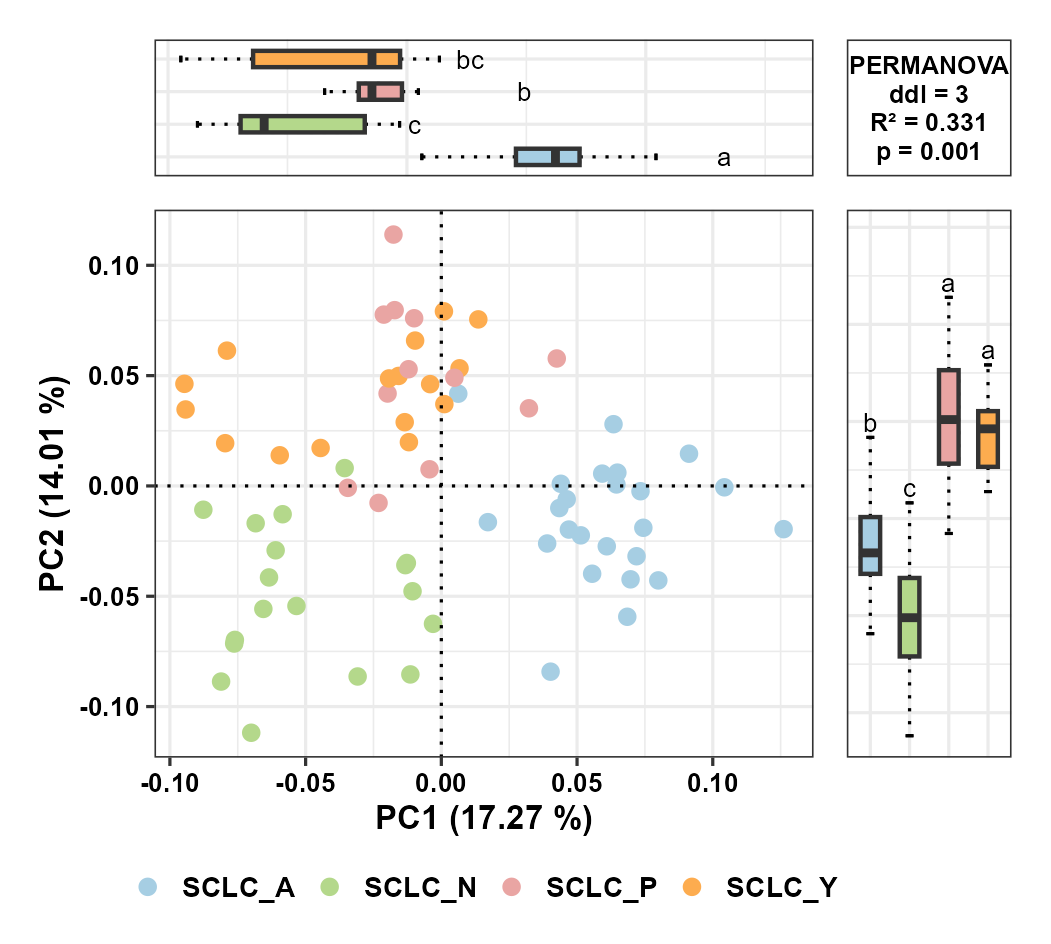
PCoA, boîtes des axes, lettres de Tukey et PERMANOVA
Une analyse en coordonnées principales (PCoA) entourée des boîtes à moustaches de chaque axe par groupe, avec les lettres de Tukey et la PERMANOVA dans l’angle.
Analyse multivariée · 5 crédits
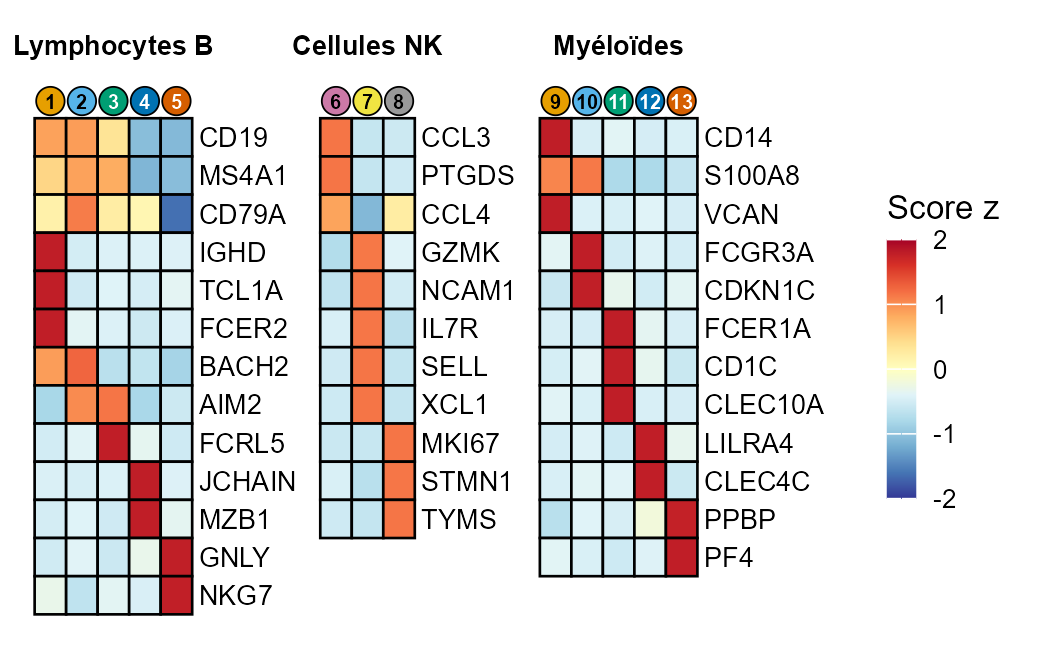
Heatmaps en blocs, colonnes numérotées
Une heatmap par bloc (lignée, famille) côte à côte sous une seule échelle, ses caractéristiques en lignes et ses échantillons en colonnes, un cercle numéroté au-dessus de chaque colonne.
Heatmap groupée · 5 crédits
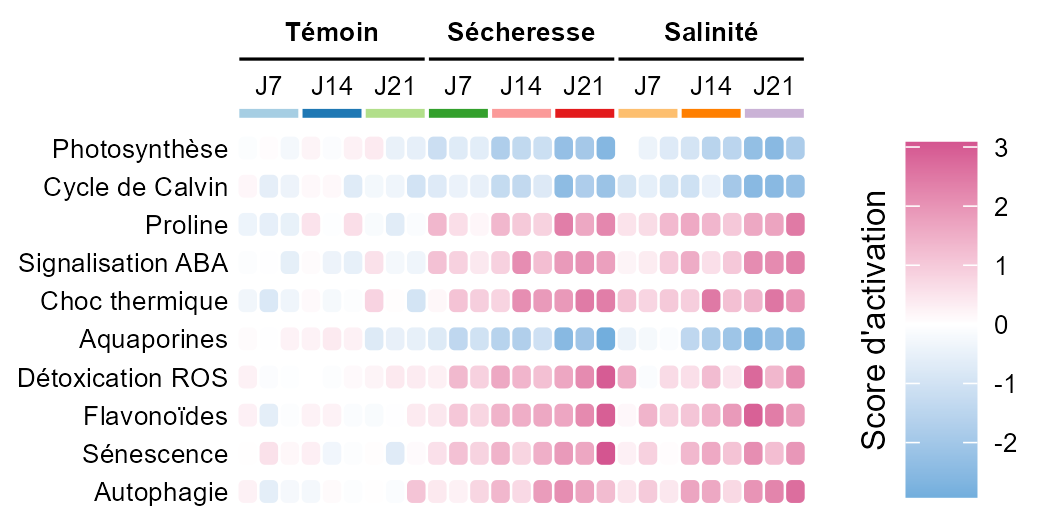
Heatmap à cases arrondies, crochets imbriqués
Une heatmap aux cases arrondies, ses caractéristiques (voies, gènes) en lignes et ses échantillons en colonnes, rangés sous deux rangées de crochets : leur groupe en couleur, le groupe qui l’englobe en gras, le dégradé bleu, blanc et rose centré sur 0, comme la figure de Nature (2025).
Heatmap groupée · 5 crédits
Données groupées ou répétées4 figures
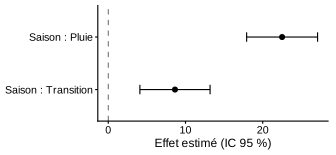
Effets fixes et IC 95 %
L’effet de chaque variable sur la réponse et son intervalle à 95 %, estimés par un modèle linéaire mixte qui tient compte des unités mesurées plusieurs fois.
Modèle linéaire mixte · 5 crédits
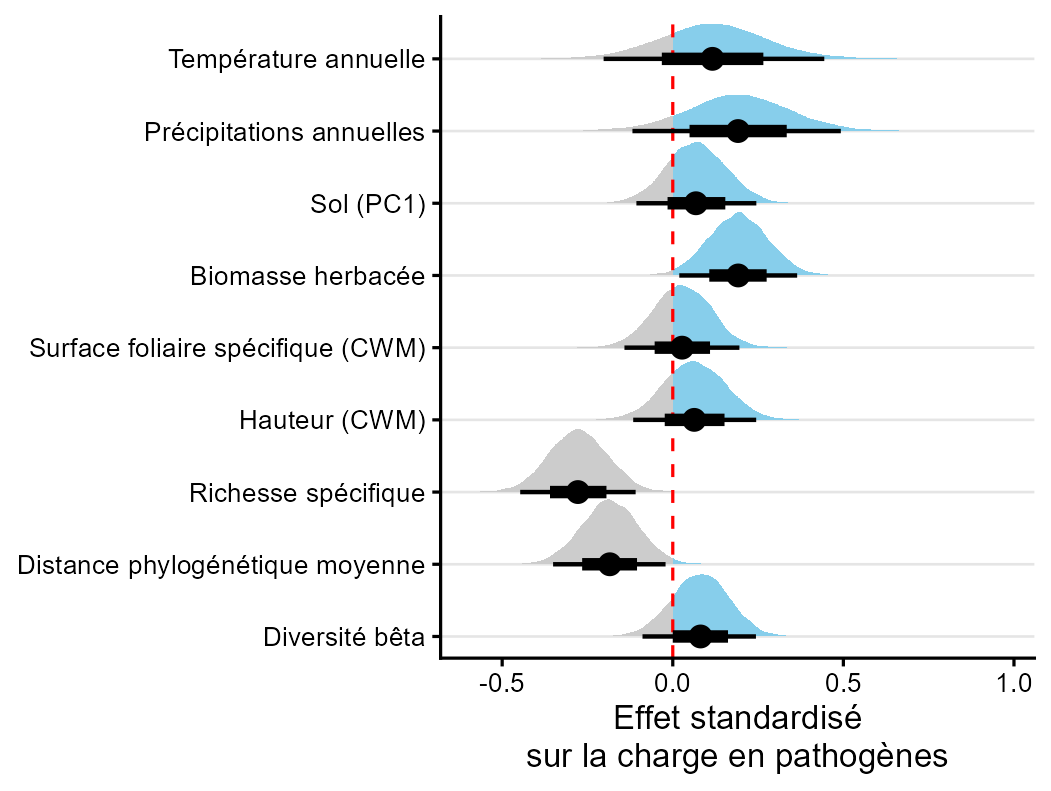
Effets a posteriori (demi-œil)
Les effets du modèle mixte estimés de façon bayésienne : la distribution a posteriori de chaque effet standardisé, d’une couleur au-dessus de 0 et d’une autre en dessous, sa médiane et ses intervalles de crédibilité.
Modèle linéaire mixte · 5 crédits
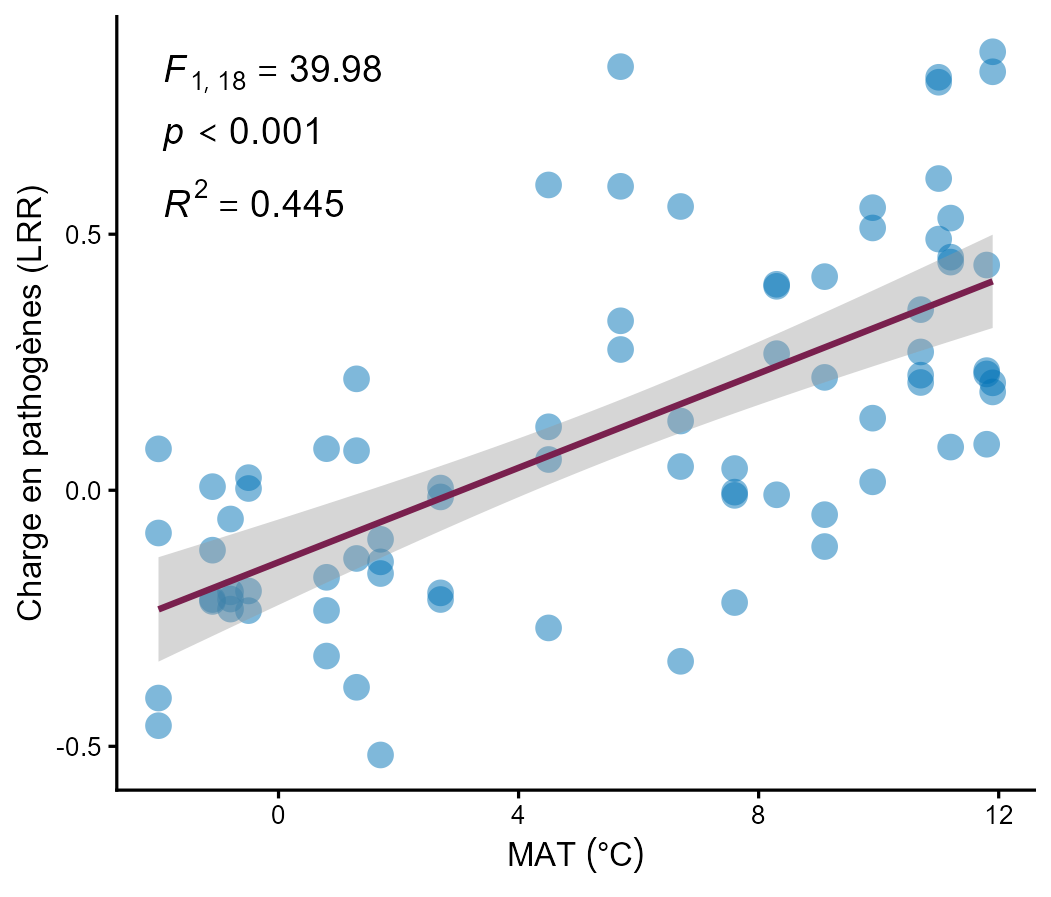
Relation, droite et F du modèle mixte
La réponse en fonction d’un effet fixe numérique : le nuage de points, la droite du modèle mixte et sa bande de confiance, avec dans l’angle le F, son p et le R² marginal.
Modèle linéaire mixte · 5 crédits
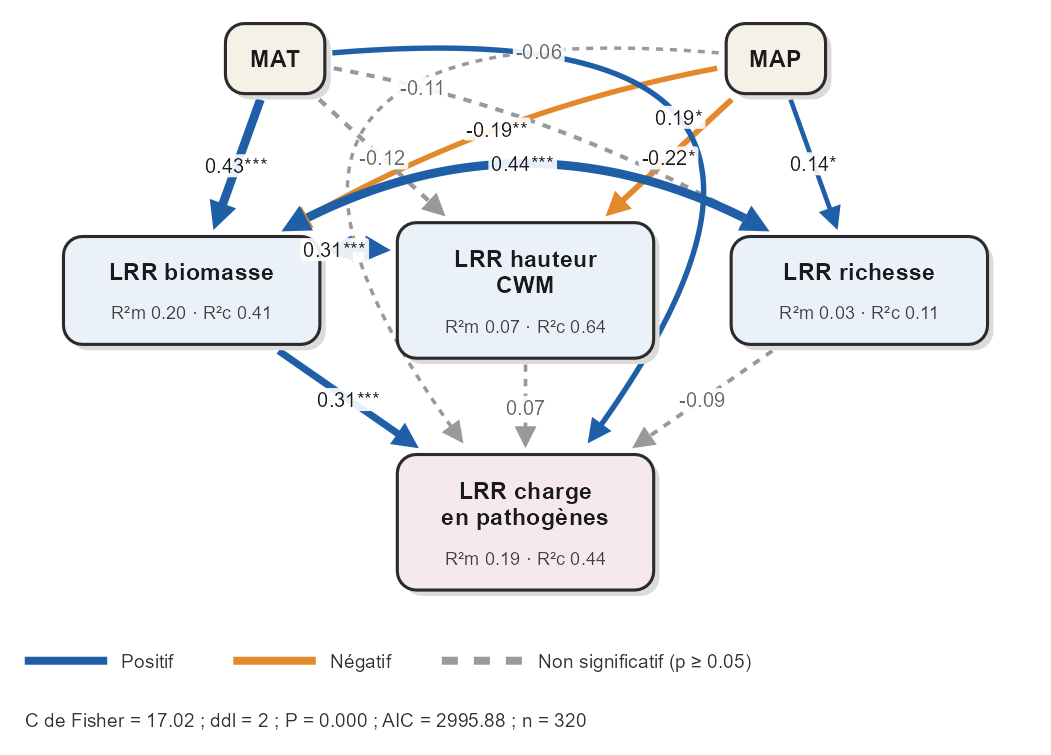
Diagramme des chemins d’un SEM par morceaux
Le diagramme des chemins d’un modèle d’équations structurelles par morceaux : des flèches colorées selon le signe, d’épaisseur selon le coefficient standardisé, en tirets quand p ≥ 0,05, le R² de chaque variable et le C de Fisher.
Modèle linéaire mixte · 5 crédits
Prédiction (machine learning)4 figures
Importance des variables
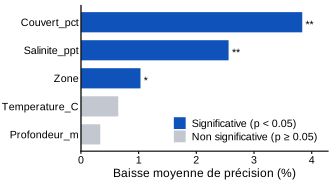
Les variables classées selon leur poids dans la prédiction d’une forêt aléatoire, celles qui en ôteraient le plus de précision en tête : en couleur les importances significatives d’après un test par permutation (étoiles), en gris les autres. En barres horizontales, sucettes, points, colonnes ou barres circulaires.
Random Forest · 5 crédits
Courbe ROC
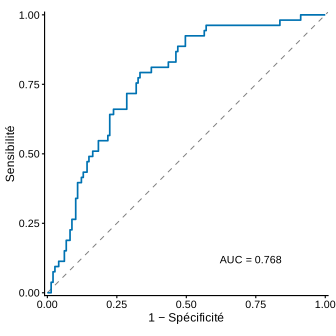
La capacité d’une forêt aléatoire à séparer deux classes (présent / absent) : la courbe ROC de ses prédictions hors échantillon et son AUC.
Random Forest · 5 crédits
Matrice de confusion
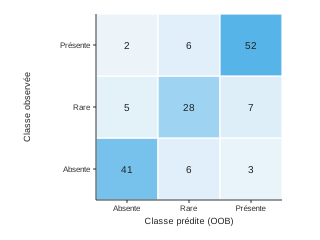
Les classes observées face aux classes prédites hors échantillon par une forêt aléatoire : où elle se trompe, et entre quelles classes.
Random Forest · 5 crédits
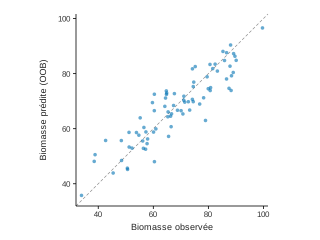
Prédit vs observé
Une forêt aléatoire de régression : les valeurs prédites hors échantillon face aux valeurs mesurées, autour de la diagonale y = x.
Random Forest · 5 crédits