Boîtes triées par médiane
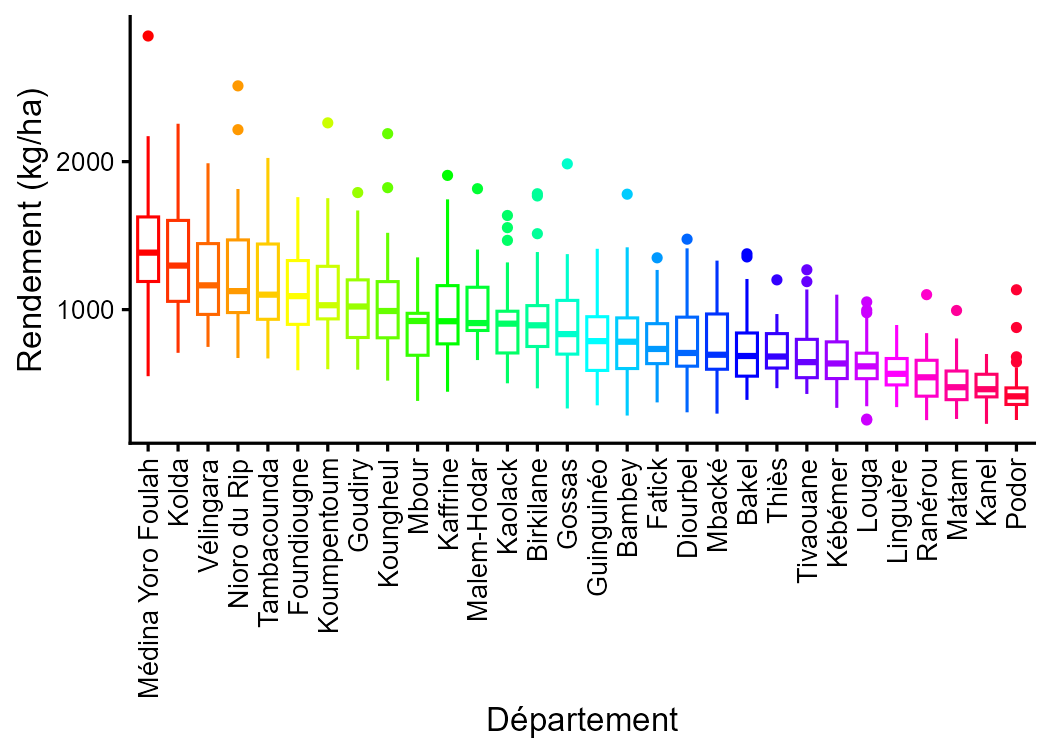
Une boîte à moustaches par groupe, de la plus haute médiane à la plus basse, chaque boîte de sa couleur le long du classement et sans légende : les noms des groupes se couchent, s’inclinent ou se redressent pour ne jamais se chevaucher. Le test de Kruskal-Wallis peut s’écrire au-dessus.
1.Définition
La figure
Une boîte à moustaches par groupe, de la plus haute médiane à la plus basse, chaque boîte de sa couleur le long du classement et sans légende : les noms des groupes se couchent, s’inclinent ou se redressent pour ne jamais se chevaucher. Le test de Kruskal-Wallis peut s’écrire au-dessus.
L’analyse statistique : Boîtes triées par médiane
Une boîte par groupe, rangées de la plus haute médiane à la plus basse : un classement lisible de dizaines de groupes (départements, variétés), avec le test de Kruskal-Wallis sur l’ensemble.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Comparer » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une ligne par observation : une colonne numérique (la mesure) et une colonne de groupe, de 2 à 40 groupes
- Une colonne d’identifiants peut rester dans le fichier, elle n’est pas lue
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Ordre : médiane décroissante, croissante ou du fichier : Décroissante pour un classement ; l’ordre du fichier si vos groupes ont un ordre naturel (dates, gradient).
- Boîtes debout ou couchées : Couchées quand les noms sont longs ou nombreux : chaque nom garde sa ligne.
- Palette et couleurs des groupes : Seize palettes de revue (Okabe-Ito lisible par les daltoniens par défaut), ou une couleur par groupe à la roue : gardez les mêmes couleurs d’une figure à l’autre de votre article.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour classer des dizaines de groupes sur une même mesure (le rendement dans 30 départements, l’expression d’un gène dans 33 types de tumeurs) et voir d’un coup d’œil les plus hauts, les plus bas et la dispersion de chacun.
Exemple de question : Dans quels départements le mil rend-il le plus, et le moins ?
Ce que les résultats montrent
- Le classement des groupes et leur dispersion.
- Si les groupes diffèrent dans leur ensemble (H, p). Pas de comparaisons deux à deux : avec des dizaines de groupes, des centaines de paires seraient illisibles.
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- plyr
- ggpubr
- stats
ddply(médiane par groupe) → ggboxplot(y ~ groupe trié) · kruskal.test(y ~ groupe)
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| ddply | plyr | ordre des groupes |
| ggboxplot | ggpubr | les boîtes |
| kruskal.test | stats | le test global |
Ce que fait le script, dans l’ordre
- Calcule pour chaque groupe n, médiane, quartiles, moyenne, écart type et moustaches de Tukey.
- Range les groupes selon l’ordre choisi (plyr::ddply comme le script d’origine).
- Teste l’ensemble par Kruskal-Wallis avec ε².
- Dessine ggpubr::ggboxplot, noms placés sans chevauchement à chaque largeur.
Formules principales
Boîte à moustaches (Tukey)
boîte = [Q₁ ; Q₃], trait = médiane, moustaches jusqu’à la dernière valeur dans Q₁ − 1,5·EIQ et Q₃ + 1,5·EIQ
EIQ = Q₃ − Q₁ (quantiles de type 7, ceux de ggplot2). La moitié centrale des valeurs est dans la boîte ; les points au-delà des moustaches sont des valeurs extrêmes.
Kruskal-Wallis
H = 12 / (N(N + 1)) · Σ nⱼ R̄ⱼ² − 3(N + 1)
R̄ⱼ est le rang moyen du groupe j parmi les N valeurs. H suit un χ² à k − 1 ddl : p < α, au moins un groupe a des valeurs plus hautes ou plus basses. Taille d’effet ε² = H(N + 1)/(N² − 1).
À citer
- McGill, R., Tukey, J. W. & Larsen, W. A. (1978). Variations of box plots. The American Statistician, 32(1), 12-16. doi:10.1080/00031305.1978.10479236 (nouvel onglet)
- Kruskal, W. H. & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583-621. doi:10.1080/01621459.1952.10483441 (nouvel onglet)
- Wickham, H. (2011). The split-apply-combine strategy for data analysis. Journal of Statistical Software, 40(1), 1-29. doi:10.18637/jss.v040.i01 (nouvel onglet)
5.Données d’entrée
Une ligne par observation : une colonne numérique et une colonne de groupe (2 à 40 groupes).
Ce que la figure demande
- Une ligne par observation : une colonne numérique (la mesure) et une colonne de groupe, de 2 à 40 groupes
- Une colonne d’identifiants peut rester dans le fichier, elle n’est pas lue
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Rendement du mil dans 30 départements
Rôles : Rendement_kgha de 1 410 parcelles, une boîte par Departement triée par médiane ; la colonne Parcelle (identifiant) n’est pas lue.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (mil_departements.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Boîtes triées par médiane » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.