Heatmaps en blocs, colonnes numérotées
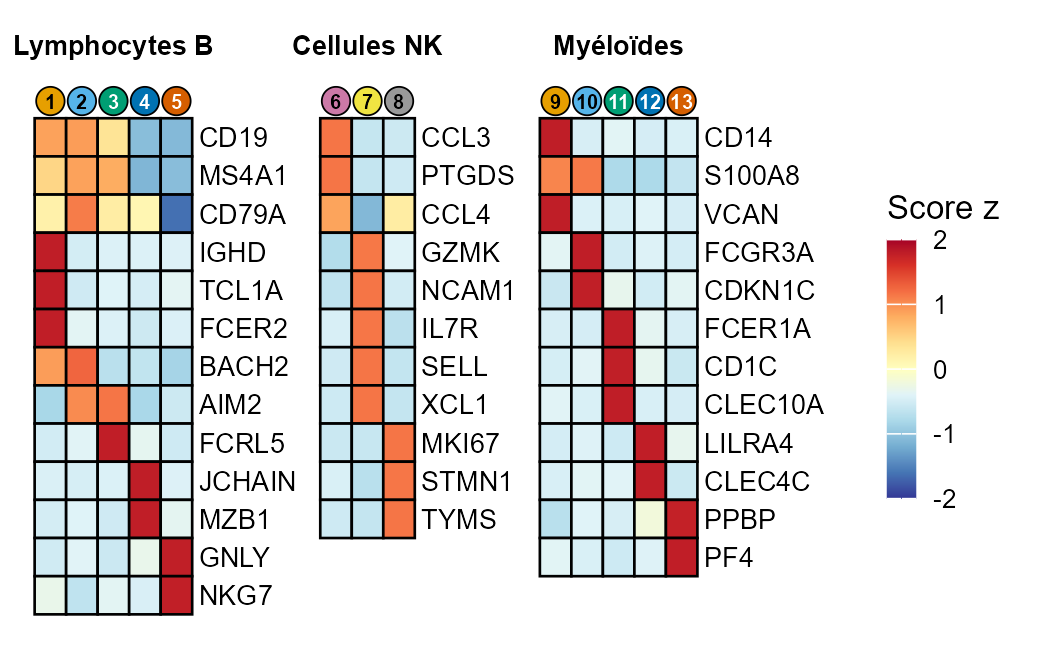
Une heatmap par bloc (lignée, famille) côte à côte sous une seule échelle, ses caractéristiques en lignes et ses échantillons en colonnes, un cercle numéroté au-dessus de chaque colonne.
1.Définition
La figure
Une heatmap par bloc (lignée, famille) côte à côte sous une seule échelle, ses caractéristiques en lignes et ses échantillons en colonnes, un cercle numéroté au-dessus de chaque colonne.
L’analyse statistique : Heatmap groupée
Une heatmap d’un tableau long (caractéristique × échantillon), les échantillons réunis par groupe en blocs ou sous des crochets emboîtés, les valeurs en score z par caractéristique.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Multivarié » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Un tableau long : caractéristique, échantillon et valeur
- Les groupes des caractéristiques et des échantillons
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Disposition : grille, blocs ou crochets emboîtés : Les blocs donnent à chaque groupe ses propres caractéristiques ; les crochets emboîtés montrent deux niveaux de groupes (traitement > jour).
- Échelle : 0–1, observée ou score z : Le score z par caractéristique compare chaque ligne à sa propre moyenne : pour des valeurs d’ordres de grandeur différents.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour des données en format long (élément × échantillon) réparties en blocs (lignées, familles) : comparer des profils d’expression ou de marqueurs.
Exemple de question : Quels gènes marquent chaque type cellulaire, dans les lymphocytes B, les NK et les myéloïdes ?
Ce que les résultats montrent
- Quelles caractéristiques (gènes, voies, marqueurs) sont hautes ou basses dans quels groupes d’échantillons.
- Des motifs qui se répètent d’un groupe à l’autre, ou propres à un groupe.
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- ggplot2
- ggh4x
- ggforce
- legendry
valeur ~ caractéristique × échantillon
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| geom_tile | ggplot2 | les cases |
| facet_wrap2, force_panelsizes | ggh4x | blocs proportionnés |
| geom_shape | ggforce | cases arrondies |
| guide_axis_nested | legendry | crochets emboîtés |
Ce que fait le script, dans l’ordre
- Vérifie qu’une paire caractéristique × échantillon n’apparaît qu’une fois.
- Calcule l’échelle choisie (score z saturé à ±2).
- Range les colonnes par groupe et dessine les cases (ggplot2, ggh4x, ggforce), bandeaux et crochets.
Formules principales
Score z par caractéristique
zᵢⱼ = (xᵢⱼ − x̄ᵢ) / sᵢ
Combien d’écarts types l’échantillon j est au-dessus (rouge) ou au-dessous (bleu) de la moyenne de la caractéristique i.
À citer
- Wickham, H. (2016). ggplot2: elegant graphics for data analysis. Springer (Use R!), 2ᵉ éd.. doi:10.1007/978-3-319-24277-4 (nouvel onglet)
5.Données d’entrée
Tableau long : une ligne par paire caractéristique × échantillon (caractéristique, échantillon, groupe, valeur ; catégorie facultative).
Ce que la figure demande
- Un tableau long : caractéristique, échantillon et valeur
- Les groupes des caractéristiques et des échantillons
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Marqueurs des cellules immunitaires
Rôles : Gene en lignes, Type_cellulaire en colonnes numérotées, un bloc par Lignee, Expression en score z.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (marqueurs_cellules.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Heatmaps en blocs, colonnes numérotées » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.