Composition 16S en flux, groupes en crochets
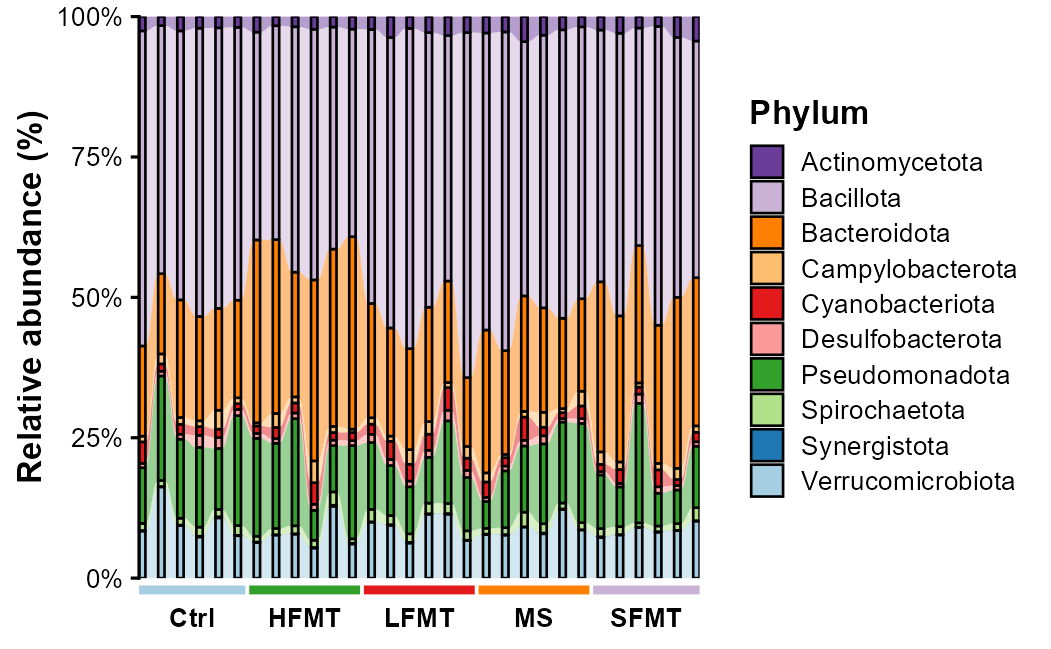
La composition de chaque échantillon à un rang (phylum, classe, genre…) en barres empilées à 100 %, reliées d’un échantillon à l’autre par des flux, les échantillons réunis sous un crochet de couleur par groupe, comme l’article (Microbiome, 2025).
Composition des échantillons · Microbiote 16S : diversité alpha et composition · 5 crédits
Lancer cette figure (nouvel onglet)1.Définition
La figure
La composition de chaque échantillon à un rang (phylum, classe, genre…) en barres empilées à 100 %, reliées d’un échantillon à l’autre par des flux, les échantillons réunis sous un crochet de couleur par groupe, comme l’article (Microbiome, 2025).
L’analyse statistique : Microbiote 16S : diversité alpha et composition
Le microbiote 16S en deux figures : la diversité alpha de chaque échantillon (Shannon, Simpson, Chao1…) comparée entre groupes, et la composition en flux alluviaux des taxons dominants.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Composition » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Ajouter les fichiers complémentaires
Cette figure lit, en plus du tableau principal :
- Groupes des échantillons : Une ligne par échantillon : son nom, écrit comme en tête des colonnes du fichier principal, et son groupe (traitement, stade, site…).
- Taxonomie : Une ligne par ASV ou OTU : son identifiant, comme dans le fichier principal, puis une colonne par rang (Règne, Phylum, Classe…) ou une chaîne « d__Bacteria;p__… ».
Pourquoi : Les identifiants doivent s’écrire exactement comme dans le fichier principal : c’est par eux que les fichiers se rejoignent.
Étape 4 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 5 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- La table d’ASV ou d’OTU : une ligne par ASV, son identifiant et une colonne de comptages par échantillon
- Un fichier « Groupes des échantillons » : le nom de chaque échantillon et son groupe
- La taxonomie des ASV : un fichier à part (identifiant, Kingdom, Phylum…) ou des colonnes de la table
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 6 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Indices de diversité : Shannon et Simpson combinent richesse et équitabilité ; Chao1 et ACE estiment la richesse réelle (comptages entiers nécessaires).
- Raréfaction : Désactivée par défaut : elle jette des séquences. Utile quand les profondeurs de séquençage diffèrent beaucoup.
- Rang taxonomique et nombre de taxons (alluvial) : Le phylum ou le genre ; 20 taxons par défaut, les autres réunis sous « Autres ».
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 7 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 8 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 9 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour montrer ce qui compose le microbiote de chaque échantillon séquencé (16S, ITS) et comment la composition change d’un groupe à l’autre, échantillon par échantillon.
Exemple de question : Les feuilles de moringa, un probiotique ou un antibiotique changent-ils la composition du microbiote du cæcum ?
Ce que les résultats montrent
- Si la diversité diffère entre groupes (Kruskal-Wallis, lettres).
- Quels taxons dominent chaque échantillon et comment la composition change d’un groupe à l’autre.
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- vegan
- stats
- ggalluvial
- legendry
vegan::diversity / specnumber / estimateR · kruskal.test(indice ~ groupe) · geom_alluvium + guide_axis_nested
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| diversity, specnumber, estimateR, rrarefy | vegan | indices et raréfaction |
| kruskal.test, wilcox.test | stats | tests |
| geom_alluvium, geom_stratum | ggalluvial | flux alluviaux |
| guide_axis_nested | legendry | crochets des groupes |
Ce que fait le script, dans l’ordre
- Lit la table d’ASV et le fichier des groupes ; met à 0 les cases vides.
- Calcule les indices de diversité (vegan), raréfie en option.
- Teste les groupes par Kruskal-Wallis, puis Wilcoxon ou Dunn, p ajustées BH, lettres.
- Pour l’alluvial : ramène chaque ASV à sa part, additionne par taxon, garde les dominants, dessine ggalluvial.
Formules principales
Indice de Shannon
H = −Σ pᵢ ln pᵢ ; Pielou J = H / ln S
pᵢ est la part de l’ASV i, S la richesse. H grand : beaucoup d’espèces bien réparties.
Indice de Simpson
D = 1 − Σ pᵢ²
La probabilité que deux séquences tirées au hasard viennent d’ASV différents.
Chao1
S_Chao1 = S_obs + F₁² / (2 F₂)
F₁ et F₂ comptent les ASV vus une et deux fois : estime les espèces non encore vues.
À citer
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379-423. doi:10.1002/j.1538-7305.1948.tb01338.x (nouvel onglet)
- Simpson, E. H. (1949). Measurement of diversity. Nature, 163, 688. doi:10.1038/163688a0 (nouvel onglet)
- Pielou, E. C. (1966). The measurement of diversity in different types of biological collections. Journal of Theoretical Biology, 13, 131-144. doi:10.1016/0022-5193(66)90013-0 (nouvel onglet)
- Chao, A. (1984). Nonparametric estimation of the number of classes in a population. Scandinavian Journal of Statistics, 11(4), 265-270. PubMed (nouvel onglet)
- Kruskal, W. H. & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583-621. doi:10.1080/01621459.1952.10483441 (nouvel onglet)
- Brunson, J. C. (2020). ggalluvial: layered grammar for alluvial plots. Journal of Open Source Software, 5(49), 2017. doi:10.21105/joss.02017 (nouvel onglet)
5.Données d’entrée
Une ligne par ASV et une colonne de comptages par échantillon, plus le fichier complémentaire des groupes (et la taxonomie pour l’alluvial).
Ce que la figure demande
- La table d’ASV ou d’OTU : une ligne par ASV, son identifiant et une colonne de comptages par échantillon
- Un fichier « Groupes des échantillons » : le nom de chaque échantillon et son groupe
- La taxonomie des ASV : un fichier à part (identifiant, Kingdom, Phylum…) ou des colonnes de la table
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Microbiote du cæcum de poulets de chair
Rôles : 776 ASV dans 30 cæcums (P01 à P30), leur taxonomie dans un deuxième fichier (Kingdom, Phylum…) et le régime de chaque poulet dans un troisième (6 par régime).
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (poulets_caecum_asv.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Composition 16S en flux, groupes en crochets » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.