Barres imbriquées : lettres et étoiles
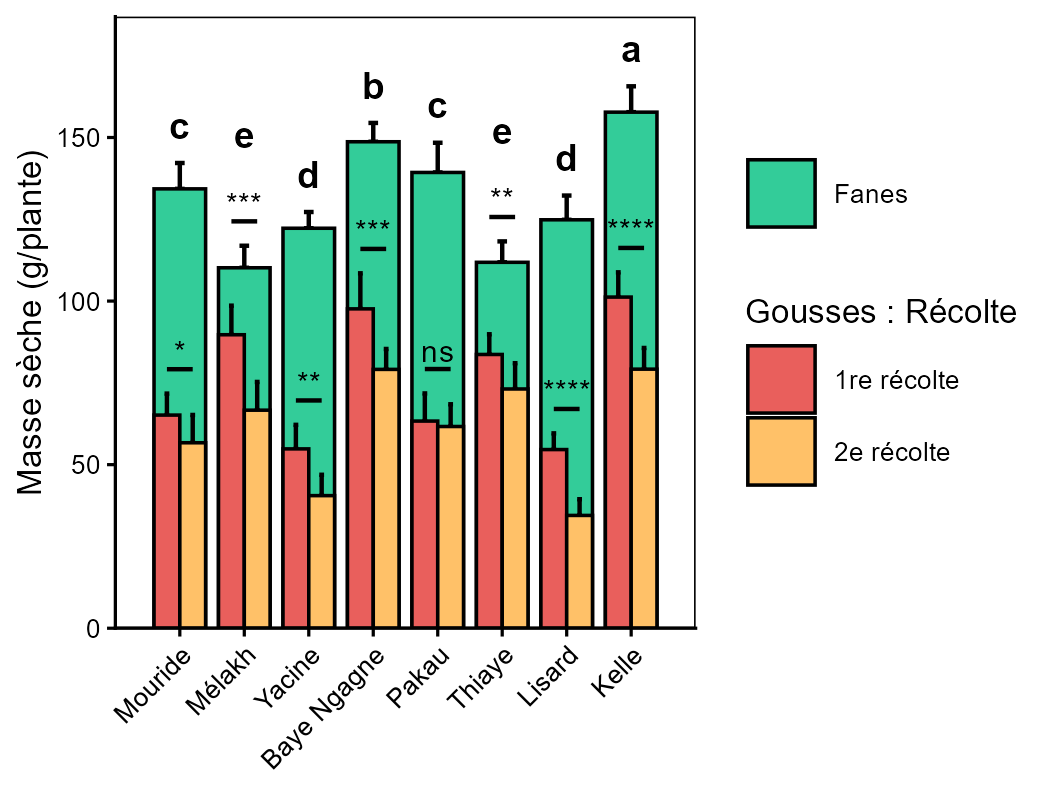
Une barre large par groupe pour une première mesure (moyenne ± écart-type) avec ses lettres (ANOVA puis LSD de Fisher corrigé par Bonferroni, agricolae) ; dedans, une barre par période pour une seconde mesure, les périodes de chaque groupe comparées par Wilcoxon (rstatix, p ajustées par Holm) et reliées par un trait étoilé, comme le script. Chaque trait reste dans sa barre large s’il tient sous son bord, sinon il passe au-dessus de sa moustache ; la lettre se pose au-dessus de tout.
Comparaison de groupes · Barres imbriquées : lettres et étoiles · 5 crédits
Lancer cette figure (nouvel onglet)1.Définition
La figure
Une barre large par groupe pour une première mesure (moyenne ± écart-type) avec ses lettres (ANOVA puis LSD de Fisher corrigé par Bonferroni, agricolae) ; dedans, une barre par période pour une seconde mesure, les périodes de chaque groupe comparées par Wilcoxon (rstatix, p ajustées par Holm) et reliées par un trait étoilé, comme le script. Chaque trait reste dans sa barre large s’il tient sous son bord, sinon il passe au-dessus de sa moustache ; la lettre se pose au-dessus de tout.
L’analyse statistique : Barres imbriquées : lettres et étoiles
Des barres larges (moyenne d’une mesure par groupe, avec ses lettres) et, dedans, les barres d’une seconde mesure par période avec les étoiles de leur comparaison : deux questions sur une seule figure.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Comparer » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 4 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une ligne par observation : une colonne de groupe (2 à 12), une colonne de période (2 à 4) et deux colonnes numériques, aucune moyenne négative
- Les autres colonnes (identifiant…) peuvent rester dans le fichier, elles ne sont pas lues
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 5 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Test des lettres : LSD, Tukey, Duncan ou Kruskal : LSD avec Bonferroni (défaut, le script d’origine) ; Tukey plus prudent ; Kruskal pour des données asymétriques.
- Paires de périodes : toutes, successives ou contre la première : Contre la première quand elle est la référence (avant traitement).
- Moustaches : écart type, erreur type ou aucune : L’écart type montre la dispersion des données, l’erreur type la précision de la moyenne : dites lequel dans la légende.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 6 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 7 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 8 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour montrer deux mesures qui se lisent l’une dans l’autre (un total et sa part : fanes et gousses, biomasse et rendement) dans plusieurs groupes, et comment la seconde change d’une période à l’autre dans chacun.
Exemple de question : Quelles variétés de niébé donnent le plus de fanes, et dans chacune, la première récolte de gousses pèse-t-elle plus que la seconde ?
Ce que les résultats montrent
- Quels groupes diffèrent sur la mesure des barres larges (lettres, ANOVA puis LSD de Fisher).
- Dans chaque groupe, si les périodes diffèrent sur la seconde mesure (étoiles, Wilcoxon).
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- stats
- agricolae
- rstatix
- ggplot2
aov(mesure large ~ groupe) + LSD.test(p.adj = "bonferroni") (ou HSD.test, duncan.test, kruskal) · par groupe : wilcox_test(mesure ~ période) · adjust_pvalue(holm) + add_significance → barres imbriquées + traits étoilés
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| aov | stats | ANOVA des barres larges |
| LSD.test, HSD.test, duncan.test | agricolae | lettres |
| wilcox_test, adjust_pvalue | rstatix | périodes |
| ggplot | ggplot2 | la figure |
Ce que fait le script, dans l’ordre
- Calcule moyenne et écart type de la mesure large par groupe.
- ANOVA à un facteur puis test post-hoc d’agricolae, lettres « a » à la plus haute moyenne.
- Dans chaque groupe, compare les périodes par rstatix::wilcox_test, p ajustées ensemble (Holm).
- Dessine barres et moustaches, place traits et lettres sans chevauchement.
Formules principales
Plus petite différence significative (LSD de Fisher)
LSD = t₍α/2, N−k₎ · √(2·CM_résiduel / n)
Deux moyennes qui s’écartent de plus que la LSD diffèrent ; la correction de Bonferroni relève le seuil.
Wilcoxon-Mann-Whitney
W = Σ rangs du groupe 1 − n₁(n₁ + 1)/2
Compte combien de fois une valeur du groupe 1 dépasse une valeur du groupe 2. Sans hypothèse de normalité ; p < α, une distribution est décalée par rapport à l’autre. r rang-bisérial = 2W/(n₁n₂) − 1.
À citer
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99-114. doi:10.2307/3001913 (nouvel onglet)
- Duncan, D. B. (1955). Multiple range and multiple F tests. Biometrics, 11(1), 1-42. doi:10.2307/3001478 (nouvel onglet)
- Kruskal, W. H. & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583-621. doi:10.1080/01621459.1952.10483441 (nouvel onglet)
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80-83. doi:10.2307/3001968 (nouvel onglet)
- Mann, H. B. & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50-60. doi:10.1214/aoms/1177730491 (nouvel onglet)
- Welch, B. L. (1947). The generalization of « Student’s » problem when several different population variances are involved. Biometrika, 34(1-2), 28-35. doi:10.1093/biomet/34.1-2.28 (nouvel onglet)
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65-70. PubMed (nouvel onglet)
- Benjamini, Y. & Hochberg, Y. (1995). Controlling the false discovery rate: a practical and powerful approach to multiple testing. Journal of the Royal Statistical Society, Series B, 57(1), 289-300. doi:10.1111/j.2517-6161.1995.tb02031.x (nouvel onglet)
5.Données d’entrée
Une ligne par observation : une colonne de groupe, une colonne de période (2 à 4) et deux colonnes numériques distinctes.
Ce que la figure demande
- Une ligne par observation : une colonne de groupe (2 à 12), une colonne de période (2 à 4) et deux colonnes numériques, aucune moyenne négative
- Les autres colonnes (identifiant…) peuvent rester dans le fichier, elles ne sont pas lues
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Fanes et gousses de huit variétés de niébé
Rôles : Les Fanes de 160 plantes (20 par Variété) en barres larges, avec les lettres du LSD de Fisher ; dedans, les Gousses de chaque Récolte comparées par Wilcoxon ; les colonnes Plante (identifiant) et Type ne sont pas lues.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (niebe_fanes_gousses.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Barres imbriquées : lettres et étoiles » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.