Réseaux de co-occurrence par milieu
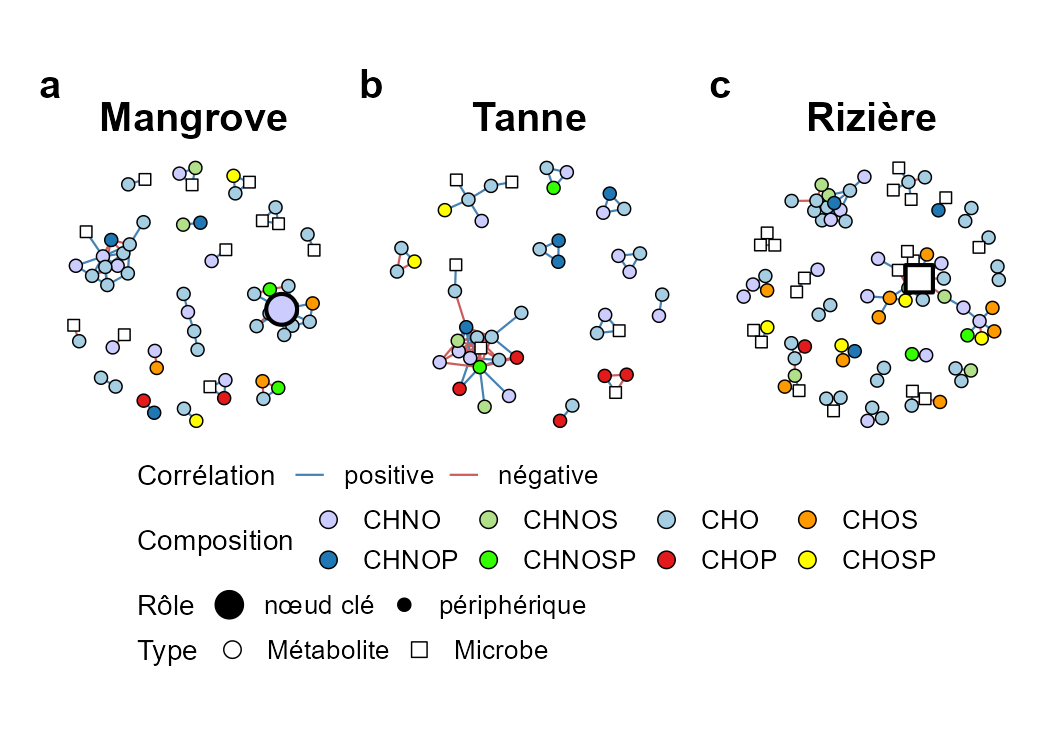
Un réseau de co-occurrence par milieu, côte à côte, comme l’article (Nature Microbiology, 2024) : un nœud par microbe ou métabolite, un lien quand deux éléments varient ensemble (bleu) ou en sens contraires (rouge) au-delà d’un seuil, les métabolites en ronds colorés par leur composition élémentaire, les microbes en carrés, les nœuds clés (hubs et connecteurs, selon Zi et Pi) en grand.
Liens entre variables · Réseaux de co-occurrence par milieu · 5 crédits
Lancer cette figure (nouvel onglet)1.Définition
La figure
Un réseau de co-occurrence par milieu, côte à côte, comme l’article (Nature Microbiology, 2024) : un nœud par microbe ou métabolite, un lien quand deux éléments varient ensemble (bleu) ou en sens contraires (rouge) au-delà d’un seuil, les métabolites en ronds colorés par leur composition élémentaire, les microbes en carrés, les nœuds clés (hubs et connecteurs, selon Zi et Pi) en grand.
L’analyse statistique : Réseaux de co-occurrence par milieu
Un réseau de co-occurrence par milieu : deux éléments (microbes, molécules) sont reliés quand leurs abondances varient ensemble au-delà d’un seuil trouvé par la théorie des matrices aléatoires, comme MENAP.
2.Lancer l’analyse
Les étapes de « Nouvelle analyse », dans l’ordre : ce que chacune demande, et pourquoi.
Étape 1 : Choisir la figure
Ouvrez « Nouvelle analyse », famille « Relations » du ruban, puis cette figure.
Pourquoi : Chaque figure a ses propres options : la choisir d’abord fixe celles qui la font et masque celles des autres figures.
Étape 2 : Importer les données
Un fichier CSV, TXT ou Excel (.xlsx, .xls) de 50 Mo et 200 000 lignes au plus, ou « Utiliser le jeu d’exemple » : sur lui, la figure est gratuite.
Pourquoi : Le fichier est lu dans votre navigateur : seules les colonnes que vous choisirez partiront au calcul, et elles sont effacées du serveur au bout de 24 h.
Étape 3 : Ajouter les fichiers complémentaires
Cette figure lit, en plus du tableau principal :
- Groupes des échantillons : Une ligne par échantillon : son nom, écrit comme en tête des colonnes du fichier principal, et son groupe (traitement, stade, site…).
Pourquoi : Les identifiants doivent s’écrire exactement comme dans le fichier principal : c’est par eux que les fichiers se rejoignent.
Étape 4 : Vérifier le type des colonnes
Chaque colonne est reconnue numérique, catégorielle ou texte ; un clic sur son type le change.
Pourquoi : Le rôle qu’une colonne peut prendre dépend de son type : un facteur codé 1, 2, 3 doit passer en catégorielle pour être lu comme des groupes.
Étape 5 : Attribuer les rôles
Dites ce que représente chaque colonne, et ce que la figure vous demande :
- Une ligne par élément (microbe, métabolite, gène…) : son identifiant et une colonne d’abondance par échantillon
- Facultatif : une colonne du type de chaque élément (sa forme) et une de sa classe (sa couleur)
- Un fichier « Groupes des échantillons » : le nom de chaque échantillon et son milieu, une vingtaine d’échantillons ou plus par milieu
Pourquoi : Les rôles disent au moteur ce qui est mesuré, ce qui l’explique et ce qui groupe les observations : la même table répond à des questions différentes selon eux.
Étape 6 : Régler les options
Les options qui font cette figure sont déjà fixées. Restent :
- Seuil : théorie des matrices aléatoires ou fixe : Le seuil RMT (défaut) sépare la structure du bruit d’après vos données ; un seuil fixe pour comparer des études.
- Transformation : CLR, log ou aucune : CLR (défaut) pour des données de composition (abondances relatives), qui créent sinon de fausses corrélations négatives.
- Prévalence minimale (50 %) : Écarte les éléments trop rares, dont les corrélations ne reposent que sur quelques échantillons.
Pourquoi : Les valeurs par défaut sont les conventions des revues ; ne les changez que pour une raison que vous sauriez écrire dans votre section Méthodes.
Étape 7 : Lancer le calcul
Gratuit et complet sur le jeu d’exemple. Sur vos données : 5 crédits débités au lancement ; sans assez de crédits, un aperçu flouté, à débloquer pour 5 crédits.
Pourquoi : Le calcul est fait par R sur nos serveurs, et vous suivez ses étapes. S’il échoue, les crédits sont rendus.
Étape 8 : Lire les résultats
Les tableaux, l’interprétation en français ou en anglais et le paragraphe « Méthodes » prêt pour votre manuscrit.
Pourquoi : Chaque chiffre vient de R, et chaque phrase est un modèle rempli avec eux, jamais un texte inventé : vérifiez-les avec les tableaux.
Étape 9 : Télécharger la figure
PNG 300 DPI, PDF, EPS ou SVG, à 89 ou 183 mm ; les textes se modifient dans l’éditeur de figure.
Pourquoi : 89 mm est la largeur d’une colonne de revue, 183 mm celle d’une page : la figure est mise en page pour chacune, rien ne s’y chevauche.
3.Pourquoi et quand l’utiliser
Quand l’utiliser
Pour voir quels microbes et quelles molécules vont ensemble dans chaque milieu (habitat, traitement, stade), comment ces réseaux changent d’un milieu à l’autre, et quels éléments en sont les clés de voûte.
Exemple de question : Comment les bactéries et les molécules de la matière organique dissoute se répondent-elles dans la mangrove, le tanne et la rizière, le long du gradient de salinité ?
Ce que les résultats montrent
- La structure de chaque réseau : modules, liens positifs et négatifs, densité.
- Les nœuds clés (hubs et connecteurs, selon Zi et Pi) et comment le réseau change d’un milieu à l’autre.
4.Méthode et packages R
Ce que le moteur R exécute pour cette figure : les packages, les fonctions principales, les étapes du calcul et les formules.
Packages R
- RMThreshold
- igraph
- ggraph
- patchwork
par milieu : clr(x) · cor(t(x)) · |r| ≥ seuil (rm.get.threshold) et p.adjust("BH") · cluster_fast_greedy · Zi, Pi
Fonctions principales
| Fonction | Package | Rôle |
|---|---|---|
| rm.get.threshold | RMThreshold | seuil par matrices aléatoires |
| cluster_fast_greedy, modularity, transitivity | igraph | modules et propriétés |
| ggraph, geom_edge_link0 | ggraph | dessin des réseaux |
| wrap_plots | patchwork | panneaux côte à côte |
Ce que fait le script, dans l’ordre
- Dans chaque milieu, garde les éléments assez fréquents et les transforme (CLR).
- Corrèle chaque paire (Pearson ou Spearman), p ajustées BH.
- Trouve le seuil par RMThreshold, puis garde les liens |r| ≥ seuil et p < α.
- Modules par cluster_fast_greedy, rôles par Zi et Pi, propriétés du réseau (igraph).
- Dessine un panneau par milieu (ggraph), assemblés par patchwork.
Formules principales
Transformation CLR
clr(xᵢ) = ln xᵢ − (1/D) Σ ln xⱼ
Le log de chaque abondance moins la moyenne des logs de l’échantillon (Aitchison 1982).
Modularité
Q = Σ_s (l_s / L − (d_s / 2L)²)
l_s liens dans le module s, d_s somme de ses degrés, L liens en tout. Q > 0,4 : réseau nettement modulaire.
Rôles des nœuds
Zᵢ = (k_is − k̄_s) / σ_s ; Pᵢ = 1 − Σ_s (k_is / kᵢ)²
Zᵢ > 2,5 hub de module ; Pᵢ > 0,62 connecteur entre modules (Olesen et al. 2007).
À citer
- Deng, Y., Jiang, Y.-H., Yang, Y., He, Z., Luo, F. & Zhou, J. (2012). Molecular ecological network analyses. BMC Bioinformatics, 13, 113. doi:10.1186/1471-2105-13-113 (nouvel onglet)
- Luo, F., Yang, Y., Zhong, J., Gao, H., Khan, L., Thompson, D. K. & Zhou, J. (2007). Constructing gene co-expression networks and predicting functions of unknown genes by random matrix theory. BMC Bioinformatics, 8, 299. doi:10.1186/1471-2105-8-299 (nouvel onglet)
- Aitchison, J. (1982). The statistical analysis of compositional data. Journal of the Royal Statistical Society, Series B, 44(2), 139-160. doi:10.1111/j.2517-6161.1982.tb01195.x (nouvel onglet)
- Olesen, J. M., Bascompte, J., Dupont, Y. L. & Jordano, P. (2007). The modularity of pollination networks. Proceedings of the National Academy of Sciences, 104(50), 19891-19896. doi:10.1073/pnas.0706375104 (nouvel onglet)
- Guimerà, R. & Nunes Amaral, L. A. (2005). Functional cartography of complex metabolic networks. Nature, 433(7028), 895-900. doi:10.1038/nature03288 (nouvel onglet)
- Freire-Zapata, V., Holland-Moritz, H., Cronin, D. R. et al. (2024). Microbiome-metabolite linkages drive greenhouse gas dynamics over a permafrost thaw gradient. Nature Microbiology, 9(11), 2892-2908. doi:10.1038/s41564-024-01800-z (nouvel onglet)
5.Données d’entrée
Une ligne par élément : son identifiant, une colonne d’abondance par échantillon, en option son type et sa classe ; le fichier des groupes donne le milieu de chaque échantillon.
Ce que la figure demande
- Une ligne par élément (microbe, métabolite, gène…) : son identifiant et une colonne d’abondance par échantillon
- Facultatif : une colonne du type de chaque élément (sa forme) et une de sa classe (sa couleur)
- Un fichier « Groupes des échantillons » : le nom de chaque échantillon et son milieu, une vingtaine d’échantillons ou plus par milieu
Format : CSV, TXT ou Excel, une ligne d’en-tête avec le nom des colonnes. La virgule ou le point décimal, le séparateur et l’encodage sont reconnus seuls ; une case vide est une valeur manquante.
Le jeu d’exemple : Microbes et matière organique des sédiments de Casamance
Rôles : 220 molécules (FT-ICR MS, leur composition élémentaire CHO, CHNO, CHOS…) et 80 ASV bactériens dans 90 carottes de sédiment ; le milieu de chaque carotte (Mangrove, Tanne, Rizière, 30 chacun) dans un second fichier.
6.Prix
5crédits
par lancement sur vos données. Chaque figure coûte 5 crédits, quelle qu’elle soit : la figure, ses tableaux, son interprétation et ses téléchargements sont compris.
| Pack | Prix du pack | Cette figure |
|---|---|---|
| Starter (50 crédits) | 500 FCFA | 50 FCFA |
| Standard (250 crédits) | 2 000 FCFA | 40 FCFA |
| Pro (700 crédits) | 5 000 FCFA | 36 FCFA |
- Gratuite sur son jeu d’exemple (reseaux_casamance_abondances.csv), résultats complets : pour la découvrir avant d’importer vos données.
- Sur vos données sans assez de crédits, elle se lance quand même en aperçu flouté, débloqué ensuite pour 5 crédits sans relancer le calcul.
- Si le calcul échoue, les crédits sont rendus.
- Paiement par mobile money ; voir les packs.
Lancer « Réseaux de co-occurrence par milieu » sur vos données
Ou ouvrez-la gratuitement avec son jeu d’exemple pour voir chaque étape et des résultats complets avant d’importer votre fichier.